Yapay zeka modeli eğitmek için hangi GPU gerekir?
Yapay zeka modeli eğitmek için gereken GPU'yu önce bellek belirler: AdamW ve karma hassasiyetle (mixed precision) tam eğitim parametre başına yaklaşık 16 bayt ister, bu yüzden 8B bir dil modeli 131,6 GB tutar ve en az iki karta bölünür. Görüntü ve ses gibi derin öğrenme modellerinin çoğu tek karta sığar. Bu kartları İstanbul'daki kendi tesisimizde paylaşımsız ve aylık kiralıyoruz.
Eğitimi üç şey sınırlar: bellek, tensör hesap gücü ve çok GPU'da kartlar arası bağlantı; model tek karta sığıyorsa hızı hesap gücü ve veri hattı belirler.
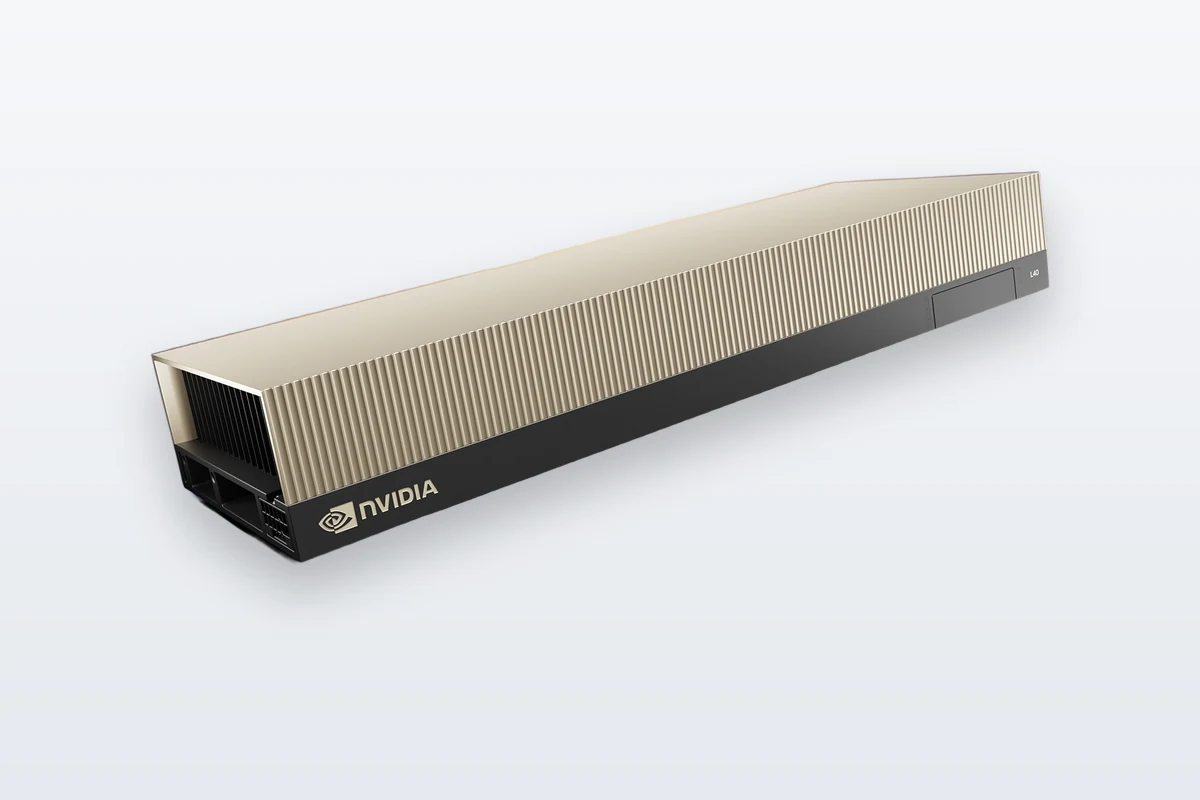
- Görüntü ve ses modelleri, deneme ortamları: 48 GB'lık L40S, aylık $900.
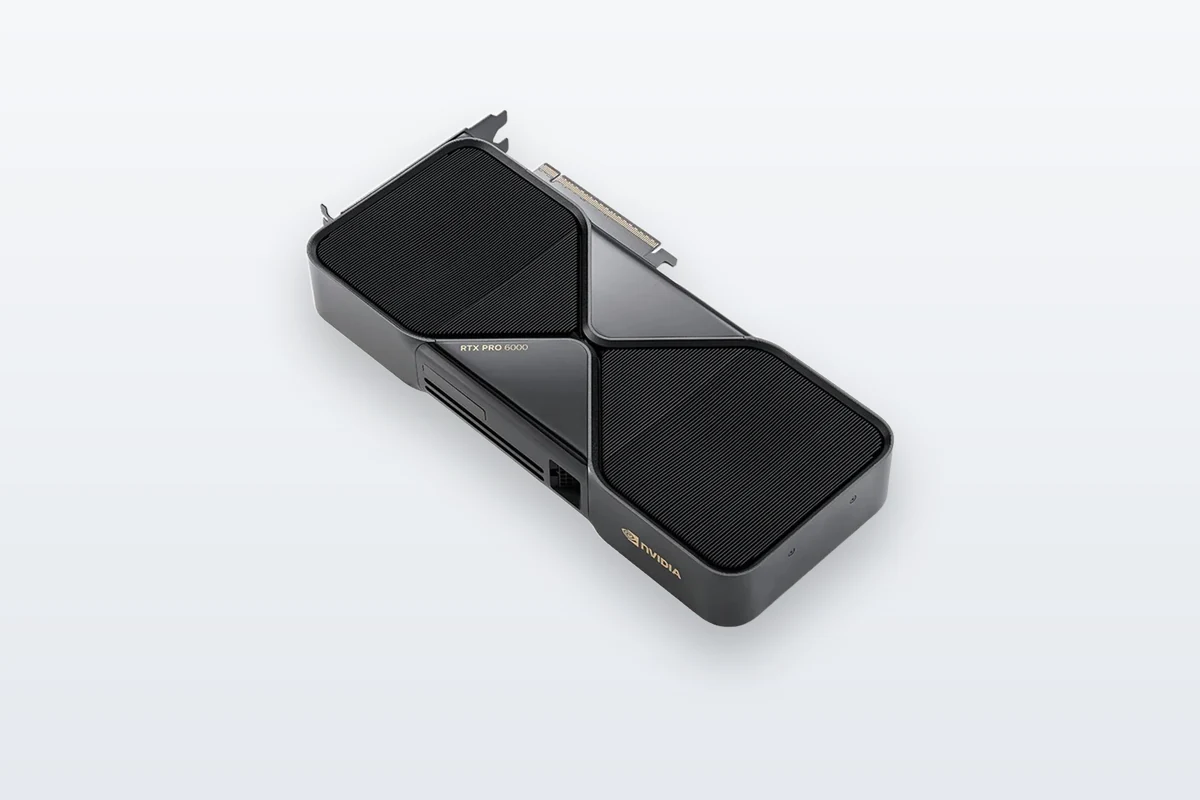
- Tek kartta büyük batch ya da yaklaşık 5 milyar parametreye kadar tam eğitim: 96 GB'lık RTX PRO 6000, aylık $1.600.
- 8–32B modellerin tam eğitimi, sürekli ön eğitim, 1B ölçeğinde sıfırdan ön eğitim: 2–8 × H100 (GPU başına aylık $2.500) ya da belleği büyük olduğu için bazı işleri daha az kartla yapan H200 (GPU başına aylık $3.000).
- GPU sunucu fiyatları GPU başına, aylık, dolar bazlı ve KDV hariçtir; fatura, düzenlendiği günkü TCMB döviz satış kuruyla Türk lirası olarak kesilir. Tek siparişte en fazla 8 GPU kiralanabilir; GPU'lar ve sunucu kaynakları yalnızca size ayrılır.
Model eğitimi için kaç GB GPU belleği (VRAM) gerekir?
Tam eğitimde gereken GPU belleği (VRAM), parametre başına yaklaşık 16 baytlık model durumu ile batch boyutu ve dizi uzunluğuyla büyüyen aktivasyonların toplamıdır: Llama 3.1 8B için 131,6 GB, Qwen3 14B için 240,7 GB.
ZeRO makalesindeki hesaba göre bu 16 baytın 2'si BF16 ağırlık, 2'si gradyan, 12'si AdamW durumudur (FP32 ana ağırlık kopyası, momentum ve varyans). Gradient checkpointing, ara sonuçları saklamak yerine geri yayılımda yeniden hesaplayarak aktivasyon belleğini büyük ölçüde azaltır.
Sitemizin VRAM hesaplayıcısına göre dil modellerinde tam eğitim (2.048 token, batch 1, gradient checkpointing açık; kartın belleğinin %92'si kullanılabilir; çok GPU'lu kurulumlar 2, 4 ya da 8 kart olarak hesaplanır):
Dil modeli dışındaki modellerde parametre sayısı küçüktür; belleği daha çok batch boyutu ve girdi çözünürlüğü belirler. 16 bayt kuralıyla model durumu ResNet-50 (25,6 milyon parametre) için ~0,4 GB, ViT-L/16 (304,3 milyon) için ~4,9 GB, Whisper large-v3 (1,55 milyar) için ~24,8 GB'tır. Bu modellerin model durumu tek karta rahatça sığar; kartı batch boyutuna ve hız ihtiyacına göre seçersiniz. Ayrıntılar görüntü işleme ve ses tanıma sayfalarımızda.
Hangi kart ne kadar hızlı eğitir?
Hesap yoğun eğitimde hızı kartın BF16 ve FP8 tensör gücü belirler: kağıt üzerinde H100 ve H200, L40S'in yaklaşık 2–2,7 katı hızdadır.
Değerler seyrekliksizdir; aralıklar kartın sürümüne göre değişir. RTX 5090 değerleri, NVIDIA'nın RTX Blackwell mimari belgesindeki FP32 biriktirmeli (accumulate) tensör hızlarıdır; NVIDIA'nın bu kart için yayımladığı teknik özelliklerde ECC bellek yer almaz. RTX PRO 6000 için NVIDIA'nın sayfalarında seyrekliksiz olduğu belirtilmiş bir BF16 değeri yok; kartları kendi işinizde karşılaştırmak için PyTorch kurulum rehberimizdeki kısa matris çarpımı testini kullanın.
Kaba süre hesabı için dil modellerinde toplam işlem ≈ 6 × parametre × token kuralı kullanılır (Kaplan ve ark., 2020). Meta, Llama 3 eğitiminde H100 başına 380–430 TFLOPS gerçekleşen BF16 hız raporladı; bu, büyük ve çok iyi optimize edilmiş bir kümenin değeridir. GPU başına 400 TFLOPS varsayımıyla 8B bir modeli 10 milyar Türkçe tokenla sürekli ön eğitimden (continued pretraining) geçirmek 4,8 × 10²⁰ işlem eder: 8 H100'de teorik olarak yaklaşık 42 saat. Sıfırdan ön eğitim tablosunu LLM eğitimi için GPU seçimi rehberimizde verdik.
Ne zaman tek RTX PRO 6000, ne zaman 8 × H100 ya da H200?
Model ve optimizer durumu tek karta sığıyorsa ve eğitim saatler ya da birkaç gün sürüyorsa tek kart yeter; sığmıyorsa ya da süre haftalara uzuyorsa çok GPU'lu H100 veya H200 gerekir.
5 milyar parametre sınırı kaba bir hesaptır: RTX PRO 6000'in kullanılabilir 88,3 GB'ı, 16 bayt kuralıyla bu boyutta bir modele ve kısa dizilerin aktivasyonlarına yeter. 32 GB'a sığan küçük görüntü modellerinde RTX 5090 da bir seçenektir; ancak NVIDIA bu kart için ECC bellek belirtmez ve BF16 tensör hızı L40S'in altındadır.
Çok GPU'lu eğitim sunucusunda DDP mi, FSDP2 mi kullanılır?
Model tek karta sığıyorsa DDP, sığmıyorsa FSDP2 ya da DeepSpeed ZeRO-3 kullanın; NVLink en çok tensor paralellikte ve büyük modellerin FSDP ile eğitiminde fark yaratır.
- DDP ve torchrun: Her GPU modelin tam kopyasını tutar, her adımda gradyanların ortalaması alınır. 24 Ekim 2026 itibarıyla güncel sürüm PyTorch 2.14.1'dir (30 Eylül 2026).
- FSDP2 (
fully_shard): Parametre, gradyan ve optimizer durumunu GPU'lara böler. PyTorch belgelerine göre eski FSDP1 kullanımdan kalktı.
- DeepSpeed (0.19.8): ZeRO'nun üç aşaması, işlemci belleğine ya da NVMe'ye boşaltma (offload).
- torchtitan (0.3.0) ve NVIDIA Megatron Core: Büyük dil modellerinin ön eğitimi için veri, tensor, pipeline ve context paralelliğini birleştiren çerçeveler. PyTorch ekibi dil modeli eğitimini torchtitan'da topluyor.
PCIe 4.0 x16 iki yönde toplam 64 GB/s, PCIe 5.0 x16 128 GB/s taşır; NVLink ise GPU başına H100'de sürüme göre 600–900 GB/s, H200'de 900 GB/s'dir. RTX PRO 6000, RTX 5090 ve L40S'te NVLink yoktur: bu kartlarda küçük modellerle ve LoRA ile DDP iyi çalışır, büyük modelde FSDP ise iletişim yüzünden yavaşlayabilir. NVLink'li bir topoloji vaat etmiyoruz; ihtiyacınızı sipariş formunda belirtin ve teslimden sonra nvidia-smi topo -m ile kontrol edin. Kod örnekleri multi-GPU eğitim rehberimizde, bağlantı türleri NVLink rehberimizde.
FP8 ile eğitim hangi kartlarda çalışır?
FP8 ile eğitim RTX 3090 ve RTX A5000 dışındaki kartlarımızın hepsinde (SM 8.9 ve üzeri) çalışır; MXFP8 ve NVFP4 ile eğitim ise yalnızca B200 sınıfı kartlarda desteklenir.
NVIDIA Transformer Engine belgelerine göre (sürüm 2.20, Ekim 2026):
- Tensör başına ölçeklemeli FP8 (delayed ve current scaling): hesaplama yeteneği (compute capability) 8.9 ve üzeri; yani L40S, H100, H200, RTX 5090, RTX PRO 5000 ve RTX PRO 6000.
- Blok ölçeklemeli FP8: Hopper (H100, H200).
- MXFP8 ve NVFP4 ile eğitim: yalnızca SM 10.0 ve 10.3 (B200 sınıfı). RTX PRO 6000 ve RTX 5090 SM 12.0'dır; bu kartlarda FP4 çıkarım (inference) içindir.
PyTorch tarafında torchao'nun float8 eğitim akışı da benzer bir yol sunar; belgelerine göre 8 H100'de Llama 3 8B eğitiminde yaklaşık %25 hızlanma ölçülmüş. Kazanç modele bağlıdır; kayıp eğrisini bir BF16 koşusuyla karşılaştırın. Transformer Engine belgesindeki en küçük örnek:
import torch
import transformer_engine.pytorch as te
from transformer_engine.common.recipe import Float8CurrentScaling, Format

recipe = Float8CurrentScaling(fp8_format=Format.HYBRID)  # ileri geçiş E4M3, geri geçiş E5M2
layer = te.Linear(1024, 1024, params_dtype=torch.bfloat16)
inp = torch.randn(32, 128, 1024, dtype=torch.bfloat16, device="cuda")

with te.autocast(enabled=True, recipe=recipe):
    out = layer(inp)
    loss = out.sum()

loss.backward()
Veri hattı, checkpoint ve disk nasıl planlanır?
GPU'nun veri beklememesi ve uzun bir eğitimin kesintiden sonra kaldığı yerden sürmesi için ikisini baştan planlayın.
- Veri hattı: Veri setini sunucunun yerel NVMe diskine alın; tokenizasyon ve yeniden boyutlandırma gibi ön işlemeyi eğitimden önce bir kez yapın. Görüntü ya da video çözmede işlemci yetişmiyorsa NVIDIA DALI çözme ve veri artırmayı GPU'ya taşır. DataLoader ayarlarını CUDA optimizasyonu rehberimizde anlattık.
- Checkpoint boyutu: Optimizer durumuyla birlikte parametre başına yaklaşık 12 bayt (FP32 ana ağırlık ve iki AdamW momenti) yazılır; 8B bir model için tek checkpoint ~96 GB eder. Son birkaç checkpoint'i saklayın, önemlilerini sunucu dışına kopyalayın.
- Dağıtık checkpoint: PyTorch'un
torch.distributed.checkpoint modülü (DCP) her sürecin kendi parçasını paralel yazmasını ve checkpoint'in farklı sayıda GPU'yla yeniden yüklenmesini sağlar.
- Kesintiye hazırlık: Meta, 16 bine varan H100'le yürüttüğü Llama 3 ön eğitiminin 54 günlük bir döneminde 466 iş kesintisi yaşadığını, beklenmeyen kesintilerin yaklaşık %78'inin donanımdan kaynaklandığını raporladı. Kesinti sıklığı donanım sayısıyla artar ve 8 GPU'lu tek bir sunucuda çok daha seyrektir; yine de günlerce süren bir eğitimi düzenli checkpoint almadan çalıştırmayın.
Sunucu kaynakları GPU belleğine göre baştan bellidir: Her 4 GB GPU belleği için 1 CPU çekirdeği ve GPU belleğinin 1,5 katı RAM verilir; 1 TB SSD ve size özel bir IP adresi her siparişe dahildir. Veri seti boyutunu ve checkpoint ihtiyacınızı sipariş formuna yazın.
Model eğitimi için aylık sunucu ne zaman mantıklı?
Ekip sürekli deney koşuyorsa ve veri Türkiye'de kalmalıysa aylık sunucu mantıklıdır; tek seferlik kısa bir eğitim için değildir.
Mantıklı olduğu durumlar:
- Hiperparametre taramaları ve ablasyon deneyleriyle kart ayın büyük bölümünde doluysa: sabit fiyatta her ek koşunun ek maliyeti yoktur.
- Eğitim verisi kişisel veri, sağlık verisi ya da müşteri kaydı içeriyorsa: veriler İstanbul'daki kendi tesisimizde, Türkiye'de kalır ve GPU'lar başka müşterilerle paylaşılmaz. Uyum değerlendirmesi kendi veri işleme süreçlerinize bağlıdır; ayrıntılar KVKK rehberimizde. Bu bilgi hukuki tavsiye değildir.
- Öngörülebilir maliyet ve Türk lirası fatura istiyorsanız.
Mantıklı olmadığı durumlar:
- En kısa kiralama süresi 1 aydır; birkaç günlük tek bir eğitim koşacaksanız saatlik bulut GPU daha ucuz olabilir. Aylık fiyatı sağlayıcının saatlik fiyatına bölün: çıkan sayı, aylık sunucunun öne geçtiği kullanım saatidir. Aylık fiyatımızın saatlik karşılığı (730 saat) H100 için $3,42, H200 için $4,11.
- 8 GPU'dan büyük bir küme gerekiyorsa, örneğin 10B üzeri modellerin sıfırdan ön eğitiminde: tek siparişte en fazla 8 GPU kiralanabilir.
- Genel amaçlı metin, görsel ya da ses işlerinde en güçlü kapalı modellerin API'leri ya da açık bir modelin ince ayarı, sıfırdan eğitimden daha iyi sonuç verebilir; önce bunları deneyin.
Özet
- Tam eğitim parametre başına ~16 bayt ister: 8B bir model 131,6 GB ile 2 kart, 14B 240,7 GB ile 2 × H200 ya da 4 × H100 gerektirir.
- Görüntü ve ses modelleri genellikle tek karta sığar; kart seçimini hız ve batch boyutu belirler.
- FP8 eğitimi RTX 3090 ve RTX A5000 dışındaki kartlarımızın hepsinde (SM 8.9 ve üzeri) çalışır; MXFP8 ve NVFP4 eğitimi yalnızca B200 sınıfı kartlarda.
- Model sığıyorsa DDP, sığmıyorsa FSDP2 ya da ZeRO-3; NVLink ihtiyacınızı sipariş formunda belirtin.
- Aylık sunucu sürekli deney ve verinin Türkiye'de kalması için mantıklıdır; tek seferlik kısa koşularda saatlik bulut daha ucuz olabilir.
Kaynaklar
Yazılım sürümleri (PyTorch 2.14.1, Transformer Engine 2.20, DeepSpeed 0.19.8, torchtitan 0.3.0) 24 Ekim 2026 tarihine göredir.