Video işleme nedir?
Video işleme; videoyu çözme, ölçekleme, başka kodek ve çözünürlüklere dönüştürme (transcoding), canlı yayını kodlama, otomatik altyazı çıkarma, yapay zeka ile netleştirme (upscale) ve video üretme işlerinin genel adıdır. GPU sunucuda kodlamayı NVENC, kod çözmeyi NVDEC donanım motorları yapar. Bu işler için Bağcılar, İstanbul'daki kendi tesisimizde size ayrılmış GPU sunucuları aylık kiralıyoruz; videolarınız Türkiye'de kalır.
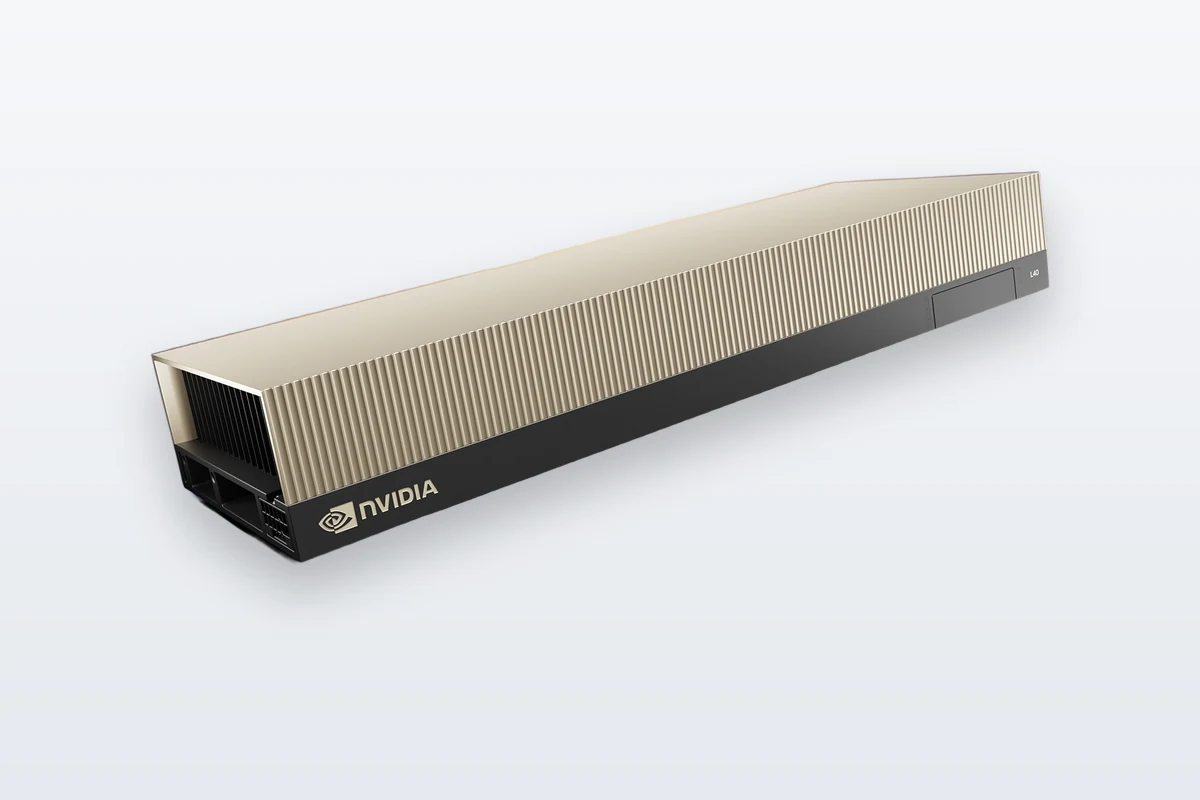
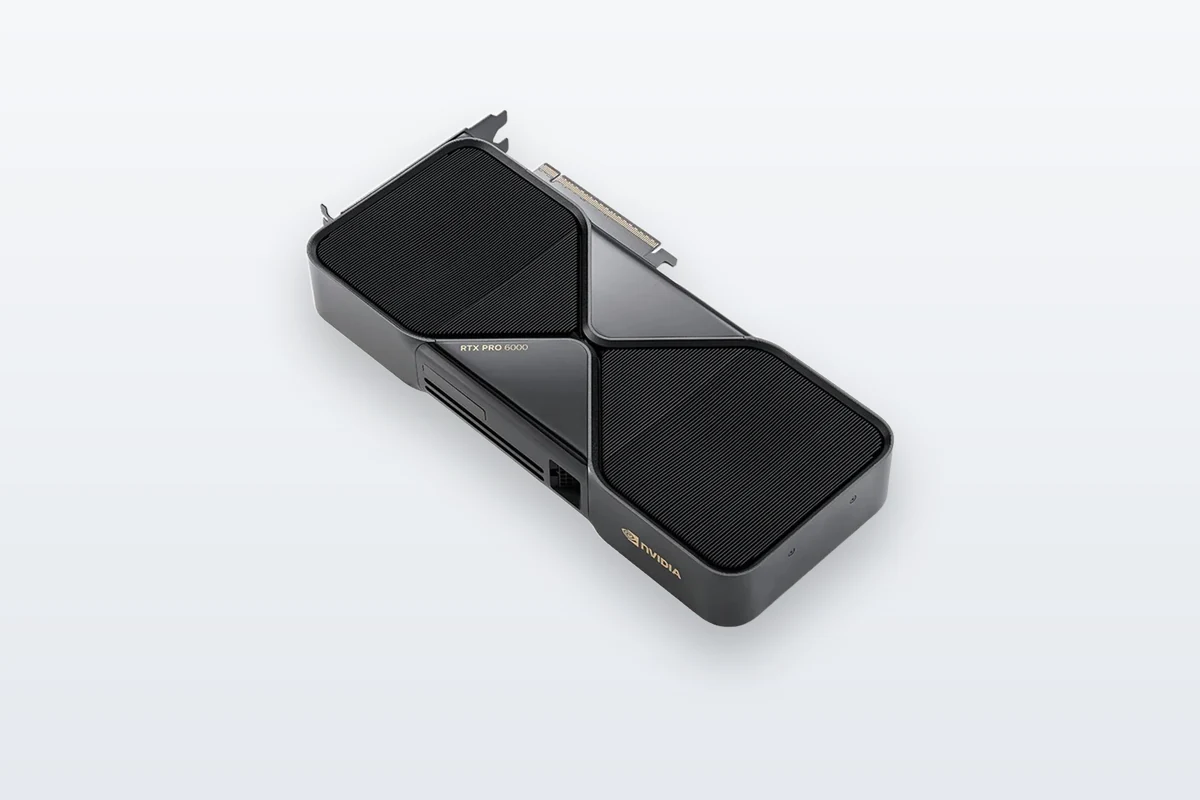
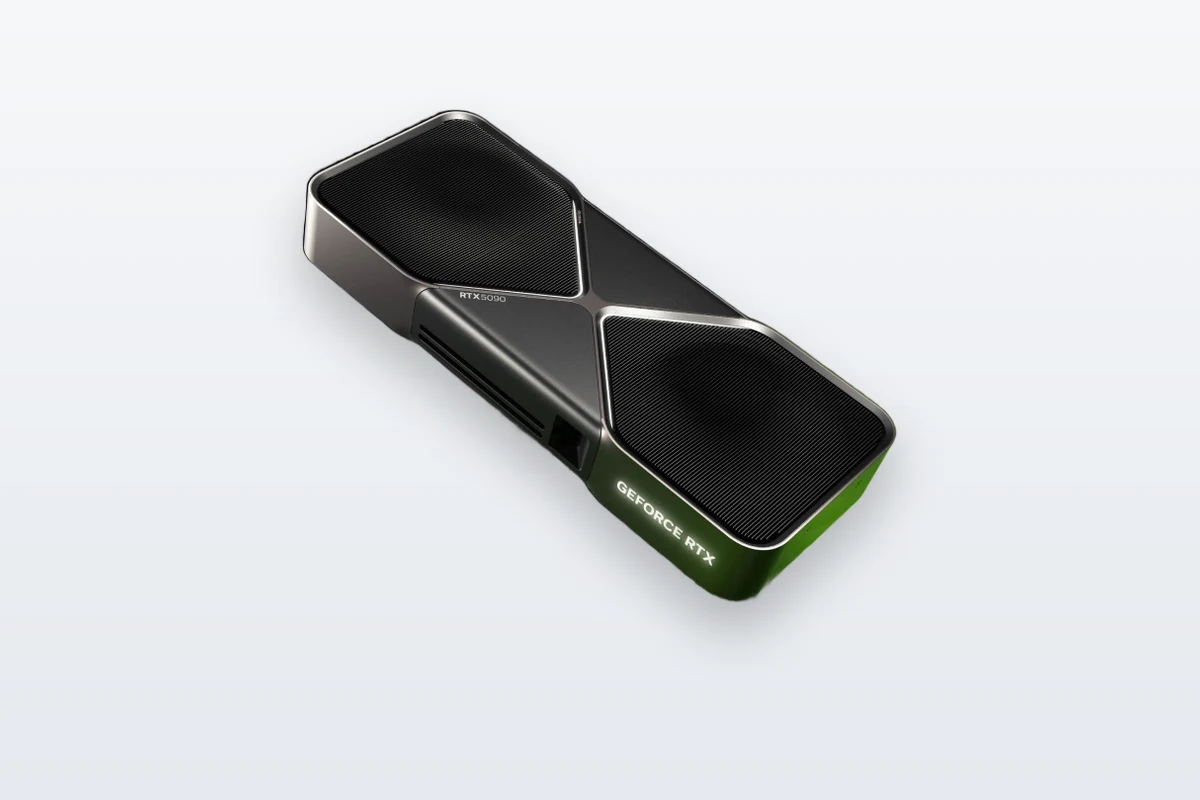
NVENC ve NVDEC, CUDA çekirdeklerinden ayrı donanım bloklarıdır; dönüştürme kapasitesini doğrudan motor sayısı belirler. Kiraladığımız kartlardan RTX PRO 6000'de 4, L40S, RTX PRO 5000 ve RTX 5090'da 3, RTX PRO 4000'de 2 NVENC bulunur; hepsi AV1 kodlar. H100 ve H200'de NVENC yoktur, bu yüzden video kodlama için uygun değildir. Çok sayıda akışı aynı anda kodlayan bir video platformu için oturum sınırı olmayan L40S (aylık $900), 4:2:2 yayın formatları ve üretken video için RTX PRO 6000 (aylık $1.600) uygundur (L40S ve RTX PRO 6000 karşılaştırması).
- Küçük ve orta ölçekli VOD hatları: RTX PRO 4000 (2 NVENC, 4:2:2, 145 W), aylık $450.
- Yoğun dönüştürme, aynı kartta altyazı ve yapay zeka filtreleri: L40S (3 NVENC, 48 GB).
- 4:2:2, 4K/8K ve üretken video: RTX PRO 6000 (4 NVENC, 96 GB).
- Bütçe öncelikli hızlı kodlama: RTX 5090 (3 NVENC, 32 GB), aylık $600; ancak sistem başına en fazla 12 eşzamanlı kodlama oturumu açılır.
- Yapay zeka ile video netleştirme (upscale): Real-ESRGAN ve FP8 dosyalarla SeedVR2 için RTX PRO 4000 yeterlidir; 16-bit dosyalar için RTX 5090, L40S ya da RTX PRO 6000.
Fiyatlar GPU başına, aylık, ABD doları cinsinden ve KDV hariçtir; fatura, fatura tarihindeki TCMB döviz satış kuruyla Türk lirası olarak kesilir ve yıllık kiralamada %20 indirim uygulanır.
Video işleme sunucusu için hangi GPU (ekran kartı) seçilmeli?
Dönüştürmede NVENC sayısı ve oturum sınırı, üretken video ve netleştirmede (upscale) ise GPU belleği belirleyicidir.
H100 ve H200 videoyu çözebilir (7'şer NVDEC) ama kodlayamaz; Hopper'ın NVDEC'i AV1 de çözmez. Üretken video modellerini çok GPU'da eğitmek için anlamlı olabilirler, ancak çıktının kodlanması işlemciye kalır (RTX PRO 6000 ve H100 karşılaştırması). Kamera akışlarında video analizi ve nesne tespiti için görüntü işleme sayfamıza bakın.
Kiraladığımız kartlarda NVENC, NVDEC ve oturum sınırı
NVIDIA'nın destek matrisine göre (Ekim 2026) motor sayıları ve oturum sınırları şöyledir:
RTX 5090'daki 12 oturum sınırı sistem başınadır: 8 × RTX 5090'lık bir sunucuda da toplam 12 kodlama oturumu açılır; profesyonel kartlarda yapay bir sınır yoktur, kapasiteyi donanım ve bellek belirler. NVDEC; H.264, HEVC, VP9, AV1, MPEG-2 ve VC-1 kaynaklarını çözer, ProRes ve DNxHR ise işlemcide çözülür ve yine NVENC'te kodlanabilir.
Bir transcoding sunucusu aynı anda kaç akış kodlar?
Teorik üst sınır "motor başına hız × motor sayısı ÷ akış başına kare hızı"dır; gerçek değeri kendi içeriğinizle ölçün. NVIDIA'nın tek bir NVENC motoru için yayımladığı referans hız, 1080p HEVC'de (8 bit, p5 preset, hq) Ada'da saniyede 411, Blackwell'de 521 karedir. NVIDIA bu değerleri RTX 4090 ve RTX 5070 Ti kartlarında, en yüksek video saat hızında ölçtü; performans video saat hızıyla orantılı değişir.
- ABR merdiveni: Her çözünürlük ayrı bir kodlama işidir ve FFmpeg'de ayrı bir NVENC oturumu açar; düşük çözünürlükler daha hızlı kodlanır.
- Canlı yayın: Her kanal, merdivendeki her çözünürlük için yayın boyunca açık kalan bir kodlama oturumu kullanır. 4 basamaklı bir merdivenle (1080p, 720p, 480p, 360p) RTX 5090'lı bir sunucuda kart sayısından bağımsız olarak en fazla 3 kanal kodlanır (12 oturum ÷ 4 basamak); L40S, RTX PRO 4000, RTX PRO 5000 ve RTX PRO 6000'de bu sınır yoktur, kanal sayısını motor hızı belirler. Gecikmeyi düşürmek için FFmpeg'de
-tune ll ya da -tune ull kullanılır.
- Tek akış ve ölçüm: Tek bir oturum bir NVENC motorunun hızını aşamaz; motorları paralel işlerle doldurun ve gerçek kapasiteyi kendi içeriğinizle,
nvidia-smi dmon -s u çıktısındaki enc sütununu izleyerek ölçün.
Transcoding hattı hangi yazılımlarla kurulur?
FFmpeg'de videoyu NVDEC ile çözüp (-hwaccel cuda -hwaccel_output_format cuda), scale_cuda ile ölçekleyip h264_nvenc, hevc_nvenc ya da av1_nvenc ile kodladığınızda kareler baştan sona GPU belleğinde kalır; GStreamer'ın nvcodec eklentisi de aynı motorları kullanır. Docker'da NVIDIA Container Toolkit varsayılan olarak yalnızca compute ve utility yeteneklerini açtığından konteyneri video yeteneğiyle de başlatın (Docker'da GPU kullanımı).
Komut örnekleri, p1–p7 preset farkları ve işlemci kodlayıcılarıyla kalite karşılaştırması için FFmpeg NVENC rehberimize bakın.
Whisper ile otomatik altyazı nasıl oluşturulur?
Whisper videodaki sesi yazıya döker ve altyazıyı doğrudan SRT ya da VTT dosyası olarak üretir; aynı kartta dönüştürmeyle birlikte çalışabilir.
- Bellek: faster-whisper, large sınıfı bir modeli (README'deki ölçümde large-v2) int8'de yaklaşık 2,9 GB, fp16'da 4,5 GB, fp16 ve 8'li batch ile 6,1 GB bellekle çalıştırır. Orijinal openai/whisper uygulamasının README'si large-v3 için yaklaşık 10 GB, turbo (large-v3-turbo) için yaklaşık 6 GB veriyor. Türkçe desteklenen diller arasındadır; kod ve ağırlıklar MIT lisanslıdır.
- Kullanım:
whisper video.mp4 --model turbo --language Turkish --output_format srt komutu videonun sesinden SRT dosyası üretir.
- Çeviri: turbo çeviri için eğitilmedi; large-v3 ise yalnızca İngilizceye çevirir. Altyazıyı başka dillere çevirmek için bir LLM kullanın.
- Toplu iş: faster-whisper (MIT), README'deki ölçümde 13 dakikalık bir kaydı large-v2 modeli ve
batch_size=8 ile 8 GB'lık bir RTX 3070 Ti'da 17 saniyede, yaklaşık 6 GB bellekle yazıya döküyor. Kendi kayıtlarınızla kısa bir deneme koşusu yapın.
Whisper için GPU seçimi, konuşmacı ayrımı ve hacme göre boyutlandırma için ses kaydını yazıya çevirme sayfamıza bakın.
Yapay zeka ile video netleştirme (upscale) ve üretim için hangi GPU gerekir?
Netleştirmede ve video üretiminde belirleyici olan NVENC değil GPU belleğidir: SeedVR2 ile difüzyon tabanlı netleştirme ComfyUI'de FP8 dosyalarla 12–16 GB, Wan 2.2 TI2V-5B ile video üretimi resmi betikle en az 24 GB ister; 14 milyar parametreli modeller için 48–96 GB düşünün. Netleştirilen ya da üretilen kareler aynı kartta NVENC ile kodlanabilir.
Değerler model sayfalarından alındı (Ekim 2026). Üretken video yavaştır: Wan 2.2 TI2V-5B, 5 saniyelik 720p bir videoyu tek bir tüketici kartında özel optimizasyon olmadan 9 dakikanın altında üretiyor (üreticinin ölçümü). Bellek yetmezse boşaltma (offload) yerine önce 8-bit dosyaları deneyin; boşaltma üretimi yavaşlatır. Model bazında VRAM tablosu ve lisansların ticari kullanım koşulları yapay zeka video üretimi rehberimizde; ürün görselleri için görsel üretimi hizmet sayfamıza bakın.
Toplu iş kuyruğu nasıl kurulur?
Her GPU'yu kapasitesine göre işçi (worker) süreçleriyle besleyen bir iş kuyruğu kurun.
- Kuyruk: Celery ya da RQ gibi Redis ile çalışan bir iş kuyruğu ya da veritabanında bir iş tablosu yeterlidir; her iş tek bir FFmpeg, Whisper ya da ComfyUI çağrısıdır.
- GPU seçimi: FFmpeg'de
-hwaccel_device 1 ikinci kartı seçer; diğer araçlarda CUDA_VISIBLE_DEVICES kullanın.
- İşçi sayısı: Kart başına en az NVENC sayısı kadar paralel kodlama çalıştırın, ölçüme göre artırın. RTX 5090'lı bir sunucuda bütün kartlar için toplam 12 oturumu aşmayın; fazlası açılmaz.
- Aynı kartta yapay zeka: NVENC ve NVDEC, CUDA çekirdeklerinden bağımsızdır; kodlama sürerken aynı kartta Whisper ya da netleştirme (upscale) modeli çalışabilir. Bellek paylaşımını planlayın.
- İşlemci ve disk: Ses kodlama, mux ve NVDEC'in çözemediği kaynaklar işlemcide çalışır; büyük arşivler hızlı ve geniş disk ister. Her 4 GB GPU belleği için 1 CPU çekirdeği ve GPU belleğinin 1,5 katı RAM verilir; 1 TB SSD ve size özel bir IP adresi her siparişe dahildir. İhtiyacınızı sipariş formunun mesaj alanına yazın.
Aylık video sunucusu mu, bulut transcoding servisi mi?
Her gün video işliyorsanız aylık sunucu mantıklıdır; ayda birkaç saatlik dönüştürme için değildir. Biz dakika başına ücretlendirilen, yönetilen bir transcoding API'si değil; FFmpeg'i ya da kendi hattınızı çalıştırdığınız, size ayrılmış bir GPU sunucusu kiralıyoruz.
- Mantıklı olduğu durumlar: Platformunuza her gün video yükleniyor ve dönüştürme hattı sürekli doluysa sabit aylık fiyat, akış başına maliyeti öngörülebilir kılar. Ham görüntüler ve müşteri videoları İstanbul'daki kendi tesisimizde, Türkiye'de kalır; yüzlerce GB'lık dosyaları yurt dışına yüklemezsiniz. Fatura Türk lirasıyla kesilir.
- Mantıklı olmadığı durumlar: Ayda birkaç saatlik dönüştürme için dakika başına ücretlendiren bulut dönüştürme hizmetleri ya da mevcut işlemciniz daha ekonomik olabilir; birkaç günlük üretken video denemesinde saatlik bir GPU bulutu daha ucuz olabilir. Karşılaştırma için: L40S'in aylık fiyatı 730 saate bölündüğünde $1,23 eder.
- Kapalı modeller: BFL'nin FLUX 3 Video'su gibi yalnızca API ile sunulan video modelleri bazı işlerde açık modellerden iyi sonuç verebilir.
- KVKK: Yüzü ya da sesi tanınabilen kişiler içeren videolar kişisel veridir. Verinin Türkiye'de işlenmesi yurt dışına aktarım yükünü kaldırır; uyum değerlendirmesi kendi veri işleme süreçlerinize bağlıdır (KVKK ve GPU kiralama rehberimiz). Bu bilgi hukuki tavsiye değildir.
Özet
- Video dönüştürme kapasitesini NVENC sayısı belirler: RTX PRO 6000'de 4, L40S, RTX PRO 5000 ve RTX 5090'da 3, RTX PRO 4000'de 2; hepsi AV1 kodlar. H100 ve H200'de NVENC yoktur.
- RTX 5090'da sistem başına 12 eşzamanlı kodlama oturumu sınırı vardır (4 basamaklı canlı yayın merdiveninde en fazla 3 kanal); L40S, RTX PRO 4000, RTX PRO 5000 ve RTX PRO 6000'de yapay bir sınır yoktur.
- FFmpeg'de
-hwaccel cuda -hwaccel_output_format cuda ve scale_cuda ile hattı GPU'da tutun; kapasiteyi NVIDIA'nın referans hızlarıyla hesaplayıp paralel oturumlarla ölçün.
- Whisper altyazıyı doğrudan SRT olarak üretir; faster-whisper ile 3–6 GB, orijinal openai/whisper uygulamasıyla yaklaşık 10 GB'a kadar bellekle aynı kartta çalışır.
- Netleştirme FP8 dosyalarla 12–16 GB'ta çalışır; üretken video 24 GB'tan başlar, 14 milyar parametreli modeller için 48–96 GB düşünün ve lisansların bölge ve gelir koşullarını kontrol edin.
Kaynaklar