İçeriğe geç
gpukiralama Sipariş

LLM fine-tuning · paylaşımsız GPU sunucu

LLM fine-tuning için GPU sunucu kiralama: LoRA, QLoRA ve tam ince ayar

LLM fine-tuning (ince ayar) için size ayrılmış, aylık kiralık GPU sunucusu: açık ağırlıklı dil modellerini kendi Türkçe verinizle LoRA, QLoRA ya da tam ince ayarla uyarlayın. Paylaşımsız, VPS değil; veriler İstanbul Bağcılar'daki tesisimizde kalır.

Başlangıç fiyatı
$300 / ay
GPU belleği
24–141 GB
Önerilen GPU
6 model
Sunucu konumu
Bağcılar, İstanbul
Bu sayfada
  1. LLM fine-tuning için GPU sunucu: kısa cevap
  2. İnce ayar mı, RAG mı?
  3. LoRA, QLoRA ve tam ince ayar arasındaki fark nedir?
  4. İnce ayarda model boyutuna göre kaç GB VRAM gerekir?
  5. LLM fine-tuning için kiralık GPU sunucusu nasıl seçilir?
  6. İnce ayar hangi framework ile yapılır?
  7. Hangi temel model, hangi lisans?
  8. Türkçe veri nasıl hazırlanır?
  9. Eğitim süresi ve bütçe
  10. Aylık sunucu ne zaman mantıklı, ne zaman değil?
  11. Özet
  12. Kaynaklar
  13. Önerilen GPU'lar ve fiyatlar
  14. Hazır kurulu paketler
  15. Sık sorulan sorular

LLM fine-tuning için GPU sunucu: kısa cevap

LLM fine-tuning (ince ayar), hazır bir dil modelini kendi örneklerinizle ek eğitimden geçirip belirli bir göreve ya da üsluba uyarlamaktır. Çoğu iş için LoRA ya da QLoRA yeterlidir ve tek GPU'ya sığar: Llama 3.1 8B QLoRA'da 8,3 GB, LoRA'da 19,9 GB VRAM ister. Bu iş için size ayrılmış, paylaşımsız GPU sunucusunu aylık kiralayabilirsiniz; veriler İstanbul Bağcılar'daki tesisimizde kalır.

Değerler sitemizin VRAM hesabından (2.048 token, batch 1, gradient checkpointing açık); aynı ayarlarla Qwen3 32B LoRA'da 72,2 GB, Llama 3.3 70B QLoRA'da 50,5 GB ister. Tam ince ayarda (full fine-tuning) ağırlık, gradyan ve AdamW durumu parametre başına yaklaşık 16 bayt tutar: 8B bir model bile 131,6 GB ister ve en az iki karta bölünür. Ekim 2026 itibarıyla önerilerimiz şöyle (fiyatlar GPU başına, aylık ve KDV hariç):

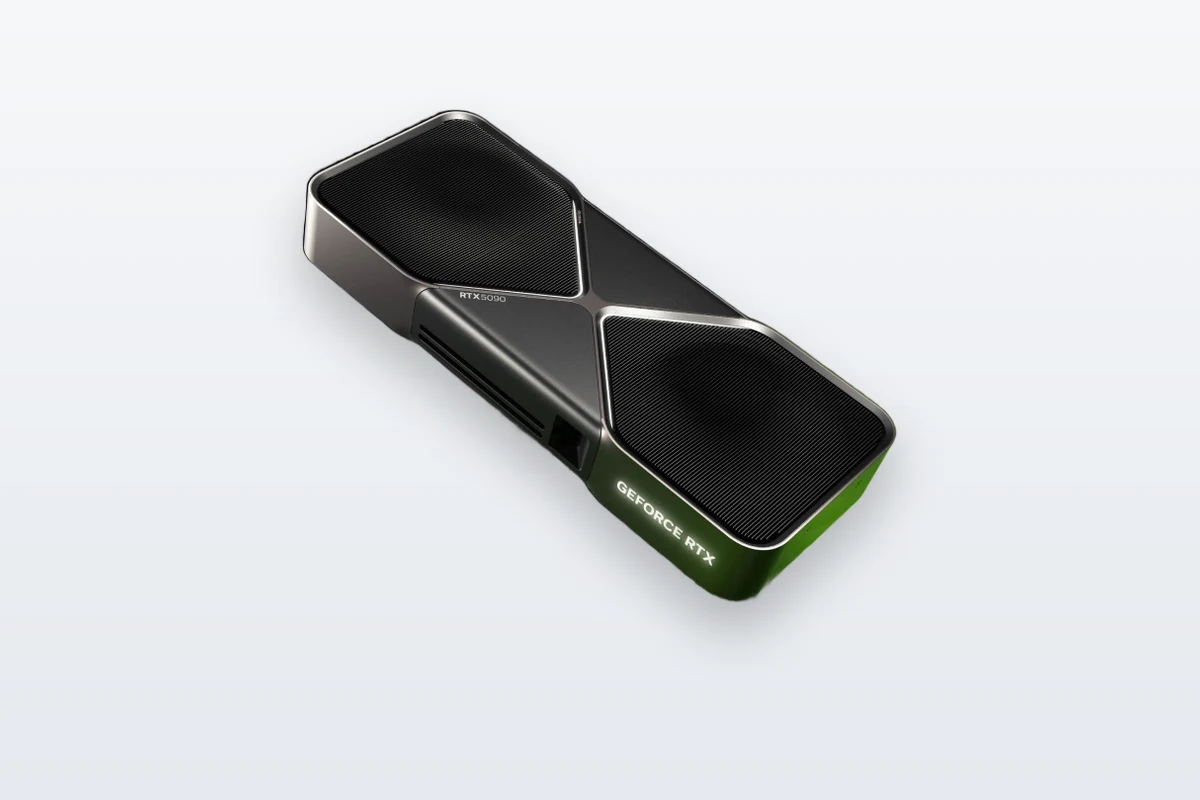
  • 8B LoRA, 14–32B QLoRA: 32 GB'lık RTX 5090, aylık $600.
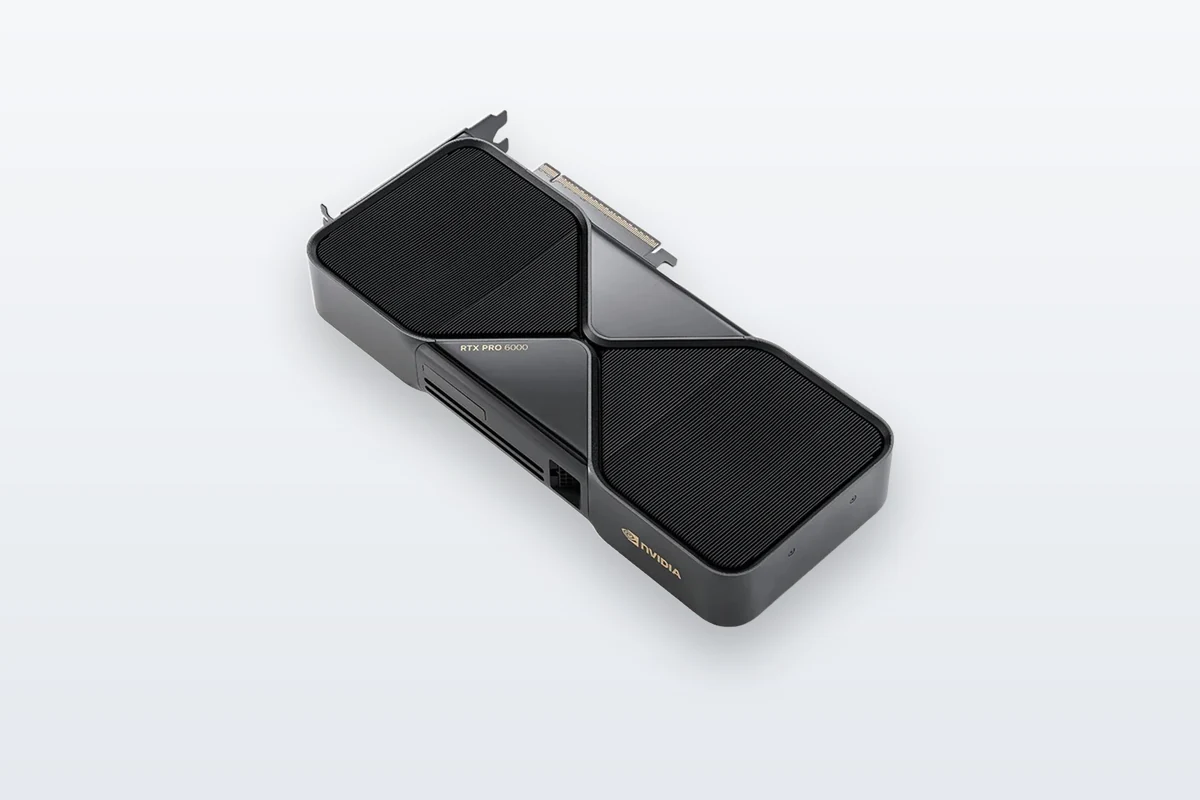
  • 32B LoRA, 70B QLoRA, eğitim ve servis aynı kartta: 96 GB'lık RTX PRO 6000, aylık $1.600.
  • Tam ince ayar: 8B için 2 × H100 (GPU başına aylık $2.500), 14B için 2 × H200 (GPU başına aylık $3.000).
  • Ayda yalnızca bir iki kısa eğitim yapacaksanız saatlik bir bulut daha ucuz olabilir; aylık sunucu sık deney yapan ya da modelini aynı makinede servis eden ekipler içindir.

İnce ayar mı, RAG mı?

Modelin bilmediği ve sık değişen bilgiyi eklemek istiyorsanız RAG, modelin cevap verme biçimini değiştirmek istiyorsanız ince ayar doğru araçtır.

LIMA çalışmasında 65B'lik bir LLaMA modeli yalnızca 1.000 özenle seçilmiş örnekle ince ayarlandı. Yazarlar, modelin bilgisinin neredeyse tamamının ön eğitimde (pretraining) öğrenildiği sonucuna vardı.

  • İnce ayara uygun: sabit bir JSON şeması, sınıflandırma, kurumsal üslup, alan terminolojisi, büyük bir modelin işini küçük ve ucuz bir modele devretmek.
  • RAG için uygun: ürün kataloğu, mevzuat, iç belgeler gibi güncel kalması gereken bilgi; kaynak gösterme; belge bazında erişim yetkisi.

İkisi çoğu zaman birlikte kullanılır: RAG doğru belgeyi getirir, ince ayarlı model cevabı istenen biçimde yazar. Şirket içi asistanın yapı taşlarını kurumsal yapay zeka sayfamızda anlattık.

LoRA, QLoRA ve tam ince ayar arasındaki fark nedir?

Üçü de aynı modeli uyarlar; fark, hangi ağırlıkların eğitildiği ve ana modelin bellekte nasıl tutulduğudur.

Yöntem Ne eğitilir? Ana model bellekte Ne zaman?
QLoRA Küçük adaptör matrisleri 4-bit (NF4), dondurulmuş Bellek kısıtlı, büyük model, ilk denemeler
LoRA Küçük adaptör matrisleri BF16, dondurulmuş Varsayılan seçim; 4-bit çözme adımı yok
Tam ince ayar Tüm ağırlıklar Ağırlık, gradyan ve AdamW durumu: ~16 bayt/parametre Davranışı kökten değiştirmek, sürekli ön eğitim

LoRA'yı tanıtan makale, GPT-3 175B'de eğitilen parametre sayısını 10.000 kat, GPU belleği ihtiyacını 3 kat azalttığını ve çıkarıma (inference) ek gecikme eklemediğini gösterdi. QLoRA makalesi ise 65B bir modelin tek bir 48 GB GPU'da, 16-bit ince ayarın başarımını koruyarak eğitilebildiğini gösterdi.

LoRA ya da QLoRA ile başlayın; tam ince ayarı sona bırakın. Sürekli ön eğitim ve sıfırdan eğitim için model eğitimi sayfamıza bakın.

İnce ayarda model boyutuna göre kaç GB VRAM gerekir?

QLoRA'da 70B'ye, LoRA'da 32B'ye kadar modeller tek karta sığar; tam ince ayar ise 8B'de bile iki kart ister. Değerler sitemizin VRAM hesaplayıcısından; varsayım: 2.048 token, batch 1, gradient checkpointing açık, kart belleğinin %92'si kullanılabilir.

Model QLoRA LoRA Tam ince ayar
Llama 3.1 8B 8,3 GB; her kartta 1 19,9 GB; RTX 5090'da 1 131,6 GB; 2 × H100, H200 ya da RTX PRO 6000
Qwen3 14B 13,3 GB; RTX PRO 4000'de 1 34,6 GB; RTX PRO 5000 ya da L40S'te 1 240,7 GB; 2 × H200 ya da 4 × H100
Mistral Small 3.2 24B 18,3 GB; RTX 5090'da 1 52,8 GB; RTX PRO 6000'de 1 387,8 GB; 4 × H200 ya da 8 × H100
Qwen3 32B 25,1 GB; RTX 5090'da 1 72,2 GB; RTX PRO 6000'de 1 529,7 GB; 8 × H100, H200 ya da RTX PRO 6000
Llama 3.3 70B 50,5 GB; RTX PRO 6000'de 1 152 GB; 2 × RTX PRO 6000 ya da H200 1.137 GB; 8 GPU'ya sığmaz

Dizi uzunluğu ve batch büyüdükçe aktivasyon belleği hızla artar. 4.096 token ve batch 4'te Qwen3 14B LoRA 55 GB'a, Llama 3.3 70B QLoRA 95,4 GB'a çıkar; ikincisi artık tek bir RTX PRO 6000'e sığmaz. Kendi ayarlarınızı VRAM hesaplayıcının ince ayar modunda deneyin. Qwen3.6 27B ya da Gemma 4 31B gibi tabloda olmayan yoğun (dense) modellerde ihtiyaç kabaca parametre sayısıyla orantılıdır.

LLM fine-tuning için kiralık GPU sunucusu nasıl seçilir?

Önce yöntemi ve modeli belirleyin, sonra o modelin sığdığı kartlar arasında aylık fiyatı düşük olanla başlayın; çok GPU'ya yalnızca model tek karta sığmadığında ya da eğitim süresi işinize uymadığında geçin. Kartların FP8 ve FP4 desteğini, bellek bant genişliğini ve çok GPU'lu eğitimdeki farklarını LLM fine-tuning için en iyi GPU rehberimizde karşılaştırdık.

İş yükü Önerilen GPU Neden Aylık fiyat (GPU başına)
Öğrenme, veri denemeleri, 8–14B QLoRA RTX PRO 4000 24 GB ECC; 14B QLoRA 13,3 GB $450
8B LoRA, 14–32B QLoRA RTX 5090 32 GB; 32B QLoRA 25,1 GB $600
14B LoRA RTX PRO 5000 ya da L40S 48 GB, ECC; 14B LoRA 34,6 GB; L40S'in FP8 işlem gücü daha yüksek $800 / $900
24–32B LoRA, 70B QLoRA, eğitim ve servis aynı kartta RTX PRO 6000 96 GB; MIG ile 4 × 24 GB bölüm $1.600
8B tam ince ayar, hızın kritik olduğu işler 2 × H100 131,6 GB; HBM bellek, yüksek BF16 ve FP8 hızı $2.500
14B tam ince ayar 2 × H200 240,7 GB; H100'le 4 kart gerekir $3.000

RTX PRO 6000, RTX 5090 ve L40S PCIe üzerinden haberleşir; H100 ve H200 NVLink destekler, ancak kiraladığınız sunucudaki bağlantı kartın sürümüne ve sunucu yapılandırmasına bağlıdır. LoRA'da GPU'lar yalnızca küçük adaptör gradyanlarını paylaştığı için PCIe genellikle yeter; tam ince ayarda iletişim yükü artar. 8B tam ince ayar 2 × RTX PRO 6000'e de sığar, ancak FSDP trafiği PCIe'den geçer. NVLink ihtiyacınızı sipariş formunda belirtin.

İki kart arasında kaldıysanız RTX 5090 ile RTX PRO 6000 farkını ve RTX PRO 6000 ile H100 farkını karşılaştırma sayfalarımızda anlattık.

İnce ayar hangi framework ile yapılır?

LLM fine-tuning için tek GPU'da Unsloth ya da TRL, çok GPU'da Axolotl ya da LlamaFactory yaygın seçeneklerdir. Dördü de GitHub'da Apache 2.0 lisansıyla geliştirilen açık kaynak projelerdir ve Hugging Face model biçimiyle çalışır. Ekim 2026 itibarıyla güncel sürümler:

  • Unsloth (2026.10.8): Tek GPU'da daha az bellekle LoRA, QLoRA ve tam ince ayar; RTX 5090 ve RTX PRO 6000 gibi Blackwell kartları destekler. Belgelerine göre çok GPU şimdilik Accelerate ya da DeepSpeed ile, elle kurulumla çalışıyor.
  • Hugging Face TRL (1.16.0) ve PEFT (0.21.2): SFT, DPO, GRPO ve KTO eğiticileri; LoRA ve QLoRA adaptörleri PEFT ile kurulur.
  • Axolotl (0.21.0): Süreci tek bir YAML dosyasında tanımlar; FSDP2 ve DeepSpeed ile çok GPU'yu, torchrun ve Ray ile çok sunuculu eğitimi destekler.
  • LlamaFactory (eski adıyla LLaMA-Factory, 0.9.5): LlamaBoard web arayüzüyle kod yazmadan LoRA, QLoRA, tam ince ayar ve DPO, KTO, ORPO gibi tercih optimizasyonu yöntemleri.
  • torchtune: PyTorch ekibi 15 Temmuz 2025'te aktif geliştirmeyi durdurdu; projeye yeni özellik eklenmiyor. Yeni bir projeye torchtune ile başlamayın.

TRL ile tek kartta LoRA eğitimi; ayarlar tablodaki varsayımla aynıdır (Qwen3 8B LoRA: 20,6 GB). Veri, her satırı bir {"messages": [...]} kaydı olan JSONL dosyasıdır:

import torch
from datasets import load_dataset
from peft import LoraConfig
from trl import SFTConfig, SFTTrainer

dataset = load_dataset("json", data_files="egitim.jsonl", split="train")

trainer = SFTTrainer(
    model="Qwen/Qwen3-8B",
    train_dataset=dataset,
    args=SFTConfig(
        output_dir="qwen3-8b-lora",
        max_length=2048,
        per_device_train_batch_size=1,
        gradient_accumulation_steps=16,
        learning_rate=1e-4,
        num_train_epochs=2,
        assistant_only_loss=True,  # kayıp yalnızca asistan cevaplarında
        model_init_kwargs={"dtype": torch.bfloat16},  # belirtilmezse FP32 yüklenir
    ),
    peft_config=LoraConfig(r=16, lora_alpha=32, target_modules="all-linear"),
)
trainer.train()

Betiği egit.py olarak kaydedip tek kartta python egit.py, birden fazla kartta accelerate launch egit.py ile çalıştırırsınız. QLoRA için SFTTrainer'ın quantization_config parametresine 4-bit bir BitsAndBytesConfig verilir.

Eğitimden sonra adaptörü PEFT'in merge_and_unload() işleviyle ana modele birleştirebilir ya da birleştirmeden vLLM'de --enable-lora seçeneğiyle sunabilirsiniz; vLLM aynı ana model üzerinde birden çok adaptörü birlikte servis eder. Servis tarafı için LLM inference sayfamıza bakın.

Hangi temel model, hangi lisans?

Ticari kullanımda en az kısıtlı seçenek Apache 2.0 lisanslı modellerdir; Llama ise adlandırma ve ibare şartı getirir. Ekim 2026 itibarıyla yaygın açık modeller:

Model ailesi Lisans Dikkat edilecek nokta
Qwen3, Qwen3.5, Qwen3.6 Apache 2.0 Her sürümün lisansını model kartından kontrol edin
Gemma 4 Apache 2.0 —
Mistral Small 3.2 Apache 2.0 —
gpt-oss Apache 2.0 Yalnızca harmony sohbet biçimiyle doğru çalışır
Llama 3.1 ve 3.3 Llama Community License "Built with Llama" ibaresi; türev modelin adı "Llama" ile başlamalı; sürüm tarihinde aylık 700 milyonu aşan kullanıcısı olan şirketler Meta'dan ayrı lisans almalı

Türkçeye özel seçenekler de var: VNGRS'in Kumru-2B modeli (Apache 2.0) Türkçe için hazırlanmış, 50.176 tokenlık bir tokenizer kullanır. Trendyol-LLM-8B-T1 (Apache 2.0) ise Qwen3 8B üzerine Türkçe e-ticaret verisiyle geliştirilmiştir. Tabanı kendi değerlendirme setinizde seçin. Bu bölüm genel bilgidir, hukuki tavsiye değildir.

Türkçe veri nasıl hazırlanır?

Veriyi modelin sohbet şablonuna uygun, temiz ve kişisel veriden arındırılmış biçimde hazırlayın; sonucu çoğu zaman GPU değil veri belirler.

  • Sohbet şablonu: Örnekleri kullanıcı ve asistan rolleriyle saklayın; TRL bu biçimde modelin kendi sohbet şablonunu (chat template) uygular. Şablonu elle yazmayın: Hugging Face belgelerine göre yanlış kontrol tokenları başarımı belirgin biçimde düşürür, şablonun üstüne ikinci kez özel token eklemek de modele zarar verir.
  • Kaybı cevaplarda hesaplayın: assistant_only_loss=True ile model kullanıcı mesajlarını değil, cevapları öğrenir.
  • Az ama temiz veri: Birkaç bin tutarlı ve kontrol edilmiş örnekle başlayın; bir kısmını değerlendirme için ayırıp eğitime hiç sokmayın.
  • Türkçe harfler: Metni küçük harfe çevirmeyin. Python'un varsayılan lower() işlevi "IŞIK"ı "işik" yapar, "İ"yi ise "i" artı ayrı bir nokta işaretine (U+0307) çevirir. Dosyaları UTF-8 olarak kaydedin.
  • Token sayısı: Çok dilli tokenizer'lar Türkçe kelimeleri genellikle birkaç parçaya böler; süre ve bellek hesabını kelimeyle değil, modelin kendi tokenizer'ıyla saydığınız tokenla yapın.
  • Kişisel veri: Müşteri yazışmaları ve çağrı kayıtları kişisel veridir; eğitimden önce ayıklayın ya da maskeleyin. Ayrıntılar KVKK rehberimizde.

Eğitim süresi ve bütçe

Süreyi tahmin etmek için eğitimi 50–100 adım çalıştırıp saniyedeki token sayısını ölçün ve toplam token sayısını (örnek sayısı × ortalama token × epoch) bu hıza bölün; maliyeti ise tek koşunun süresinden çok deneme sayısı belirler. Örnek hesaplar için LLM fine-tuning ne kadar sürer ve ne kadara mal olur? yazımıza, birden fazla GPU'ya geçiş için multi-GPU eğitim rehberimize bakın.

Aylık sunucu ne zaman mantıklı, ne zaman değil?

Aylık ve size ayrılmış bir sunucu, kartı ayın büyük bölümünde kullanıyorsanız mantıklıdır. En kısa kiralama süresi 1 aydır ve saat bazında ücretlendirme yapmıyoruz; yıllık planda aylık fiyata %20 indirim uygulanır.

Mantıklı olduğu durumlar:

  • Haftada birkaç eğitim ve değerlendirme koşuyorsanız: sabit fiyatta her ek koşunun ek maliyeti yoktur.
  • Eğittiğiniz modeli aynı sunucuda servis edecekseniz: kart, eğitim bitince boşa çıkmaz.
  • Eğitim verisi kişisel veri ya da ticari sır içeriyorsa: veriler İstanbul'daki kendi tesisimizde, Türkiye'de kalır. Uyum değerlendirmesi kendi veri işleme süreçlerinize bağlıdır; bu bilgi hukuki tavsiye değildir.
  • Sabit bir aylık dolar fiyatıyla çalışıp Türk lirası fatura almak istiyorsanız: fatura, kesildiği günün TCMB döviz satış kuruyla düzenlenir.

Mantıklı olmadığı durumlar:

  • Ayda bir iki kez, birkaç saatlik tek bir eğitim yapacaksanız saatlik bir bulut daha ucuzdur. Karşılaştırmak için aylık fiyatı sağlayıcının saatlik fiyatına bölün; çıkan sayı, aylık sunucunun öne geçtiği kullanım saatidir. Aylık fiyatımızın 730 saate bölünmüş karşılığı RTX PRO 6000 için $2,19, H100 için $3,42. Global bulutların güncel saatlik fiyatları model sayfalarımızda yer alır.
  • Veri yurt dışına çıkabiliyorsa, en güçlü kapalı modeller API üzerinden bazı işlerde ince ayarlı bir açık modelden daha iyi sonuç verebilir; önce küçük bir test setinde karşılaştırın.

Özet

  • LoRA ve QLoRA çoğu iş için yeterlidir ve tek GPU'ya sığar: 8B LoRA 19,9 GB, 32B LoRA 72,2 GB, 70B QLoRA 50,5 GB (2.048 token, batch 1).
  • Tam ince ayar parametre başına ~16 bayt ister; 8B bir model bile 131,6 GB ile iki kart gerektirir.
  • Yaygın araçlar Unsloth, TRL, Axolotl ve LlamaFactory'dir; torchtune artık geliştirilmiyor.
  • Süreyi kısa bir ölçüm koşusuyla tahmin edin; maliyeti deneme sayısı belirler.
  • Aylık sunucu sık deney yapan ve modelini aynı makinede servis eden ekipler içindir; tek seferlik kısa işlerde saatlik bulut daha ucuz olabilir.

Kaynaklar

LLM fine-tuning için önerilen GPU'lar

Fiyatlar GPU başına, aylık ve KDV hariçtir. Tek siparişte en fazla 8 GPU kiralayabilirsiniz.

Öne çıkan model

NVIDIA RTX PRO 6000 Blackwell ekran kartı

RTX PRO 6000

Blackwell

96 GB

Paylaşımsız · VPS değil

96 GB GDDR7 bellek: 70B modeller FP8'de tek kartta. LLM inference, fine-tuning, görsel ve video üretimi için.

Bu iş için: 96 GB: Qwen3 32B LoRA (72,2 GB) ve Llama 3.3 70B QLoRA (50,5 GB) tek kartta; eğitim ve servis aynı kartta

$1.600 / ay

GPU başına, KDV hariç · saatlik karşılığı $2,19

Global bulut medyanından %6 düşük (getdeploying.com, 23 Ekim 2026)

NVIDIA GeForce RTX 5090 ekran kartı

RTX 5090

Blackwell

32 GB

Paylaşımsız · VPS değil

32 GB GDDR7 ve 1,8 TB/s bant genişliği: 32 GB'a sığan LLM'ler, FLUX ve render için hızlı Blackwell kartı.

Bu iş için: 32 GB: Llama 3.1 8B LoRA (19,9 GB) ve Qwen3 32B QLoRA (25,1 GB) tek kartta; ECC ve MIG yok

$600 / ay

GPU başına, KDV hariç · saatlik karşılığı $0,82

NVIDIA RTX PRO 5000 Blackwell ekran kartı

RTX PRO 5000

Blackwell

48 GB

Paylaşımsız · VPS değil

48 GB ECC'li GDDR7, MIG ile 2 × 24 GB ve FP4: 32B modeller FP8'de; görsel üretimi ve 4:2:2 video için Blackwell kartı.

Bu iş için: 48 GB ECC: Qwen3 14B LoRA (34,6 GB) tek kartta; MIG ile 24'er GB'lık iki ayrı deney

$800 / ay

GPU başına, KDV hariç · saatlik karşılığı $1,10

NVIDIA H200 ekran kartı

H200

Hopper

141 GB

Paylaşımsız · VPS değil

141 GB HBM3e bellek: 70B+ modeller, uzun bağlam ve büyük batch LLM inference için.

Bu iş için: 141 GB: Qwen3 14B tam ince ayarı (240,7 GB) 2 kartta; aynı iş H100'le 4 kart ister

$3.000 / ay

GPU başına, KDV hariç · saatlik karşılığı $4,11

Global bulut medyanından %11 düşük (getdeploying.com, 23 Ekim 2026)

NVIDIA H100 ekran kartı

H100

Hopper

80 GB

Paylaşımsız · VPS değil

80 GB HBM bellek ve FP8 destekli Transformer Engine ile büyük model eğitimi ve yoğun LLM inference için.

Bu iş için: 80 GB HBM: Llama 3.1 8B tam ince ayarı (131,6 GB) 2 kartta; BF16'da 756–989 TFLOPS

$2.500 / ay

GPU başına, KDV hariç · saatlik karşılığı $3,42

Global bulut medyanından %10 düşük (getdeploying.com, 23 Ekim 2026)

NVIDIA GeForce RTX 3090 ekran kartı

RTX 3090

Ampere

24 GB

Paylaşımsız · VPS değil

24 GB GDDR6X ve 936 GB/s bant genişliğiyle 24 GB'a sığan dil modelleri, SDXL ve FLUX, TTS için uygun fiyatlı kart.

Bu iş için: 8B modelde LoRA (19,9 GB) ve 14B modelde QLoRA (13,3 GB) tek kartta

$300 / ay

GPU başına, KDV hariç · saatlik karşılığı $0,41

Modeliniz kaç GB bellek ister? VRAM hesaplayıcı ile hesaplayın ya da tüm modelleri karşılaştırın.

LLM fine-tuning için hazır kurulu paketler

Sunucuyu bu iş için gereken yazılımlar ve modeller kurulu, HTTPS ve şifreyle erişilebilir halde teslim edebiliriz. Kurulum ücretsizdir, aylık ek bedeli yoktur ve root yetkisi sizde kalır.

Kurulum ücretsiz

JupyterLab fine-tuning

Tarayıcıdan açılan JupyterLab içinde CUDA'lı PyTorch, Hugging Face Transformers, PEFT ve TRL, Unsloth, Axolotl ve görsel LoRA için ai-toolkit kurulu gelir. Sürücü ve ortam kurmadan, oturum süresi sınırı olmadan, İstanbul'daki size ayrılmış GPU'da LLM ve görsel model eğitin.

JupyterLab PyTorch (CUDA) Hugging Face Transformers PEFT

En az 16 GB GPU belleği

Bu hizmette neler var?

  • Paylaşımsız GPU sunucu VPS ya da paylaşımlı hosting değil: ekran kartları ve sunucu kaynakları yalnızca size ayrılır, performansınız başkasının yüküne göre değişmez.
  • Sabit aylık fiyat Ne ödeyeceğiniz siparişten önce belli. Yıllık kiralamada aylık fiyata %20 indirim uygulanır.
  • Veriniz Türkiye'de Sunucular Bağcılar, İstanbul'daki kendi tesisimizde; UPS, jeneratör desteği ve yedekli internet bağlantılarıyla.
  • Türk lirası fatura Fiyatlar dolar bazlıdır; fatura, düzenlendiği günkü TCMB kuruyla Türk lirası ve KDV'li kesilir.
  • Sunucu kaynakları baştan belli Her 4 GB GPU belleği için 1 CPU çekirdeği ve GPU belleğinin 1,5 katı RAM verilir; 1 TB SSD ve size özel bir IP adresi her siparişe dahildir. Tek siparişte en fazla 8 GPU.
  • 7/24 acil destek ve SLA Aylık %99,5 erişilebilirlik hedefi ve hizmet kredisi; sunucuya erişilemediğinde 7/24 telefonla, Türkçe ve doğrudan sunucuları işleten ekibe ulaşırsınız.

Nasıl başlarsınız?

  1. 1

    Planınızı seçin

    GPU modelini, adedi ve aylık ya da yıllık dönemi seçin. Fiyat siparişten önce net olarak görünür.

  2. 2

    Sipariş talebini gönderin

    Formu doldurun. 1 iş günü içinde sizinle iletişime geçip kurulum ayrıntılarını ve teslim tarihini birlikte planlıyoruz.

  3. 3

    Sunucunuz hazır

    Planlanan tarihte sunucunuz hazır olur; erişim bilgileri e-postanıza gelir ve sorularınız için bize doğrudan ulaşırsınız.

İlgili rehberler

LLM fine-tuning hakkında sık sorulan sorular

Unsloth, Axolotl ya da TRL sunucuda kurulu mu gelir?

İsterseniz evet. JupyterLab fine-tuning paketini seçerseniz sunucu JupyterLab, CUDA'lı PyTorch, Unsloth, Axolotl ve Hugging Face TRL kurulu olarak teslim edilir; kurulum ücretsizdir. Paket seçmezseniz eğitim araçlarını pip ya da Docker ile kendiniz kurarsınız; kurulumla ilgili sorularınızı doğrudan sunucuları işleten ekibe Türkçe sorabilirsiniz.

Eğitim verilerim nerede işlenir?

Sunucular İstanbul Bağcılar'daki kendi tesisimizdedir ve verileriniz Türkiye'de kalır. Kiraladığınız GPU size ayrılır, başka müşterilerle paylaşılmaz. KVKK açısından uyum değerlendirmesi kendi veri işleme süreçlerinize bağlıdır; bu bilgi hukuki tavsiye değildir.

Birden fazla GPU kiralayabilir miyim, NVLink olur mu?

Tek siparişte en fazla 8 GPU kiralayabilirsiniz. H100 ve H200 NVLink destekler, ancak belirli bir NVLink topolojisi vaat etmiyoruz; ihtiyacınızı sipariş formunda belirtin. LoRA ve QLoRA ile çok GPU'lu eğitimde PCIe çoğu zaman yeterlidir.

İnce ayarladığım Llama modelini ticari bir üründe kullanabilir miyim?

Llama 3.1 ve 3.3 lisansları ticari kullanıma izin verir; ancak dağıttığınız ya da kullanıma sunduğunuz türev modelin adının “Llama” ile başlamasını, üründe “Built with Llama” ibaresini ve sürüm tarihinde aylık 700 milyonu aşan kullanıcısı olan şirketlerin Meta'dan ayrı lisans almasını ister. Qwen3, Mistral Small 3.2, Gemma 4 ve gpt-oss Apache 2.0 lisanslıdır. Bu genel bilgidir, hukuki tavsiye değildir.

Eğittiğim modeli aynı sunucuda yayına alabilir miyim?

Evet; sunucu ay boyunca size ayrıldığı için eğitim bittiğinde aynı kartta vLLM ile servis edebilirsiniz. Örneğin Qwen3 32B, ağırlıklar ve KV önbelleği FP8'deyken 16 eşzamanlı istekle (8.192 token) 52,6 GB ister ve tek bir RTX PRO 6000'e sığar. LoRA adaptörünü birleştirmeden de sunabilirsiniz.

Sipariş formunda hangi bilgileri vermeliyim?

Önce model boyutunu, yöntemi (LoRA, QLoRA ya da tam ince ayar), dizi uzunluğunu ve batch boyutunu VRAM hesaplayıcının ince ayar modunda deneyin. Ardından sipariş formuna modeli, yöntemi, veri miktarını ve varsa NVLink ya da işletim sistemi ihtiyacınızı yazın; 1 iş günü içinde sizinle iletişime geçeriz.

7B ya da 8B bir modelin fine-tuning'i için kaç GB VRAM gerekir?

Sitemizin VRAM hesabına göre (2.048 token, batch 1, gradient checkpointing açık) Llama 3.1 8B QLoRA'da 8,3 GB, LoRA'da 19,9 GB, tam ince ayarda 131,6 GB ister; Qwen3 8B'de sırasıyla 8,8 GB, 20,6 GB ve 134,7 GB. Yani 8B'de QLoRA da LoRA da 24 GB'lık RTX PRO 4000'e sığar, LoRA'da pay az kaldığı için 32 GB'lık RTX 5090 daha rahattır; tam ince ayar ise 2 × H100 ister. 7B modellerde ihtiyaç, parametre sayısıyla orantılı olarak biraz daha düşüktür.

Son güncelleme: . Fiyatlar fiyat listemizden otomatik gelir.

Diğer hizmetler

Tüm hizmetler →

LLM inference

Kendi uygulamanıza OpenAI uyumlu bir LLM API'si kurmak için aylık kiralık, paylaşımsız GPU sunucu: model belleği, eşzamanlı istek, nicemleme ve vLLM, SGLang ya da Ollama seçimi. Veriler İstanbul'daki kendi tesisimizde, Türkiye'de kalır.

Hizmeti incele

Kurumsal yapay zeka

Şirket için yapay zeka asistanı: belgelerinizle çalışan, verisi Türkiye'de kalan açık model ve RAG sunucusu. Model seçimi, kullanıcı sayısına göre GPU, aylık fiyat ve KVKK notları.

Hizmeti incele

Model eğitimi

Görüntü, ses ve dil modellerini kendi verinizle eğitmek için paylaşımsız, aylık kiralık GPU sunucusu; veriler İstanbul'daki tesisimizde kalır. Bu sayfa bir kurs değil, derin öğrenme modellerini GPU'da eğitmenin donanım ve yazılım tarafını anlatır.

Hizmeti incele

Görsel üretimi

E-ticaret firmaları, ajanslar ve SaaS ekipleri için ComfyUI'de Stable Diffusion (SDXL), FLUX ve Qwen-Image çalıştıran, size ayrılmış aylık GPU sunucu. Ürün fotoğraflarınız İstanbul'daki tesisimizde, Türkiye'de kalır.

Hizmeti incele

Video işleme

Video platformları, yayıncılar ve prodüksiyon ekipleri için size ayrılmış, aylık kiralık GPU sunucu: NVENC ile transcoding ve canlı yayın, Whisper ile otomatik altyazı, yapay zeka ile video netleştirme (upscale) ve açık modellerle video üretimi. Sunucular Bağcılar, İstanbul'daki kendi tesisimizde; videolarınız Türkiye'de kalır.

Hizmeti incele

3D render

Blender Cycles, V-Ray GPU, Redshift ve Octane için size ayrılmış, aylık kiralık GPU render sunucusu; kare başına ücretli bir render farm değil. Sunucular İstanbul'daki tesisimizde; sahneye göre VRAM, lisans ve kart seçimi bu sayfada.

Hizmeti incele

LLM fine-tuning için GPU ihtiyacınızı konuşalım

Hangi modelin ve kaç GPU'nun işinize yettiğinden emin değilseniz sipariş formuna iş yükünüzü yazın; uygun yapılandırmayı ve teslim tarihini birlikte planlayalım.

Sipariş formuna git