İçeriğe geç
gpukiralama Sipariş

Hazır kurulu · paylaşımsız GPU sunucu

Whisper ses sunucusu: Türkçe sesi yazıya çeviren ve metni seslendiren kurulu GPU sunucu

Whisper large-v3 ve turbo ile Türkçe kayıtları yazıya döken, Chatterbox Multilingual ile metni Türkçe seslendiren OpenAI uyumlu ses API'si, İstanbul'daki size ayrılmış GPU sunucuda kurulu gelir. Çağrı merkezi dökümü, toplantı notu, SRT altyazı ve e-öğrenme seslendirmesi için; kayıtlarınız Türkiye'de kalır.

Kurulum
Ücretsiz
En az GPU belleği
16 GB
Başlangıç fiyatı
$200 / ay
Sunucu konumu
Bağcılar, İstanbul

Sunucuda kurulu gelenler

  • speaches OpenAI uyumlu ses API'si: /v1/audio/transcriptions, SRT/VTT çıktısı, akışlı döküm ve Realtime API
  • faster-whisper Whisper'ı CTranslate2 ile daha az bellekle çalıştıran konuşma tanıma motoru
  • Whisper large-v3 Doğruluk öncelikli Türkçe konuşma tanıma modeli, 1.550M parametre (Systran CTranslate2 dönüşümü)
  • Whisper large-v3-turbo Hız öncelikli konuşma tanıma modeli, 809M parametre (deepdml CTranslate2 dönüşümü)
  • Chatterbox Multilingual Türkçe dahil 23 dilde metinden sese ve referans kayıttan ses klonlama; çıktıya Perth filigranı ekler
  • Chatterbox-TTS-Server Chatterbox için web arayüzü ve OpenAI uyumlu /v1/audio/speech uç noktası

ve 1 bileşen daha; tam liste.

Kurulum ücretsiz, aylık ek bedel yok. HTTPS ve şifreyle erişim, root yetkisi sizde.

Bu sayfada
  1. Whisper ses sunucusu nedir, ne işe yarar?
  2. Sunucuda neler kurulu, hangi parça ne yapar?
  3. Konuşmayı yazıya çevirme nasıl çalışır?
  4. Hangi GPU yeterli? Whisper kaç GB VRAM ister?
  5. Toplu işleme mi, canlı yazıya çevirme mi?
  6. API ile ses kaydını yazıya dökme
  7. Metni sese çevirme: Türkçe TTS isteği
  8. Türkçe ses klonlama: izin ve filigran
  9. Toplantı notu için dökümü özetlemek
  10. Ne kurulmuyor ve neden?
  11. Kurulu yazılımlar ve lisanslar
  12. Önerilen GPU'lar ve fiyatlar
  13. Teslim ve erişim
  14. Sık sorulan sorular

Whisper ses sunucusu nedir, ne işe yarar?

Whisper ses sunucusu, Türkçe konuşmayı yazıya çeviren Whisper'ın (faster-whisper ile) ve Türkçe metni sese çeviren Chatterbox Multilingual'ın kurulu olarak geldiği, size ayrılmış (paylaşımsız) bir GPU sunucudur. İki yönü de tek bir HTTPS adresinden, OpenAI uyumlu /v1/audio/transcriptions ve /v1/audio/speech uç noktalarıyla kullanırsınız. Paket çağrı merkezi kayıtlarının dökümü, toplantı notu, video altyazısı ve e-öğrenme seslendirmesi için hazırlandı. Sunucular İstanbul Bağcılar'daki kendi tesisimizde çalışır, verileriniz Türkiye'de kalır.

Sunucuda neler kurulu, hangi parça ne yapar?

Paket iki ses servisi ve önlerinde duran bir ters vekil sunucudan (reverse proxy) oluşur:

  • speaches: OpenAI'nin ses API'siyle uyumlu, MIT lisanslı bir sunucudur. Konuşma tanımada faster-whisper'ı kullanır; dosyadan döküm, akışlı döküm, İngilizceye çeviri ve WebSocket üzerinden Realtime API sunar. Her dökümden önce Silero VAD ile konuşma olmayan bölümleri ayıklar. Boşta kalan modelleri varsayılan olarak 300 saniye sonra bellekten çıkarır, böylece kart boşken bellek başka işlere kalır.
  • faster-whisper: Whisper'ı CTranslate2 ile çalıştıran motordur. README'sine göre aynı doğrulukta openai/whisper'dan 4 kata kadar hızlıdır ve daha az bellek kullanır.
  • Whisper large-v3 ve large-v3-turbo: İki model de önceden indirilmiş gelir: doğruluk öncelikli Systran/faster-whisper-large-v3 ve hız öncelikli deepdml/faster-whisper-large-v3-turbo-ct2. İkisi de OpenAI ağırlıklarının MIT lisanslı CTranslate2 dönüşümüdür; istekteki model alanını değiştirerek aralarında geçersiniz.
  • Chatterbox Multilingual: Resemble AI'ın MIT lisanslı, 0,5 milyar parametreli seslendirme modelidir. Türkçe dahil 23 dilde konuşur, kısa bir referans kayıttan o sesle okuyabilir (ses klonlama) ve her çıktıya duyulmayan bir Perth filigranı ekler.
  • Chatterbox-TTS-Server: Chatterbox'ı bir web arayüzü ve OpenAI uyumlu /v1/audio/speech uç noktasıyla sunan MIT lisanslı sunucudur. Referans kayıtları arayüzden yükler, ayarları deneyerek sonucu dinlersiniz.
  • Caddy: HTTPS'i ve erişim denetimini yönetir. /v1/audio/speech isteklerini Chatterbox'a, diğer /v1/audio/... isteklerini speaches'e yönlendirir; uygulamanız tek bir taban adres bilir.

speaches seslendirme için Kokoro ve Piper'ı destekler, ama Türkçe için ikisini de kullanmıyoruz: Kokoro'nun ses listesinde Türkçe yok, Piper'ın tek Türkçe sesi ise ticari kullanıma kapalı bir veriyle eğitilmiş (aşağıda). speaches Chatterbox'ı desteklemediği için Chatterbox kendi sunucusuyla ayrı bir konteynerde çalışır.

Konuşmayı yazıya çevirme nasıl çalışır?

Whisper bir kodlayıcı-kod çözücü (encoder-decoder) transformer modelidir. Whisper makalesine göre ses 16.000 Hz'e çevrilir, 30 saniyelik parçalara bölünür ve Mel spektrogramına dönüştürülür. Kodlayıcı sesi bir temsile çevirir, kod çözücü metni parça parça yazar ve her bölüm için başlangıç ve bitiş zamanını tahmin eder. İstekte language=tr verdiğinizde dil tespiti adımı atlanır; kısa kayıtlarda modelin dili yanlış tahmin etmesi önlenir.

Whisper Türkçede ne kadar doğru?

Makalenin ek tablolarında large-v2'nin Türkçe kelime hata oranı (WER) FLEURS'ta %8,4, Common Voice 9'da %14,5'tir. Aynı tablolarda medium model %10,4 ve %17,7'de kalır; Türkçede büyük model seçmenin farkı buradan görülür. openai/whisper README'sindeki dil bazlı grafik, Türkçe dahil dillerde large-v3'ü large-v2 ile Common Voice 15 ve FLEURS üzerinde karşılaştırır.

Bu rakamları okurken üç noktaya dikkat edin:

  • Kayıt türü: FLEURS ve Common Voice'ta insanlar hazır cümleleri okur. Dar bantlı telefon sesi, üst üste konuşma ve arka plan gürültüsü hata oranını yükseltir.
  • Eklemeli dil: Türkçede tek bir yanlış ek bütün kelimeyi hatalı sayar. "Gönderilmedi" yerine "gönderildi" yazmak tek kelimelik bir hatadır ama anlamı tersine çevirir. Hem WER'e hem karakter hata oranına (CER) bakın, olumsuzluk eklerini ayrıca kontrol edin.
  • Uydurma metin: Makale, modelin tekrar döngüsüne girebildiğini ve bazen seste olmayan bir metin üretebildiğini belirtir. speaches'in VAD adımı uzun sessizlikleri çıkararak bu riski azaltır, ama tamamen ortadan kaldırmaz.

Kurum terimleri, ürün ve kişi adları için prompt alanına örnek bir metin, speaches'in ek hotwords alanına da terim listesi verebilirsiniz. Karar vermeden önce kendi kayıtlarınızdan temsili bir örneği elle düzeltip WER ölçün. Kapasite hesabı ve diğer açık modellerle karşılaştırma ses tanıma sayfamızda.

large-v3 mü, large-v3-turbo mu?

large-v3 large-v3-turbo
Parametre 1.550M 809M
GPU belleği (openai/whisper, PyTorch) ~10 GB ~6 GB
Göreli hız (large = 1) 1x ~8x
Konuşmayı İngilizceye çevirme Var Çeviri için eğitilmedi

Tablodaki değerler openai/whisper README'sinden alındı. Hız, A100 üzerinde İngilizce konuşmayla ölçülmüştür; README de dilin, konuşma hızının ve donanımın sonucu belirgin biçimde değiştirebileceğini yazar. Turbo, large-v3'ün doğrulukta küçük bir kayıpla daha hızlı çalışan sürümü olarak tanımlanır.

Pratik bir ayrım: hukuki tutanak, sağlık ve arşiv dökümü gibi doğruluğun öncelikli olduğu işlerde large-v3; canlı altyazı, yoğun çağrı kuyruğu ve taslak toplantı notunda turbo. Aynı örnek kayıtları iki modelle çevirip farkı kendi verinizde görün.

Hangi GPU yeterli? Whisper kaç GB VRAM ister?

Konuşma modelleri dil modellerine göre küçüktür; kartı çoğu zaman yanında ne çalıştıracağınız belirler. Kaynaklardaki değerler şöyle:

  • openai/whisper (PyTorch): large modeller yaklaşık 10 GB, turbo yaklaşık 6 GB.
  • faster-whisper README'si: Aynı boyuttaki large-v2, 8 GB'lık RTX 3070 Ti üzerinde 13 dakikalık bir kayıtta fp16 ile 4.525 MB, int8 ile 2.926 MB, fp16 ve 8'li batch ile 6.090 MB kullandı. Batch'li çalışmada kayıt 17 saniyede işlendi.
  • Chatterbox Multilingual: Resemble AI, PyTorch sürümü için bir bellek değeri yayımlamıyor. NVIDIA'nın model kartı, 4 bitlik GGUF uyarlaması için yaklaşık 3,5 GB veriyor; sunucuda kurulu PyTorch sürümü daha fazla kullanabilir. Kendi kartınızda nvidia-smi ile ölçün.
İş akışı GPU belleği ihtiyacı Uygun kartlarımız
Yalnızca döküm, large-v3, fp16 ~4,5 GB (faster-whisper, large-v2 ölçümü) 16 GB: RTX 5060 Ti
Toplu döküm, 8'li batch ~6,1 GB fp16, ~4,5 GB int8 16 GB ve üstü
Döküm ve Chatterbox seslendirme Whisper 4,5–6,1 GB + Chatterbox (PyTorch değeri yayımlanmadı) 16 GB'ta başlar; pay için RTX PRO 4000 (24 GB)
Döküm ve Qwen3 8B ile özet (int4, 8K bağlam, tek istek) ~6,1 + 7,1 = ~13,2 GB RTX PRO 4000, RTX A5000, RTX 3090
Döküm ve gpt-oss-20b ile özet (int4, 8K bağlam, tek istek) ~6,1 + 13,5 = ~19,6 GB RTX 3090, RTX 5090
Yoğun kullanım: döküm, seslendirme ve gpt-oss-20b (32K bağlam, 4 istek) ~6,1 + 15,0 = ~21,1 GB + Chatterbox RTX 5090 (32 GB)

Dil modeli değerleri VRAM hesaplayıcımızdan alındı; kendi bağlam ve eşzamanlılık değerlerinizi hesaplayıcıda deneyin. Toplamı kartın kullanılabilir belleğiyle karşılaştırın: 16 GB'lık kartta yaklaşık 14,7 GB, 24 GB'ta 22,1 GB, 32 GB'ta 29,4 GB kullanılabilir. Uzun süre kesintisiz çalışan döküm kuyruklarında ECC'li bellek istiyorsanız 24 GB'lık RTX A5000 ya da RTX PRO 4000'i seçin.

Toplu işleme mi, canlı yazıya çevirme mi?

Toplu (batch): Kayıtlar bir klasörde birikir, bir betik her dosyayı /v1/audio/transcriptions adresine gönderir ve sonucu veritabanına yazar. Gece çalışan bir kuyruk, gündüz kartı seslendirmeye ya da özete bırakır. Santraliniz müşteriyi ve temsilciyi ayrı kanallara kaydediyorsa kanalları ayrı dosya olarak göndermek, kimin konuştuğunu ayrı bir modele gerek kalmadan verir.

Akışlı döküm: İstekte stream=true verdiğinizde speaches sonuçları ses işlendikçe Server-Sent Events (SSE) ile gönderir; uzun bir kaydın ilk cümlelerini dosyanın tamamı bitmeden görürsünüz.

Canlı (Realtime API): speaches, OpenAI Realtime API'sini WebSocket üzerinden uygular. intent=transcription parametresiyle yalnızca yazıya çevirme moduna geçer, language parametresiyle dili sabitlersiniz. Belgelerine göre gerçek zamanlı performans ancak CUDA ile elde edilir. Whisper 30 saniyelik pencerelerle çalışan bir modeldir, akış için tasarlanmamıştır; gecikme modele, karta ve eşzamanlı oturum sayısına bağlıdır. Canlı altyazı kuracaksanız turbo ile başlayıp gerçekçi bir yük testiyle ölçün.

API ile ses kaydını yazıya dökme

Teslimde gelen adres ve API anahtarıyla, OpenAI SDK'sını kullanan her araç bu sunucuya bağlanır; yalnızca taban adresi değiştirirsiniz.

curl https://SUNUCU-ADRESINIZ/v1/audio/transcriptions \
  -H "Authorization: Bearer $API_ANAHTARI" \
  -F file=@toplanti.mp3 \
  -F model=Systran/faster-whisper-large-v3 \
  -F language=tr \
  -F response_format=text

Aynı istek Python'da, turbo modeli ve terim ipucuyla:

from openai import OpenAI

client = OpenAI(base_url="https://SUNUCU-ADRESINIZ/v1", api_key="API_ANAHTARI")
with open("cagri-kaydi.wav", "rb") as ses:
    dokum = client.audio.transcriptions.create(
        model="deepdml/faster-whisper-large-v3-turbo-ct2",
        file=ses,
        language="tr",
        prompt="iade kodu, kargo takip numarası, Bağcılar şubesi",
    )
print(dokum.text)

SRT ve VTT altyazı nasıl alınır?

response_format alanı text, json, verbose_json, srt ve vtt değerlerini alır. Videodan önce sesi ayırıp altyazı dosyası isteyin:

ffmpeg -i egitim-videosu.mp4 -vn -ac 1 -ar 16000 egitim-sesi.wav
curl https://SUNUCU-ADRESINIZ/v1/audio/transcriptions \
  -H "Authorization: Bearer $API_ANAHTARI" \
  -F file=@egitim-sesi.wav \
  -F model=Systran/faster-whisper-large-v3 \
  -F language=tr \
  -F response_format=srt > egitim-videosu.srt

Kelime düzeyinde zaman damgası için response_format=verbose_json ile birlikte timestamp_granularities[]=word gönderin; speaches bu alanı yalnızca verbose_json ile anlamlı sayar. Altyazıyı videoya gömmek ya da videoyu NVENC ile yeniden kodlamak için video transcoding rehberimize ve video işleme sayfamıza bakın. Türkçe konuşmayı İngilizce metne çevirmek için /v1/audio/translations uç noktasını large-v3 ile kullanın; README'ye göre turbo çeviri istendiğinde de metni özgün dilde döndürür.

Metni sese çevirme: Türkçe TTS isteği

Chatterbox sunucusunda voice alanı, web arayüzünden yüklediğiniz referans kaydın dosya adıdır; model metni bu sesle okur. Uzun metinler cümle sınırlarından parçalara bölünüp tek dosyada birleştirilir.

curl https://SUNUCU-ADRESINIZ/v1/audio/speech \
  -H "Authorization: Bearer $API_ANAHTARI" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "chatterbox",
    "input": "Merhaba, randevunuz yarın saat on dörtte. Değiştirmek için bire basın.",
    "voice": "egitmen-onayli.wav",
    "language": "tr",
    "response_format": "mp3"
  }' \
  -o duyuru.mp3

Çıktı wav, mp3 ya da opus olabilir. Chatterbox deposundaki öneriler şunlar: referans kaydın dili istekteki dille aynı olsun, yoksa çıktı referansın aksanını taşıyabilir (cfg_weight değerini 0'a çekmek bunu azaltır). Hızlı konuşan referanslarda cfg_weight değerini 0,3 civarına indirin, daha duygulu bir okuma için exaggeration değerini yükseltin. Bu ayarları web arayüzünden ya da sunucunun kendi /tts uç noktasından değiştirirsiniz; OpenAI uyumlu uç nokta kayıtlı varsayılanları kullanır. Depodaki örneklerde yaklaşık 10 saniyelik bir referans klip kullanılır; gürültüsüz ve tek kişinin konuştuğu bir kayıt seçin.

E-öğrenme seslendirmesinde metni bölüm bölüm üretip dinleyerek kontrol edin. Sayıları, kısaltmaları ve yabancı kelimeleri okunduğu gibi yazmak ("2026" yerine "iki bin yirmi altı") okunuşu sizin kontrolünüze bırakır.

Türkçe ses klonlama: izin ve filigran

Ses klonlama kullanışlı ama kötüye kullanıma açık bir özelliktir. Şu kurallarla çalışın:

  • Yalnızca yazılı izinle: Bir sesi klonlamadan önce sesin sahibinden yazılı ve amacı belli bir izin alın: hangi metinler, hangi kanallar, ne kadar süre. İzni referans kayıtla birlikte saklayın; izin geri alınırsa referans dosyayı ve üretilmiş sesleri silin.
  • Ses kişisel veridir: Kimliği belirlenebilir bir kişinin sesi kişisel veri sayılır. Çalışanların, müşterilerin ya da tanınmış kişilerin sesini izinsiz taklit etmeyin. Genel çerçeve KVKK rehberimizde; bu bölüm hukuki tavsiye değildir.
  • Perth filigranı: Chatterbox her çıktıya duyulmayan bir Perth filigranı ekler. Resemble AI'a göre filigran MP3 sıkıştırmasından ve yaygın düzenlemelerden sonra da korunur. Bir dosyanın Chatterbox çıktısı olup olmadığını perth kütüphanesindeki PerthImplicitWatermarker ile kontrol edebilirsiniz. Filigranı kapatmayın; filigran izin yerine geçmez.
  • Dinleyiciye açıklık: Sentetik sesle hazırlanan duyuru, ders ya da sesli yanıt (IVR) mesajlarında sesin yapay zeka ile üretildiğini belirtin.

Toplantı notu için dökümü özetlemek

Toplantı notu çıkaran bir akış iki adımdan oluşur: Whisper kaydı metne çevirir, bir dil modeli de bu metinden özet, kararlar ve sorumlusuyla aksiyon maddeleri çıkarır. Bellek yetiyorsa dil modelini aynı karta kurabilirsiniz; Ollama ile model seçimi ve kullanımı Ollama ve Open WebUI paket sayfasında anlatılıyor. Qwen3 8B int4'te 8K bağlamla 7,1 GB, gpt-oss-20b 13,5 GB ister; Whisper'la birlikte toplam yaklaşık 13,2 ve 19,6 GB eder. İkisi de 24 GB'lık RTX PRO 4000 ya da RTX 3090'a sığar, 32 GB'lık RTX 5090 daha fazla pay bırakır. Modelin bağlam penceresini aşan uzun dökümleri bölümlere ayırın; önce bölüm özetlerini, sonra genel özeti çıkarın. Birden çok konteyneri aynı GPU'da çalıştırmanın ayrıntıları Docker GPU rehberimizde.

Ne kurulmuyor ve neden?

Aşağıdakiler Türkçe konuşabilir ya da işe yarar, ama lisans veya erişim koşulları nedeniyle varsayılan kuruluma eklemiyoruz. Root erişiminiz olduğu için kendi lisans koşullarını kabul ederek kurabilirsiniz.

  • XTTS-v2 (Coqui): Türkçe destekler, ancak Coqui Public Model License 1.0.0 modelin ve çıktılarının yalnızca ticari olmayan amaçlarla kullanılmasına izin verir.
  • F5-TTS: Kodu MIT lisanslıdır, ancak önceden eğitilmiş ağırlıkları eğitim verisi Emilia nedeniyle CC-BY-NC lisanslıdır; ticari seslendirmede kullanılamaz.
  • Piper'ın Türkçe sesi (tr_TR-dfki): Model kartında eğitim verisinin lisansı CC BY-NC-SA 4.0 olarak geçer, yani ticari olmayan kullanımla sınırlıdır. speaches Piper'ı destekler, ama bu sesi indirmiyoruz.
  • pyannote speaker-diarization-community-1 (konuşmacı ayrımı): Lisansı CC-BY-4.0'dır ve ticari kullanıma izin verir. Ancak model Hugging Face'te koşul kabulüne bağlıdır: iletişim bilgilerinizi paylaşıp koşulları kendi hesabınızla kabul etmeniz gerekir, bu yüzden önceden indirmiyoruz. speaches'in yeni sürümlerinde (0.9 serisi) bulunan /v1/audio/diarization uç noktası bu modeli kullanır; model sayfasında koşulları kabul edip bir Hugging Face token'ıyla indirebilirsiniz. Ücretli precision-2 modeli ise pyannoteAI'ın sunucularında çalışır; kullanırsanız kayıtlarınız Türkiye dışına çıkar.

Kurulu yazılımlar ve lisanslar

Pakete yalnızca ticari kullanıma izin veren lisanslı yazılımları ve modelleri kurarız. Lisans koşullarına uymak, ürettiğiniz içerik ve uygulamanız için sizin sorumluluğunuzdadır.

Whisper + Chatterbox ses paketinde kurulu yazılımlar, görevleri ve lisansları
Yazılım Ne işe yarar? Lisans
speaches OpenAI uyumlu ses API'si: /v1/audio/transcriptions, SRT/VTT çıktısı, akışlı döküm ve Realtime API MIT
faster-whisper Whisper'ı CTranslate2 ile daha az bellekle çalıştıran konuşma tanıma motoru MIT
Whisper large-v3 Doğruluk öncelikli Türkçe konuşma tanıma modeli, 1.550M parametre (Systran CTranslate2 dönüşümü) MIT
Whisper large-v3-turbo Hız öncelikli konuşma tanıma modeli, 809M parametre (deepdml CTranslate2 dönüşümü) MIT
Chatterbox Multilingual Türkçe dahil 23 dilde metinden sese ve referans kayıttan ses klonlama; çıktıya Perth filigranı ekler MIT
Chatterbox-TTS-Server Chatterbox için web arayüzü ve OpenAI uyumlu /v1/audio/speech uç noktası MIT
Caddy HTTPS, erişim denetimi ve isteklerin speaches ile Chatterbox arasında yönlendirilmesi Apache-2.0

Whisper + Chatterbox ses için önerilen GPU'lar

Kurulum ücretsiz; fiyatlar GPU başına, aylık ve KDV hariçtir. Tek siparişte en fazla 8 GPU kiralayabilirsiniz.

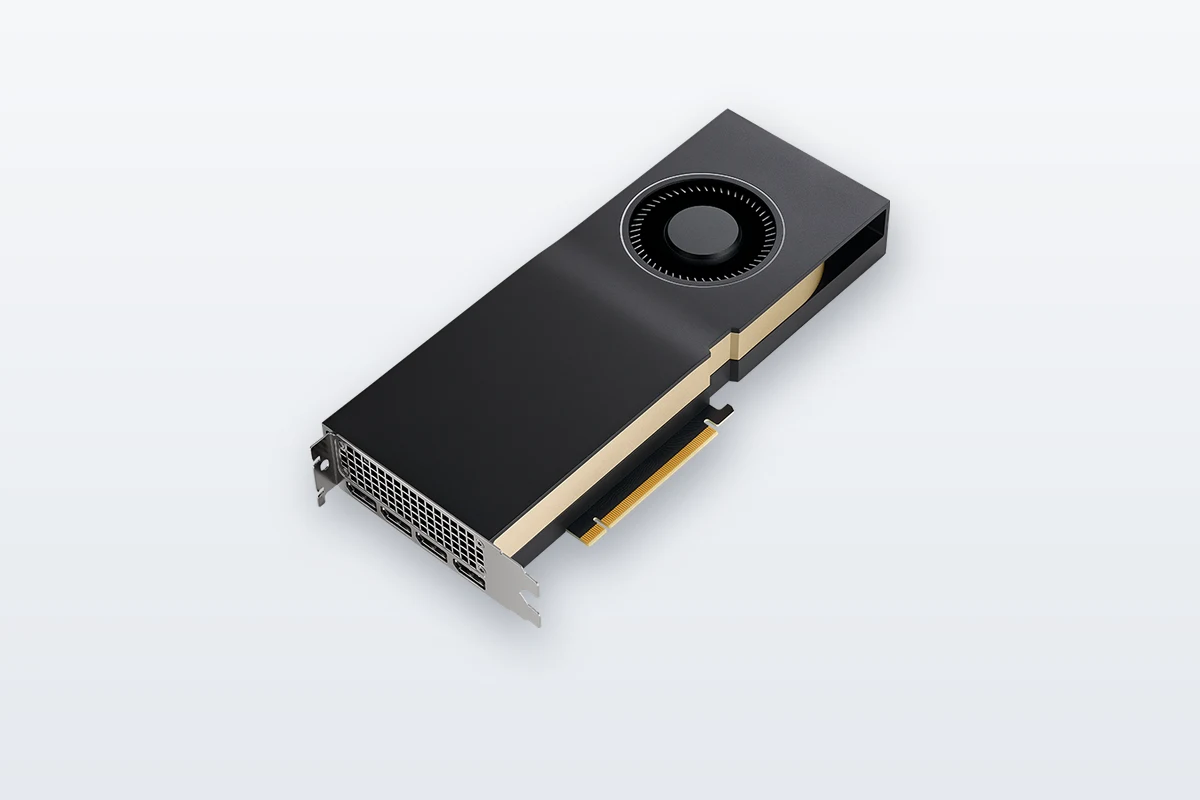
NVIDIA RTX PRO 4000 Blackwell ekran kartı

RTX PRO 4000

Blackwell

24 GB

Paylaşımsız · VPS değil

24 GB ECC'li GDDR7, FP4 desteği ve 145 W tek yuvalı tasarımla 14B–24B modeller, TTS ve görsel üretimi için profesyonel kart.

Bu paket için: 24 GB ECC'li GDDR7 bellek ve 145 W: döküm ve seslendirmenin yanında batch boyutunu büyütmeye ya da Qwen3 8B gibi küçük bir özet modeline yer kalır (dökümle birlikte yaklaşık 13,2 GB).

$450 / ay

GPU başına, KDV hariç · saatlik karşılığı $0,62

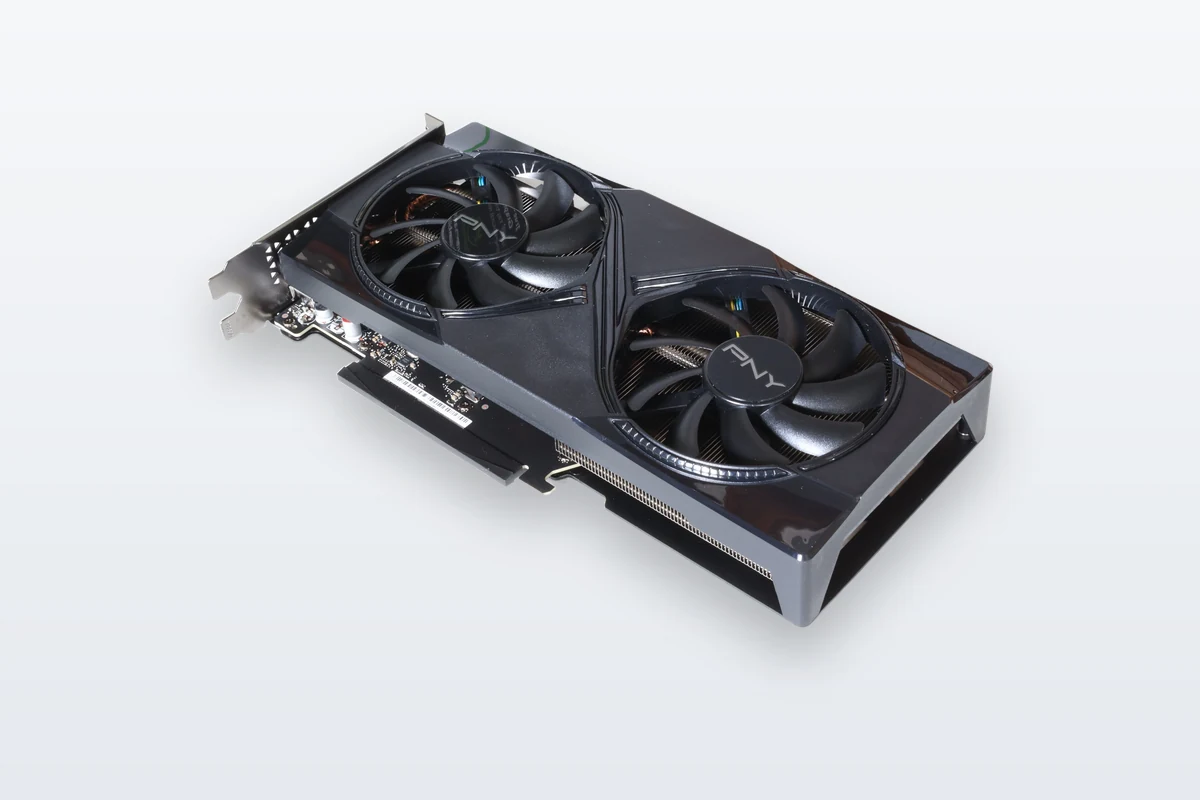
NVIDIA GeForce RTX 5060 Ti 16 GB ekran kartı

RTX 5060 Ti

Blackwell

16 GB

Paylaşımsız · VPS değil

Blackwell nesli, 16 GB GDDR7 ve FP4 desteğiyle TTS, Whisper, SDXL ve küçük dil modelleri için giriş kartı.

Bu paket için: 16 GB, Blackwell: Whisper ile Chatterbox'ı aynı kartta çalıştırmak için giriş seviyesi; küçük ekiplerin döküm ve seslendirme işine uygun.

$200 / ay

GPU başına, KDV hariç · saatlik karşılığı $0,27

NVIDIA RTX A5000 ekran kartı

RTX A5000

Ampere

24 GB

Paylaşımsız · VPS değil

24 GB ECC'li GDDR6 ve 768 GB/s bant genişliğiyle 7/24 LLM servisleri, TTS, Whisper ve görsel üretimi için profesyonel Ampere kartı.

Bu paket için: 24 GB ECC'li GDDR6 bellek, RTX 3090 ile aynı fiyat: kesintisiz çalışan çağrı merkezi döküm kuyruklarında bellek hatalarına karşı ek güvence; dökümün yanında küçük bir özet modeline de yer kalır.

$300 / ay

GPU başına, KDV hariç · saatlik karşılığı $0,41

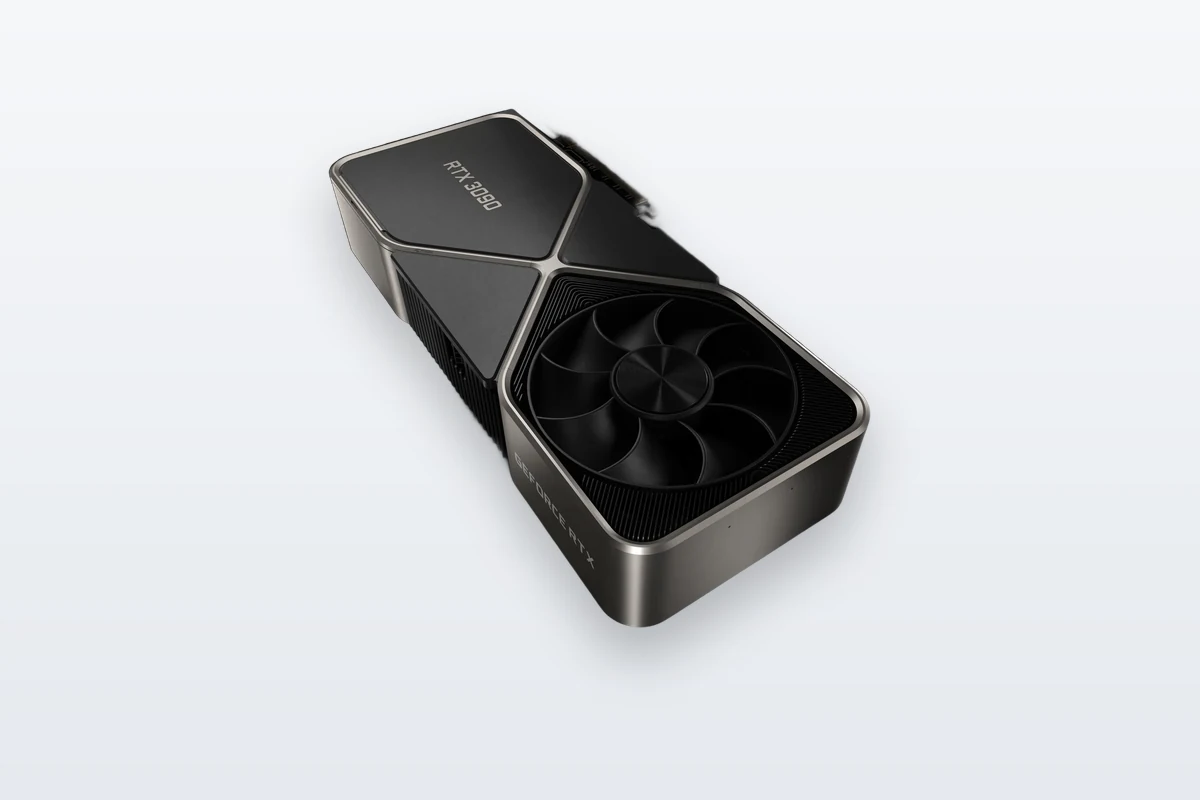
NVIDIA GeForce RTX 3090 ekran kartı

RTX 3090

Ampere

24 GB

Paylaşımsız · VPS değil

24 GB GDDR6X ve 936 GB/s bant genişliğiyle 24 GB'a sığan dil modelleri, SDXL ve FLUX, TTS için uygun fiyatlı kart.

Bu paket için: 24 GB: dökümün yanında gpt-oss-20b ile özet çıkarmak için yeterli; ikisi birlikte yaklaşık 19,6 GB ister.

$300 / ay

GPU başına, KDV hariç · saatlik karşılığı $0,41

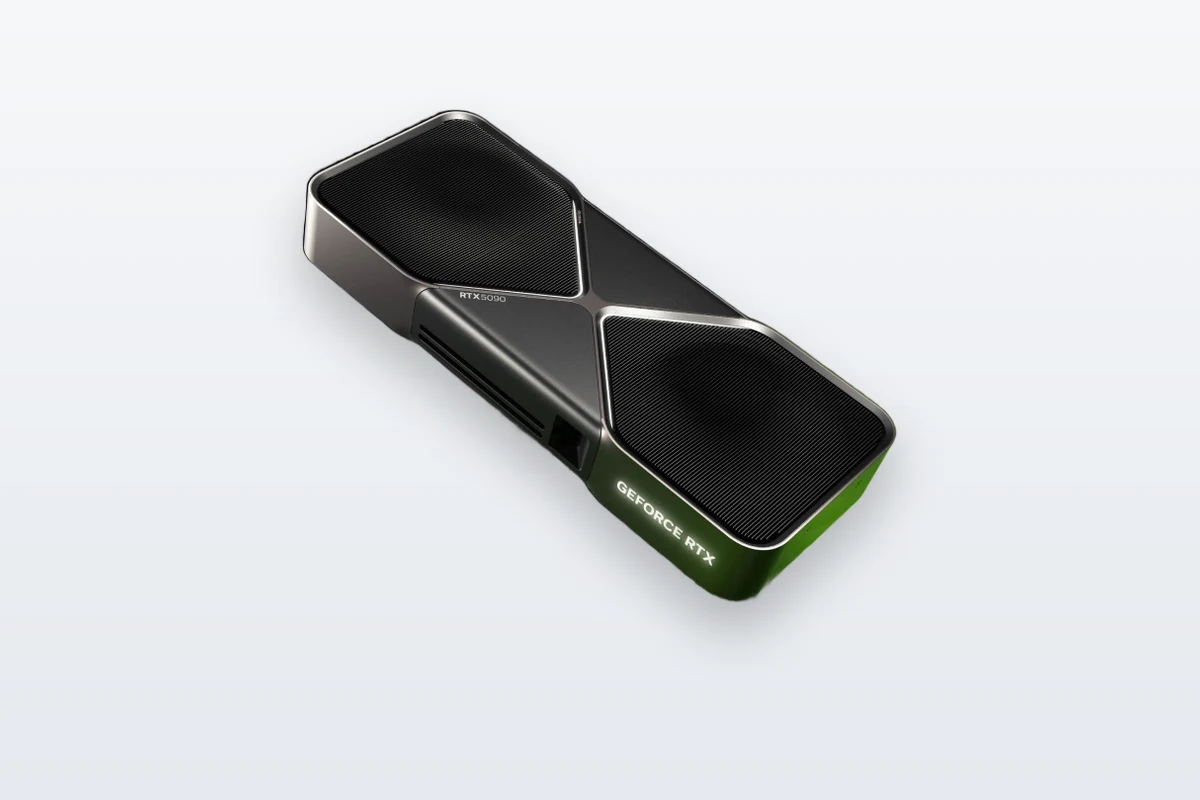
NVIDIA GeForce RTX 5090 ekran kartı

RTX 5090

Blackwell

32 GB

Paylaşımsız · VPS değil

32 GB GDDR7 ve 1,8 TB/s bant genişliği: 32 GB'a sığan LLM'ler, FLUX ve render için hızlı Blackwell kartı.

Bu paket için: 32 GB ve 1.792 GB/s bant genişliği: yüksek hacimli toplu döküm, eşzamanlı canlı oturumlar ve aynı kartta özet modeli için.

$600 / ay

GPU başına, KDV hariç · saatlik karşılığı $0,82

Bu paket en az 16 GB GPU belleği ister. Modeliniz kaç GB bellek ister? VRAM hesaplayıcı ile hesaplayın ya da tüm modelleri karşılaştırın.

Teslim ve erişim

Sipariş formunda GPU modeliyle birlikte Whisper + Chatterbox ses paketini seçersiniz; sunucu aşağıdaki gibi hazır teslim edilir.

  1. 1. Sistem ve sürücüler hazır Ubuntu 24.04 LTS, NVIDIA sürücüsü ve CUDA ile Docker ve NVIDIA Container Toolkit kurulu gelir.
  2. 2. Whisper + Chatterbox ses kurulu ve çalışır Paketin yazılımları /opt altında Docker Compose ile çalışır; seçtiğiniz modeller önceden indirilir. Teslimden önce kurulumu çalıştırıp kontrol ederiz.
  3. 3. HTTPS ve şifreyle erişim Arayüze size özel HTTPS adresinden şifreyle girersiniz; şifre, erişim e-postasından ayrı bir kanaldan iletilir. Model ve API portları dışarıya kapalıdır; API'ye anahtarla ya da SSH tüneliyle bağlanırsınız.
  4. 4. Root yetkisi sizde Sunucuya root SSH erişiminiz olur; yazılım ekleyip kaldırabilir, kurulumu dilediğiniz gibi değiştirebilirsiniz. Sunucuda kurulumu anlatan bir README ve güncelleme betiği bulunur.

Ücret ve teslim tarihi: kurulum ücretsizdir, aylık ek bedeli yoktur ve ödemeden sonra yazılı olarak bildirdiğimiz teslim tarihine dahildir. Paket seçmezseniz sunucu yalnızca işletim sistemi, sürücü ve CUDA ile teslim edilir.

Güncellemeler: kurulu açık kaynak yazılımları sonradan sunucudaki betikle siz güncellersiniz; takıldığınızda normal öncelikli destekle yardımcı oluruz. Bu yazılımlar aylık %99,5 erişilebilirlik hedefinin kapsamı dışındadır; hedef sunucuyu, ağı ve tesisi kapsar. Ayrıntılar SLA ve destek sayfamızda.

Bu paketin kullanıldığı işler

İlgili rehberler

Whisper + Chatterbox ses hakkında sık sorulan sorular

Whisper kaç GB VRAM ister, 16 GB kart yeter mi?

OpenAI'nin referans uygulamasında large-v3 yaklaşık 10 GB, turbo yaklaşık 6 GB ister; pakette kullanılan faster-whisper aynı boyuttaki modeli fp16'da 4,5 GB civarında çalıştırır. Bu yüzden 16 GB'lık bir kart, döküm ve Chatterbox seslendirmesiyle başlamak için yeterlidir. Giriş seviyesindeki RTX 5060 Ti'nin aylık fiyatı $200. Yanına bir özet modeli ekleyecekseniz 24–32 GB'lık kartlara bakın.

Whisper Türkçe destekliyor mu, sesi yazıya çevirmede ne kadar başarılı?

Evet, Türkçe Whisper'ın desteklediği diller arasındadır. Whisper makalesi large-v2 için Türkçe WER değerini FLEURS'ta %8,4, Common Voice 9'da %14,5 olarak raporlar; large-v3 bu modelin devamıdır. Bu veri kümeleri okunan cümlelerden oluştuğu için telefon kayıtlarında hata oranı daha yüksek çıkabilir. Kendi kayıtlarınızdan bir örneği elle düzeltip iki modeli karşılaştırmak daha güvenilir bir ölçüm verir.

Ses deşifre için OpenAI uyumlu bir API var mı?

Var. speaches, OpenAI'nin ses API'siyle aynı yapıdaki /v1/audio/transcriptions uç noktasını sunar; OpenAI SDK'larında taban adresi sunucunuza çevirmeniz yeterlidir. Çıktıyı düz metin, JSON, zaman damgalı verbose_json, SRT ya da VTT olarak alırsınız. Seslendirme istekleri de aynı adreste /v1/audio/speech ile çalışır.

Türkçe ses klonlama nasıl yapılır, yasal mı?

Chatterbox Multilingual, kısa ve temiz bir referans kayıttan o sesle Türkçe okuyabilir; referansı web arayüzünden yükleyip API isteğinde dosya adını voice alanına yazarsınız. Klonlayacağınız sesin sahibinden önceden yazılı izin almanız gerekir, çünkü ses kişisel veridir. Chatterbox çıktıları duyulmayan bir filigran taşır. Bu bilgi genel niteliktedir, hukuki tavsiye değildir.

Paket ücretli mi, Whisper ve Chatterbox için lisans ödemem gerekir mi?

Kurulum ücretsizdir ve pakete ek aylık ücret yoktur; yalnızca GPU sunucunun aylık kirasını ödersiniz. Kurulum tablosundaki bileşenler MIT ya da Apache-2.0 lisanslıdır, ayrı bir lisans ücreti çıkmaz. Örneğin RTX PRO 4000 aylık $450, yıllık planda aylık $360. Fiyatlar GPU başına ve KDV hariçtir.

Canlı bir toplantıyı gerçek zamanlı yazıya çevirebilir miyim?

speaches'in WebSocket tabanlı Realtime API'si yalnızca yazıya çevirme modunda çalıştırılabilir ve dil parametresi alır; dosya dökümünde de akışlı (SSE) çıktı vardır. Gecikme modele, karta ve eşzamanlı oturum sayısına bağlıdır, sabit bir değer veremeyiz. Canlı kullanım için turbo modeliyle başlayıp kendi ortamınızda test etmenizi öneririz.

Konuşmacı ayrımı (kim ne dedi) yapılabilir mi?

Varsayılan kurulumda konuşmacı ayrımı modeli yok. pyannote'un community-1 modeli CC-BY-4.0 lisanslıdır, ancak Hugging Face'te koşulları kendi hesabınızla kabul etmeniz gerektiği için önceden indirmiyoruz; indirdikten sonra speaches'in yeni sürümlerindeki diarization uç noktasıyla kullanılabilir. Çağrı kayıtlarınız stereo ise her kanalı ayrı çevirmek daha basit bir yoldur.

Toplantı notu çıkaran yapay zeka aynı sunucuda çalışır mı?

Bellek yetiyorsa evet. Dökümü Ollama ile çalışan bir dil modeline verip özet ve aksiyon maddeleri çıkarabilirsiniz; Qwen3 8B int4'te 8K bağlamla 7,1 GB, gpt-oss-20b ise 13,5 GB ister. Whisper'la birlikte ilki yaklaşık 13,2 GB, ikincisi 19,6 GB tutar; ikisi de 24 GB'lık kartlara sığar. Ayrıntılar için [Ollama ve Open WebUI paketine](/paketler/ollama-open-webui/) bakın.

Ses kayıtlarım nerede işlenir, yurt dışına çıkar mı?

Kayıtlar size ayrılmış sunucuda, Whisper ve Chatterbox ile yerel olarak işlenir; dışarıdaki bir konuşma tanıma API'sine gönderilmez. Sunucu İstanbul Bağcılar'daki kendi tesisimizde durur; kayıtlarınız ve dökümleriniz Türkiye'de kalır. KVKK açısından değerlendirme sizin veri işleme süreçlerinize bağlıdır; genel çerçeve için [KVKK rehberimize](/blog/kvkk-gpu-kiralama-turkiye/) bakın.

Son güncelleme: . Fiyatlar fiyat listemizden otomatik gelir.

Diğer hazır kurulu paketler

Tüm paketler →
Kurulum ücretsiz

Ollama + Open WebUI

Ollama, Open WebUI, HTTPS ve bge-m3 ile belge sohbeti kurulu olarak teslim edilen, size ayrılmış bir GPU sunucu. Çalışanlarınız şifreyle giriş yapıp gpt-oss, Qwen3, Gemma 4 ya da Türkçe modellerle sohbet eder; sunucu İstanbul'da çalışır, verileriniz Türkiye'de kalır.

Ollama Open WebUI Caddy bge-m3 (BAAI)

En az 16 GB GPU belleği

Kurulum ücretsiz

ComfyUI görsel üretimi

ComfyUI ve ticari kullanıma açık görsel modelleri (Z-Image-Turbo, FLUX.2 [klein] 4B, FLUX.1 [schnell], Qwen-Image-2512, Qwen-Image-Edit-2511, SDXL) kurulu, İstanbul'da paylaşımsız GPU sunucu. Görsel başına kredi yok: aylık sabit fiyatla tarayıcıdan parolalı HTTPS üzerinden ya da ComfyUI API'siyle üretirsiniz.

ComfyUI ComfyUI-Manager Caddy Z-Image-Turbo

En az 16 GB GPU belleği

Kurulum ücretsiz

vLLM OpenAI uyumlu API

gpt-oss, Qwen ve Mistral Small modellerini vLLM ile çalıştıran; LiteLLM ile uygulama başına API anahtarı, hız sınırı ve kullanım kaydı tutan; Caddy ile HTTPS'e açılan paylaşımsız GPU sunucu. İstanbul'daki tesisimizde kurulu teslim edilir, OpenAI SDK'sını kullanan kodunuzda çoğu zaman base_url'i değiştirmeniz yeter.

vLLM LiteLLM Proxy (açık kaynak çekirdek) PostgreSQL Caddy

En az 24 GB GPU belleği

Kurulum ücretsiz

Wan 2.2 video üretimi

Wan 2.2 ve ComfyUI kurulu, size ayrılmış bir GPU sunucuda metinden ve fotoğraftan yapay zeka videosu üretin. Kredi ya da saniye başına ücret yok: İstanbul'daki sunucu aylık sabit fiyatla çalışır, üretim miktarını yalnızca kartın hızı belirler.

ComfyUI ComfyUI-Manager Caddy Wan 2.2 TI2V-5B (fp16)

En az 24 GB GPU belleği

Kurulum ücretsiz

JupyterLab fine-tuning

Tarayıcıdan açılan JupyterLab içinde CUDA'lı PyTorch, Hugging Face Transformers, PEFT ve TRL, Unsloth, Axolotl ve görsel LoRA için ai-toolkit kurulu gelir. Sürücü ve ortam kurmadan, oturum süresi sınırı olmadan, İstanbul'daki size ayrılmış GPU'da LLM ve görsel model eğitin.

JupyterLab PyTorch (CUDA) Hugging Face Transformers PEFT

En az 16 GB GPU belleği

Whisper + Chatterbox ses kurulu sunucunuzu planlayalım

Hangi modeli ve kaç kullanıcıyı çalıştıracağınızı sipariş formuna yazın; uygun GPU'yu, kurulacak modelleri ve teslim tarihini birlikte netleştirelim.

Sipariş formuna git