LLM sunucusu kiralamak ne demek?
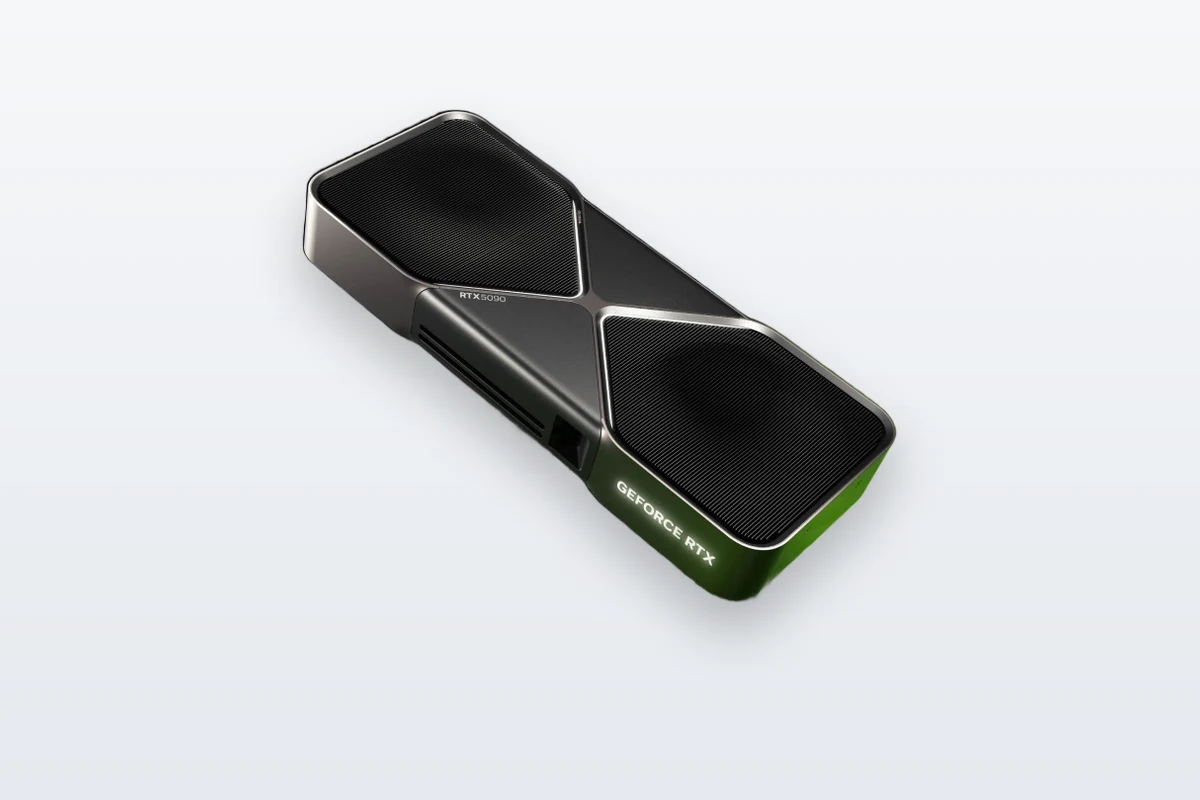
LLM sunucusu, açık ağırlıklı bir dil modelini vLLM, SGLang ya da Ollama ile çalıştırıp uygulamanıza OpenAI uyumlu bir API olarak sunan GPU sunucusudur. Bu sunucuyu aylık ve paylaşımsız olarak, İstanbul Bağcılar'daki kendi tesisimizde kiralıyoruz; veriler Türkiye'de kalır. FP8 ve 16 eşzamanlı istekte 8–14B modellere RTX 5090, 24–32B modellere 96 GB'lık RTX PRO 6000, 70B sınıfına 141 GB'lık H200 yeter.
Kapasiteyi üç etken belirler: modelin ve KV önbelleğinin belleğe sığması, tek isteğin hızını sınırlayan bellek bant genişliği ve aynı anda işlenecek istek sayısı. Örneğin Qwen3 32B, FP8 ağırlık ve FP8 KV önbelleğiyle, 8.192 token bağlamda 32 eşzamanlı istekte 69,8 GB'la tek RTX PRO 6000'e sığar; 70B sınıfı bir modeli aynı yükte tek kartta sunmak için H200 gerekir. Servis motoru olarak çoğu ekip için vLLM iyi bir başlangıçtır; geliştirme ve tek kullanıcı için Ollama yeterlidir.
- 8–14B modeller, 16 eşzamanlı isteğe kadar: RTX 5090 (32 GB), aylık $600. 32 istek ya da ECC'li bellek gerekiyorsa L40S (48 GB), aylık $900.
- 24–32B modeller ve gpt-oss-120b: RTX PRO 6000 (96 GB), aylık $1.600.
- Llama 3.3 70B FP8, 16–32 eşzamanlı istek: H200 (141 GB), aylık $3.000.
- Fiyatlar GPU başına, aylık, ABD doları cinsinden ve KDV hariçtir; yıllık kiralamada %20 indirim uygulanır.
Inference hızını ve kapasitesini ne belirler?
Model önce belleğe sığmalı; sığdıktan sonra tek isteğin hızını bant genişliği, aynı anda kaç isteğe hizmet verebileceğinizi ise KV önbelleğine kalan bellek belirler.
- Bellek: Ağırlıklar BF16'da parametre başına 2, FP8'de 1, 4-bit'te yaklaşık 0,5 bayt tutar. Llama 3.3 70B'nin FP8 ağırlıkları yaklaşık 70 GB'tır.
- Bant genişliği: Her yeni token için ağırlıklar bellekten yeniden okunur. Tek istekteki hızın teorik üst sınırı yaklaşık "bant genişliği ÷ ağırlık boyutu"dur: 70 GB'lık bir model için H200'de (4,8 TB/s) saniyede ~68, RTX PRO 6000'de (1,6–1,8 TB/s) ~23–26 token. Gerçek değerler bu sınırın altında kalır.
- KV önbelleği: Dikkat (attention) önbelleğinin toplam boyutu, bağlam uzunluğu ve eşzamanlı istek sayısıyla doğrusal büyür. Bağlamı 8.192'den 32.768 tokena çıkarmak KV önbelleğini dört katına çıkarır.
Eşzamanlı isteklerde toplam verim, tek isteğin hızının çok üzerine çıkar; çünkü motor istekleri aynı adımda birlikte işler (continuous batching). Gerçek kapasiteyi, ilk tokena kadar geçen süreyi (TTFT) ve token başına süreyi farklı eşzamanlılık düzeylerinde ölçerek bulursunuz. Yöntemi LLM inference optimizasyonu rehberimizde anlattık.
Kendi LLM API'niz için kaç GB VRAM gerekir?
FP8'de 14B bir model 16 eşzamanlı istekte yaklaşık 27 GB, 70B bir model yaklaşık 97 GB ister. Değerler VRAM hesaplayıcımızla hesaplandı: 8.192 token bağlam, FP8 KV önbelleği; kartın belleğinin %92'si kullanılabilir sayıldı.
Tablodaki "istek", aynı anda yanıt üretilen istektir; kayıtlı kullanıcı sayısı değildir. Üç not:
- Değerler her isteğin 8.192 tokenı tam doldurduğu durum içindir. vLLM KV önbelleğini sayfa sayfa ayırdığından kısa sohbetlerde aynı kart daha çok isteği taşır.
- gpt-oss modellerinde KV önbelleği küçüktür (120b'de 32 istekte 4,9 GB); eşzamanlılık belleği az etkiler.
- Qwen3.5 ve Qwen3.6'nın 27B modellerinde 64 katmanın yalnızca 16'sı KV önbelleği tutan tam dikkat katmanıdır, kalanlar doğrusal dikkat (Gated DeltaNet) kullanır. Bu modellerde KV önbelleği, tablodaki klasik mimarili modellere göre belirgin şekilde küçüktür.
LLM inference için hangi GPU kiralanmalı?
Seçimi önce belleğe, sonra bant genişliğine göre yapın.
RTX 5090 ile RTX PRO 6000 arasındaki farkları karşılaştırma sayfamızda, H100 ile farkları RTX PRO 6000 ve H100 karşılaştırmasında bulabilirsiniz.
Ne zaman H200? Llama 3.3 70B FP8 tek istekte 76,5 GB'la RTX PRO 6000'e sığar, ama 16 eşzamanlı istekte 96,6 GB'a çıkar ve iki kart ister. H200 aynı modeli 32 isteğe kadar tek kartta taşır; bant genişliği de RTX PRO 6000'in 2,7–3 katıdır. Uzun bağlamın sınırı H200'de de vardır: 32.768 tokenda 16 isteğin KV önbelleği yaklaşık 86 GB'a çıkar ve toplam ihtiyaç, tek H200'ün kullanılabilir belleğini (yaklaşık 129,7 GB) aşar. H100 ile H200 arasındaki bellek ve bant genişliği farkını H100 ve H200 karşılaştırmamızda anlattık.
Sunucuda hangi servis motorunu çalıştırmalısınız?
Ekim 2026 itibarıyla eşzamanlı kullanıcıya hizmet veren bir API için vLLM ya da SGLang, NVIDIA'ya özgü optimizasyonlar için TensorRT-LLM, geliştirme ve tek kullanıcı için Ollama ya da llama.cpp uygundur. Beşi de OpenAI uyumlu bir API (/v1/chat/completions) sunar; uygulamanızda yalnızca taban adresini (base URL) değiştirerek motor ya da model değiştirebilirsiniz.
vLLM mi, Ollama mı? Ollama her model için varsayılan olarak aynı anda tek bir isteği işler (OLLAMA_NUM_PARALLEL=1), diğerleri kuyrukta bekler; vLLM ise sayfalı KV önbelleği (PagedAttention) ve sürekli gruplamayla onlarca isteği aynı anda işler. Motorların sürümlerini, başlatma komutlarını ve hangi nicemlemenin hangi kartta çalıştığını vLLM, SGLang ve TensorRT-LLM karşılaştırmamızda topladık.
Nicemleme: FP8 altı kartımızın hepsinde çalışır ve ağırlık belleğini BF16'ya göre yarıya indirir; NVFP4 ise yalnızca Blackwell kartlarda (RTX PRO 6000, RTX 5090) yereldir. 4-bit'te Llama 3.3 70B tek istekte 45,4 GB'la tek H100'e sığar; kalite kaybını kendi değerlendirme setinizle ölçün. Yukarıdaki VRAM tablosu FP8 KV önbelleğiyle (--kv-cache-dtype fp8) hesaplandı; bu ayar KV belleğini BF16'ya göre yarıya indirir.
Docker: vLLM (vllm/vllm-openai) ve Ollama (ollama/ollama) resmi Docker imajlarıyla da çalışır; konteynere GPU vermek için önce NVIDIA Container Toolkit kurulumunu yapın. Docker yayınlanan portu varsayılan olarak tüm ağ arayüzlerine açar; API'yi ters vekil sunucunun arkasına alana kadar -p 127.0.0.1:8000:8000 biçimini kullanın.
Hugging Face TGI: Text Generation Inference bakım moduna alındı ve deposu 21 Mart 2026'da arşivlendi. README'si bunun yerine vLLM ve SGLang'ı öneriyor; yeni bir projeye TGI ile başlamayın.
Birden fazla GPU ve MIG ile nasıl ölçeklersiniz?
Model tek karta sığıyorsa her GPU'da ayrı bir kopya çalıştırıp istekleri dağıtın; sığmıyorsa modeli kartlara bölün.
- GPU başına bir kopya: GPU'lar arası iletişim yoktur, NVLink gerekmez; önüne bir yük dengeleyici koymanız yeter.
- Tensor paralellik (
--tensor-parallel-size): Modeli her katmanda böler ve her adımda iletişim ister; kartlar NVLink ile bağlıyken verimlidir. H100 ve H200'de NVLink bağlantısı kartın sürümüne ve sunucu yapılandırmasına bağlıdır; belirli bir topolojiyi garanti etmiyoruz, ihtiyacınızı sipariş formunda belirtin.
- Pipeline paralellik (
--pipeline-parallel-size): vLLM belgeleri NVLink'siz kartlarda (örnek olarak L40S verilir) tensor paralellik yerine bunu önerir. RTX PRO 6000, RTX PRO 5000, RTX 5090 ve L40S'te NVLink yoktur.
- Üst sınır: Tek siparişte en fazla 8 GPU kiralanabilir. DeepSeek V3/R1 FP8'de 706,1 GB'la 8 H200 ister. Ayrıntılar multi-GPU ve NVLink rehberimizde.
MIG (Multi-Instance GPU), RTX PRO 6000, RTX PRO 5000, H100 ve H200'ü donanım düzeyinde yalıtılmış bölümlere ayırır. Her bölüm ayrı bir GPU gibi görünür ve vLLM sürecine CUDA_VISIBLE_DEVICES=MIG-<UUID> ile verilir.
Sığma hesabında bölüm belleğinin %92'si kullanılabilir sayıldı; MIG düzenini sipariş sırasında belirtin. Aynı temel model üzerinde ince ayarlı birden çok LoRA adaptörünü de tek kopyada sunabilirsiniz (--enable-lora --lora-modules ad=yol); istemci adaptörü model alanıyla seçer. İnce ayar tarafı için LLM fine-tuning hizmetimize bakın.
Kendi LLM sunucunuzu kiralamak ne zaman mantıklı?
API'niz her gün ve günün büyük bölümünde trafik alıyorsa mantıklıdır; ayda birkaç saatlik denemeler için değil.
Mantıklı olduğu durumlar:
- Sürekli trafik: Aylık sabit fiyatta token başına ücret yoktur; kart dolana kadar fatura trafikle değişmez.
- Verinin Türkiye'de kalması: İstemler ve yanıtlar İstanbul Bağcılar'daki kendi tesisimizde, size ayrılmış GPU'da işlenir. Kişisel veri içeren istemleri yurt dışındaki bir API'ye göndermek KVKK'ya göre yurt dışına aktarımdır (KVKK ve GPU kiralama rehberi); uyum değerlendirmesi kendi veri işleme süreçlerinize bağlıdır.
- Öngörülebilir bütçe: Fatura, düzenlendiği günkü TCMB döviz satış kuruyla Türk lirası olarak kesilir.
Mantıklı olmadığı durumlar:
- Ara sıra kullanım: RTX PRO 6000'in aylık fiyatının saatlik karşılığı $2,19. Bunu saatlik bulut fiyatlarıyla karşılaştırın; kartı ayda yalnızca birkaç saat ya da birkaç gün kullanacaksanız saatlik bulut GPU daha ucuz olabilir.
- Çok dalgalı trafik: Saatlik kiralama ve otomatik ölçekleme sunmuyoruz; kapasiteyi en yoğun saate göre planlamanız gerekir.
- En zor görevler: En güçlü kapalı modeller (API'ler) karmaşık akıl yürütme ve kod gibi işlerde açık modellerden daha iyi sonuç verebilir; kendi değerlendirme setinizle karşılaştırın.
Şirket belgeleriyle çalışan bir asistan (RAG) kuruyorsanız kurumsal yapay zeka sayfamıza bakın.
Özet
- Önce belleği hesaplayın: 8.192 token ve FP8 KV önbelleğiyle Qwen3 32B 32 istekte 69,8 GB, Llama 3.3 70B 16–32 istekte 96,6–118,1 GB ister.
- Tek isteğin hızını bant genişliği sınırlar: 70 GB'lık bir modelde teorik üst sınır H200'de ~68, RTX PRO 6000'de ~23–26 token/s.
- Üretim API'si için vLLM ya da SGLang, geliştirme için Ollama kullanın; TGI arşivlendi.
- Sığan modeli her GPU'da kopyalayın, sığmayanı bölün; NVLink'siz kartlarda pipeline paralellik, tek kartta birden çok model için MIG.
- Aylık sunucu 7/24 trafik ve Türkiye'de kalması gereken veri için uygundur; ara sıra kullanımda saatlik bulut daha ucuz olabilir.
Kaynaklar