JupyterLab fine-tuning sunucusu nedir, ne işe yarar?
JupyterLab fine-tuning paketi, tarayıcıdan açılan hazır bir model eğitim ortamıdır: JupyterLab, CUDA destekli PyTorch, Hugging Face Transformers, PEFT ve TRL, Unsloth, Axolotl ve görsel LoRA için ostris ai-toolkit, İstanbul'daki size ayrılmış (paylaşımsız, VPS değil) bir GPU sunucusunda kurulu olarak teslim edilir. Sürücü, CUDA ya da Python ortamı kurmadan ilk notebook'unuzu açıp bir dil modeline LoRA veya QLoRA ince ayarı yapabilir, FLUX.1 schnell ya da SDXL için stil ve ürün LoRA'sı eğitebilirsiniz. Sunucular İstanbul Bağcılar'daki kendi tesisimizde çalışır, verileriniz Türkiye'de kalır. Colab'dakinin aksine oturum süresi sınırı yoktur: kart ay boyunca sizindir ve eğitim siz durdurana kadar sürer.
Sunucuda hangi araçlar kurulu, her biri ne işe yarar?
- JupyterLab: Notebook, terminal ve dosya yöneticisi aynı tarayıcı sekmesinde; veriyi sürükleyip bırakır, kodu hücre hücre denersiniz.
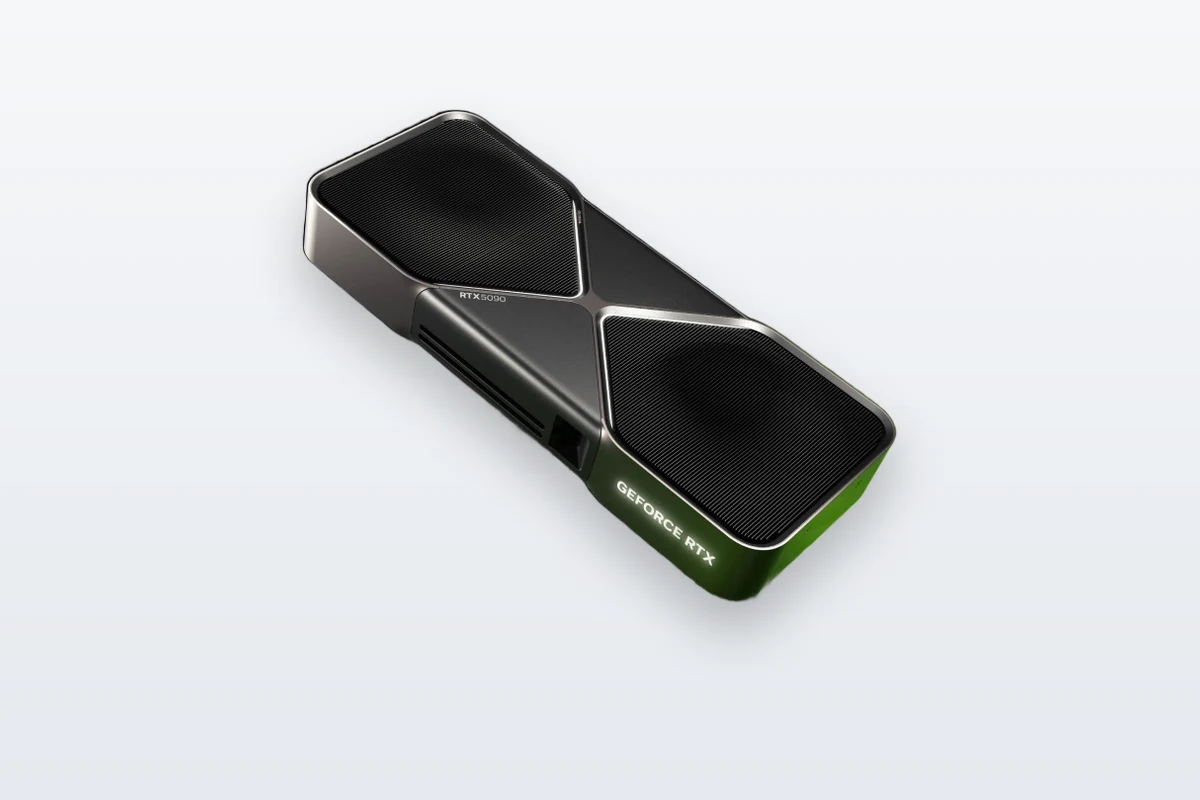
- PyTorch (CUDA derlemesi): Eğitimin GPU üzerinde koştuğu katman. Blackwell mimarili kartlar (RTX 5060 Ti, RTX 5090, RTX PRO serisi) güncel bir CUDA derlemesi ister; kurulum kartınıza uygun derlemeyle gelir.
- Transformers, PEFT, TRL ve bitsandbytes: Hugging Face'in eğitim yığını. Transformers modeli ve tokenizer'ı yükler, PEFT LoRA adaptörünü tanımlar, bitsandbytes ana modeli QLoRA için 4-bit NF4 biçiminde belleğe alır, TRL de SFT, DPO ve GRPO gibi eğitim döngülerini hazır sınıflar olarak sunar.
- Unsloth: Aynı yığına bellek ve hız optimizasyonları ekler; kurulumda Apache-2.0 lisanslı çekirdek kütüphane bulunur.
- Axolotl: Eğitimi kod yerine tek bir YAML dosyasıyla tanımlar.
- ostris ai-toolkit: Görüntü ve video difüzyon modelleri için LoRA eğitim aracı; web arayüzüyle ya da komut satırından çalışır.
- TensorBoard: Kayıp (loss) ve öğrenme oranı grafiklerini sunucunun kendi diskinde tutar.
- Caddy: JupyterLab ve ai-toolkit arayüzünü HTTPS üzerinden, parola korumasıyla erişime açan ters vekil sunucu.
Bu sayfa yazılırken (Ekim 2026) PyPI'daki güncel sürümler JupyterLab 4.6, PyTorch 2.14, Transformers 5.20, TRL 1.16 ve Axolotl 0.21 idi. Siparişte hangi temel modellerle çalışacağınızı yazarsanız (örneğin Qwen3 8B, gpt-oss-20b, FLUX.1 schnell) bunlar teslimden önce indirilir.
Bu sunucuda hangi eğitimleri yapabilirsiniz?
- LLM için LoRA ve QLoRA (SFT): Kendi soru-cevap, destek kaydı ya da yazışma örneklerinizle bir modelin üslubunu, çıktı biçimini veya alan terminolojisini değiştirmek. Hangi durumda ince ayarın, hangisinde RAG'in doğru araç olduğunu LLM fine-tuning hizmet sayfamızda anlattık.
- Tercih ve pekiştirmeli öğrenme: Axolotl DPO, KTO, ORPO ve GRPO'yu; TRL ve Unsloth DPO ve GRPO'yu destekler.
- Tam ince ayar (full fine-tuning): Tüm ağırlıkları eğitir; büyük kartlarda ve çok GPU ile yapılır.
- Görsel ve video LoRA: ai-toolkit; SDXL, FLUX.1 schnell, FLUX.2 klein base 4B, Z-Image, Z-Image Turbo, Qwen-Image ve Wan 2.2 dahil pek çok modeli destekler. Ürün, marka stili veya karakter LoRA'sı eğitip sonucu ComfyUI paketimizde kullanabilirsiniz.
Colab yerine neden kendi sunucunuz?
Google'ın Colab SSS'sine göre ücretsiz katmanda notebook'lar en fazla 12 saat çalışır, boşta kalan oturumlar kapanır ve GPU türleri zamanla değişir; Pro+ planında bile kesintisiz çalışma 24 saate kadardır. Burada çekirdek siz kapatana kadar çalışır, dosyalar diskte kalır ve kart değişmez. Ayrıntılı karşılaştırma için Google Colab mı, GPU kiralama mı? yazımıza bakın.
Fine-tuning için kaç GB VRAM gerekir, hangi GPU yeter?
Aşağıdaki LLM değerleri sitemizin VRAM hesaplayıcısından alındı; varsayım 2.048 token dizi uzunluğu, batch 1 ve açık gradient checkpointing. Toplam ihtiyaç kartın kullanılabilir belleğine (toplamın yaklaşık %92'si) sığıyorsa iş tek kartta çalışır.
Dizi uzunluğu ve batch büyüdükçe aktivasyon belleği hızla artar: Qwen3 8B QLoRA, 2.048 token ve batch 1'de 8,8 GB isterken 4.096 token ve batch 4'te 26 GB'a çıkar. Kendi senaryonuzu hesaplayıcının ince ayar modunda deneyin.
Görsel satırlar ai-toolkit deposundaki örnek ayar dosyalarının adlarından geliyor: FLUX.1 schnell, Qwen-Image ve Wan 2.2 14B için "24gb", Qwen-Image-Edit için "32gb" ayarı hazırlanmış; FLUX örnek ayarları 8-bit nicemleme kullanır. Görsel LoRA için 24 GB'ın altına inmemenizi öneririz.
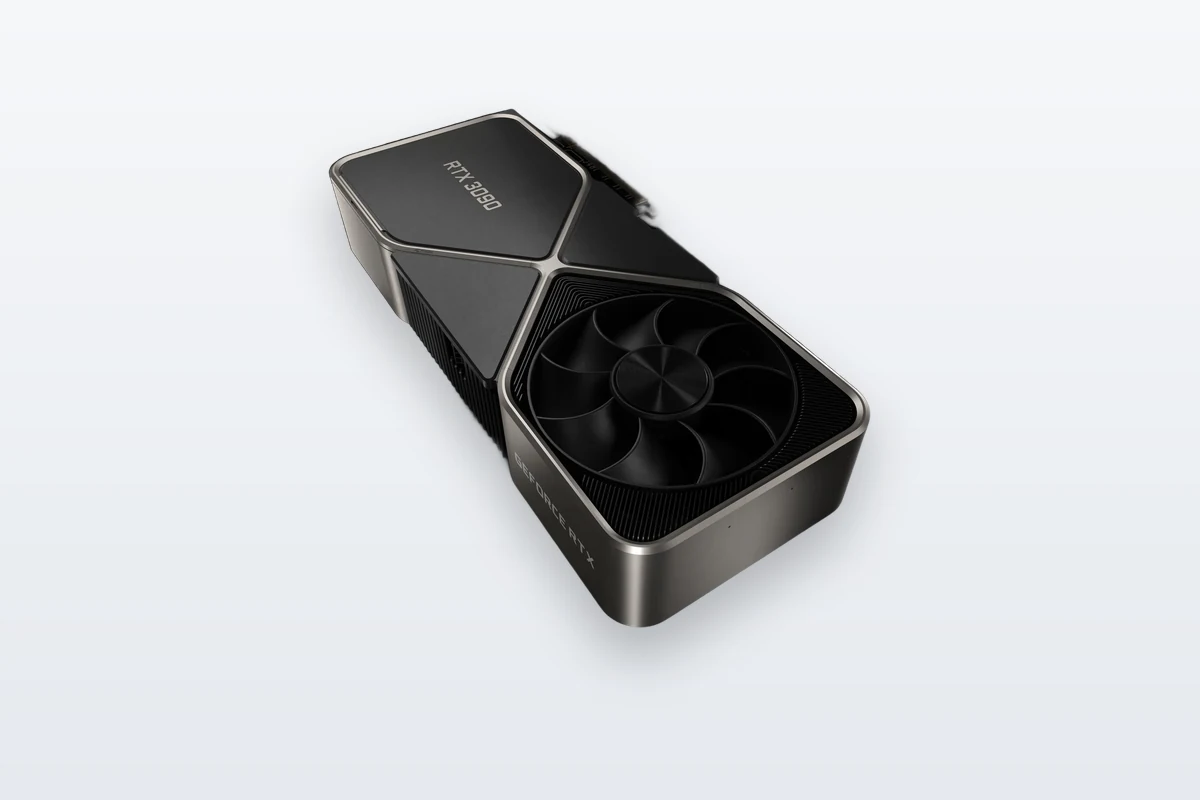
Fiyatlar GPU başına, aylık ve KDV hariçtir: 16 GB'lık RTX 5060 Ti aylık $200, 24 GB'lık RTX 3090 aylık $300, 32 GB'lık RTX 5090 aylık $600, 96 GB'lık RTX PRO 6000 aylık $1.600.
Unsloth mı, Axolotl mı, yoksa doğrudan TRL mi?
Üçü de Hugging Face yığınının üzerinde çalışır ve LoRA, QLoRA ile tam ince ayarı destekler; fark çalışma biçimindedir.
- Unsloth, kendi ölçümlerine dayanarak eğitimi 2 kata kadar hızlandırdığını ve VRAM kullanımını %70'e kadar azalttığını belirtir. Bu geliştiricinin beyanıdır; kendi verinizde ölçün.
- Axolotl aynı YAML dosyasını ön işleme, eğitim, değerlendirme ve nicemleme adımlarında yeniden kullanır. Anonim kullanım telemetrisi varsayılan olarak açıktır; kapatmak için
AXOLOTL_DO_NOT_TRACK=1 ortam değişkenini ayarlayın.
Pratik bir yol: notebook'ta Unsloth ya da TRL ile verinin küçük bir kısmında ayarları bulun, çalışan tarifi Axolotl YAML'ına taşıyıp tam veriyle terminalden koşun:
axolotl fetch examples
axolotl train examples/llama-3/lora-1b.yml
İlk QLoRA eğitimi nasıl yapılır?
TRL ile kısa bir örnek:
- JupyterLab içinde bir terminal açın ve
nvidia-smi ile kartı görün; notebook'ta torch.cuda.is_available() sonucu True olmalıdır.
- Verinizi JSONL olarak yükleyin. Her satır bir konuşmadır:
{"messages": [{"role": "user", "content": "..."}, {"role": "assistant", "content": "..."}]}
- Aşağıdaki hücreyi çalıştırın.
import torch
from datasets import load_dataset
from peft import LoraConfig
from transformers import BitsAndBytesConfig
from trl import SFTConfig, SFTTrainer

veri = load_dataset("json", data_files="veri/destek.jsonl", split="train")
bolum = veri.train_test_split(test_size=0.05, seed=42)

trainer = SFTTrainer(
    model="Qwen/Qwen3-8B",
    train_dataset=bolum["train"],
    eval_dataset=bolum["test"],
    quantization_config=BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=torch.bfloat16,
    ),
    peft_config=LoraConfig(r=16, lora_alpha=32, target_modules="all-linear", task_type="CAUSAL_LM"),
    args=SFTConfig(
        output_dir="cikti/qwen3-8b-destek",
        model_init_kwargs={"dtype": torch.bfloat16},
        max_length=2048,
        per_device_train_batch_size=1,
        gradient_accumulation_steps=8,
        learning_rate=1e-4,
        num_train_epochs=2,
        assistant_only_loss=True,
        eval_strategy="steps",
        eval_steps=100,
        report_to="tensorboard",
    ),
)
trainer.train()
trainer.save_model()
TRL belgelerine göre SFTTrainer konuşma biçimindeki veriye sohbet şablonunu kendisi uygular, assistant_only_loss=True ise kaybı yalnızca asistan cevaplarından hesaplar. Gradient checkpointing SFTConfig içinde varsayılan olarak açıktır. Hesaplayıcıya göre Qwen3 8B bu ayarlarla 8,8 GB ister, yani 16 GB'lık kartlarda çalışır. Eğitim saatler sürecekse kodu bir .py dosyasına alıp terminalden nohup python egit.py > egit.log 2>&1 & ile başlatın; tarayıcı kapansa da iş sürer ve çıktı dosyaya yazılır.
Türkçe veri setleriyle çalışırken nelere dikkat etmeli?
- Temizlik: Tekrar eden kayıtları ve kopyala-yapıştır şablon cevapları ayıklayın; az ama temiz örnek, çok ama gürültülü örnekten genellikle daha çok işe yarar.
- Unicode ve büyük-küçük harf: PDF'ten ya da farklı işletim sistemlerinden gelen metinlerde "ş", "ğ" gibi harfler ayrışık (NFD) gelebilir;
unicodedata.normalize("NFC", metin) ile birleştirin. Metni küçük harfe çevirmekten kaçının: Python'un str.lower() işlevi Türkçe kuralını uygulamaz, "ISPARTA".lower() sonucu "isparta" olur, "İSTANBUL".lower() ise noktalı i'yi iki karaktere böler.
- Kişisel veri: TC kimlik numarası, telefon, e-posta ve müşteri adlarını eğitimden önce maskeleyin; ince ayarlı bir model eğitim verisinden parçaları geri üretebilir. Hukuki çerçeve için KVKK ve GPU kiralama yazımıza bakın; verinin mevzuata uygun işlenmesi veri sorumlusu olarak sizin sorumluluğunuzdadır.
- Tokenizasyon: Türkçe eklemeli bir dildir; ağırlıklı olarak İngilizce metinle eğitilmiş tokenizer'lar Türkçe kelimeleri daha çok parçaya bölebilir. Daha çok token daha çok bellek ve süre demektir; kendi verinizde ölçüp
max_length değerini buna göre seçin.
- Değerlendirme: Verinin bir kısmını (örneğin %5) eğitime hiç sokmayın; ince ayarlı modeli aynı sorularla temel modelin yanında deneyin ve cevapları alanı bilen biri okusun. Genel bilgide gerileme var mı diye TurkishMMLU gibi Türkçe kıyaslama setlerine bakabilirsiniz. Kazanım veriye, modele ve ayarlara bağlıdır; bu yüzden burada sonuç rakamı vermiyoruz.
Token oranını ölçmek için:
from transformers import AutoTokenizer
tok = AutoTokenizer.from_pretrained("Qwen/Qwen3-8B")
metin = "Siparişimin kargoya verilip verilmediğini nereden öğrenebilirim?"
print(len(metin.split()), "kelime,", len(tok(metin)["input_ids"]), "token")
Veri seti bir klasördür: her görselin yanında, aynı adı taşıyan bir .txt dosyasında açıklaması (caption) bulunur; jpg, jpeg ve png desteklenir. Görselleri kırpmanıza gerek yoktur, araç onları küçültüp en-boy oranına göre gruplar. Durdurulan eğitim son kayıttan (checkpoint) devam eder; yalnızca kayıt yazılırken durdurmayın, dosya bozulabilir.
- FLUX.1 schnell: Adım damıtması yapılmış bir model olduğundan ai-toolkit eğitimde Apache-2.0 lisanslı bir yardımcı adaptör (
ostris/FLUX.1-schnell-training-adapter) kullanır. Modelin kendisi de Apache-2.0 lisanslıdır; eğitim görsellerinin hakları sizde olduğu sürece sonuç LoRA'yı ticari işte kullanabilirsiniz.
- Z-Image Turbo: Yine Apache-2.0 lisanslı bir eğitim adaptörüyle eğitilir. Adaptörün model kartına göre bu yöntem stil, kavram ve karakter gibi kısa eğitimler için uygundur; çok uzun eğitimlerde damıtma bozulur ve görüntüde artefaktlar görülebilir.
- SDXL: CreativeML Open RAIL++-M lisansı ticari kullanıma izin verir; lisanstaki kullanım kısıtları LoRA'nız için de geçerlidir.
FLUX.1 dev uyarısı: ai-toolkit'in varsayılan FLUX örneği FLUX.1 dev'i kullanır. FLUX.1 dev Non-Commercial License ince ayarlı sürümleri "Derivative" sayar ve modele ilişkin kısıtları onlara da uygular. Yani FLUX.1 dev üzerinde eğittiğiniz LoRA'yı, Black Forest Labs'ten ayrı lisans almadan gelir getiren bir işte kullanamazsınız. Ticari iş için FLUX.1 schnell, FLUX.2 klein base 4B veya Z-Image ile başlayın.
Jupyter'i internete açmak güvenli mi?
Jupyter Server belgeleri bunu açıkça söyler: sunucuya erişim, üzerinde istediği kodu çalıştırma yetkisi demektir. Bu yüzden token ile kimlik doğrulama varsayılan olarak açıktır ve erişim başka bir katmanda kısıtlanmıyorsa kapatılması önerilmez. Bu pakette:
- JupyterLab internete açık bir portta dinlemez; dışarıdan yalnızca Caddy'nin HTTPS adresinden, parolayla açılır.
- ai-toolkit arayüzü de Caddy arkasındadır ve ayrıca
AI_TOOLKIT_AUTH erişim belirteci ister.
- TensorBoard'da oturum açma ekranı yoktur; bu yüzden yalnızca sunucunun içinden (127.0.0.1) dinler, ona SSH tüneliyle bakarsınız:
ssh -L 6006:127.0.0.1:6006 root@sunucu-adresiniz
Jupyter'i token'ı boş bırakıp tüm ağ arayüzlerinde dinleyecek şekilde yeniden başlatmayın, Hugging Face token'ınızı da notebook hücresine düz metin olarak yazmayın. JupyterLab tek kullanıcılıdır; Jupyter belgeleri, aynı sunucuyu birden çok kişi kullandığında komutların birbirini ezebileceği uyarısını yapar. Ekip için JupyterHub'ı (BSD-3-Clause) root yetkinizle kurabilirsiniz. SSH tüneli, token ve parola ayarı için Jupyter bulut GPU rehberimize bakın.
Birden fazla GPU ile eğitim nasıl yapılır?
Notebook çekirdeği tek bir süreçtir, DDP ve FSDP ise her GPU için ayrı süreç ister; çok kartlı eğitimi terminalden accelerate launch ya da torchrun ile başlatın. Axolotl'un çok GPU belgeleri FSDP'yi önerir ve DeepSpeed ZeRO 1–3 aşamalarını da destekler: axolotl fetch deepspeed_configs hazır ayar dosyalarını indirir, YAML'a deepspeed: deepspeed_configs/zero1.json satırını eklemek yeterlidir.
Tek siparişte 8 GPU'ya kadar alabilirsiniz. Tam ince ayarda Qwen3 32B (529,7 GB) 8 × H100 ister; Llama 3.3 70B ise 1.137 GB ile 8 × H200'e bile sığmaz (8 × 129,7 = 1.037,6 GB kullanılabilir). Bu boyutta QLoRA veya LoRA ile kalın. Ölçekleme verimini ve NCCL ayarlarını çoklu GPU eğitim rehberimizde anlattık.
Eğittiğiniz modeli nasıl kullanıma açarsınız?
Servis yazılımları bu pakette kurulu değildir; aynı sunucuya kendiniz kurabilir ya da hazır kurulu bir paket seçebilirsiniz.
vLLM ile OpenAI uyumlu API: LoRA adaptörü temel modelle birleştirilmeden sunulur; istekte "model": "destek" yazmanız yeterlidir. Hazır kurulu sürümü vLLM OpenAI API paketidir.
vllm serve Qwen/Qwen3-8B --enable-lora --lora-modules destek=cikti/qwen3-8b-destek
Ollama ile sohbet: Unsloth ve Axolotl (axolotl export) modeli GGUF olarak dışa aktarabilir; Ollama'da FROM ./model.gguf satırlı bir Modelfile ve ollama create destek-asistani ile içe aktarırsınız. Bkz. Ollama + Open WebUI paketi.
Görsel LoRA: ComfyUI'da LoRA yükleyici düğümüyle kullanılır.
Hugging Face Hub'a yükleme TRL'de (push_to_hub) ve ai-toolkit örnek ayarlarında varsayılan olarak kapalıdır; modeliniz siz göndermedikçe sunucudan çıkmaz.
Ne kurulmuyor ve neden?
Root yetkiniz olduğu için aşağıdakileri kendi lisans koşullarını kabul ederek kurabilirsiniz; biz varsayılan olarak kurmuyor ve indirmiyoruz:
- FLUX.1 dev ve FLUX.1 Kontext dev ağırlıkları: FLUX.1 dev Non-Commercial License; üzerlerinde eğitilen LoRA'lar da türev sayılır.
- FLUX.2 dev ve FLUX.2 klein 9B: ticari olmayan lisans (FLUX.2 klein base 4B ise Apache-2.0'dır).
- Stable Diffusion 3.5: Stability Community License; gelir sınırı ve ek koşullar içerir.
- LTX-2 video modelleri: lisansında gelir eşiği bulunur.
- Unsloth Studio arayüzü: AGPL-3.0; ağ üzerinden sunulan değiştirilmiş sürümler için kaynak kodu paylaşma yükümlülüğü getirir. Çekirdek kütüphane kuruludur.
- Weights & Biases: Kendi hesabınızla kullanılan bir SaaS hizmetidir; açarsanız metrikler ve ayarlar W&B sunucularına gider. İsterseniz
pip install wandb ile kurup report_to="wandb" kullanırsınız; TensorBoard ise her şeyi sunucuda tutar.
- Llama modelleri: Hugging Face'te kapılıdır (gated); Meta lisansını kendi hesabınızla kabul edip kendi token'ınızla indirirsiniz.