vLLM nedir, kendi OpenAI uyumlu LLM API sunucunuz ne işe yarar?
vLLM, açık ağırlıklı dil modellerini aynı anda çok sayıda isteğe yanıt verecek şekilde çalıştıran, Apache-2.0 lisanslı bir LLM servis motorudur ve OpenAI API'siyle uyumlu uç noktalar sunar. vLLM OpenAI API paketinde vLLM, LiteLLM proxy ve Caddy, İstanbul'daki paylaşımsız GPU sunucunuza kurulu olarak gelir; gpt-oss, Qwen ya da Mistral Small modeliniz HTTPS üzerinden, uygulama başına API anahtarıyla erişilen kendi LLM API'nize dönüşür. OpenAI SDK'sını kullanan bir üründe ya da şirket içi uygulamada çoğu zaman yalnızca base_url, API anahtarı ve model adı değişir.
Pakette neler kurulu, bir istek hangi yoldan geçer?
- Caddy 443 numaralı portta HTTPS bağlantısını karşılar, TLS sertifikasını kendisi alır ve yeniler.
- LiteLLM proxy isteğin API anahtarını ve o anahtarın sınırlarını denetler, kullanımı kaydeder ve isteği doğru vLLM sürecine iletir; anahtarlar ve kayıtlar yanındaki PostgreSQL veritabanında durur.
- vLLM (Ekim 2026 itibarıyla 0.32 sürümü) modeli GPU'da çalıştırır ve yanıtı token token üretir.
vLLM'in portunu dışarı açmamamızın somut bir nedeni var. vLLM'in kendi --api-key seçeneği, belgesine göre yalnızca /v1, /v2 ve /inference ile başlayan yolları korur; aynı sunucudaki diğer uç noktalar kimlik doğrulaması istemez. Bu yüzden vLLM'e yalnızca sunucunun içinden (Docker iç ağı ve 127.0.0.1) erişilir, dışarıdan gelen istekler LiteLLM ve Caddy'den geçer. Bakım ya da ölçüm için vLLM'e SSH tüneliyle bağlanabilirsiniz.
Sunucu paylaşımsızdır, VPS değildir: GPU'lar yalnızca sizin isteklerinizi işler. Sunucular İstanbul Bağcılar'daki kendi tesisimizde çalışır, verileriniz Türkiye'de kalır.
vLLM aynı anda çok kullanıcıya nasıl hizmet verir?
Bir dil modeli, ürettiği her yeni token için önceki tokenların dikkat (attention) anahtar ve değerlerini bellekte tutar; buna KV önbelleği denir. Eski sistemlerde bu önbellek her istek için bitişik bir blok olarak ayrıldığından belleğin önemli kısmı parçalanmayla boşa gidiyordu. vLLM ekibinin PagedAttention makalesi, KV önbelleğini işletim sistemlerindeki sanal bellek sayfaları gibi küçük bloklara bölerek bu israfı neredeyse sıfıra indirdiğini ve aynı gecikme düzeyinde verimi FasterTransformer ve Orca gibi sistemlere göre 2–4 kat artırdığını raporlar.
İkinci parça sürekli gruplamadır (continuous batching). vLLM bir grubun tamamının bitmesini beklemez: her adımda yanıtı biten isteği gruptan çıkarır, kuyruktaki yeni isteği alır. Bunlara önek önbelleği (prefix caching) ve parçalı ön doldurma (chunked prefill) eklenir: aynı sistem istemiyle başlayan isteklerde ortak kısım yeniden hesaplanmaz, uzun bir belge gönderen kullanıcı diğerlerinin yanıt akışını uzun süre bekletmez.
Pratik sonucu şudur: kapasiteyi kayıtlı kullanıcı sayısı değil, aynı anda yanıt üretilen istek sayısı ve bağlam uzunluğu belirler. Hız modele, bağlama ve istem yapısına göre çok değiştiği için burada token/s rakamı vermiyoruz; gerçek kapasiteyi kendi istemlerinizle vllm bench serve komutuyla ölçün.
vLLM mi, Ollama mı?
İkisi de OpenAI uyumlu bir API sunar ama farklı işler için tasarlanmıştır. Ollama'nın belgelerine göre OLLAMA_NUM_PARALLEL varsayılan olarak 1'dir; her model aynı anda bir isteği işler, diğerleri kuyrukta bekler. vLLM ise baştan çok sayıda isteği aynı adımda işlemek için kurulmuştur.
Ekibiniz modelle tarayıcıdan sohbet edecek ve aynı anda az sayıda istek gelecekse Ollama + Open WebUI paketi daha az ayarla iş görür. Bir ürün, müşteri destek botu ya da birden çok iç uygulama aynı modeli kullanacaksa bu paket daha uygundur. vLLM'i SGLang ve TensorRT-LLM ile karşılaştırdığımız ayrıntılı yazı LLM inference optimizasyonu rehberimizde.
Hangi model için hangi GPU yeterli?
Aşağıdaki değerler VRAM hesaplayıcımızdan alındı ve ağırlıkları, KV önbelleğini ve çalışma payını kapsar. Kartın belleğinin %92'si kullanılabilir sayıldı: 24 GB kartta 22,1 GB, 48 GB'ta 44,2 GB, 80 GB'ta 73,6 GB, 96 GB'ta 88,3 GB, 141 GB'ta 129,7 GB. 8K × 1 sütununda KV önbelleği BF16, diğer iki sütunda FP8'dir.
* gpt-oss modelleri MXFP4 ağırlıklarla yayımlanır; FP8'e çevirmek gerekmez, bu sütun yalnızca karşılaştırma içindir. 32K × 4 ile 8K × 16 aynı toplam token sayısına (131.072) denk geldiğinden gpt-oss'ta 16 eşzamanlı 8K istek, int4 sütunundaki belleği ister: 20b'de 15,0 GB, 120b'de 72,4 GB.
Değerler, her isteğin bağlamı tam doldurduğu en kötü durumu gösterir. vLLM KV önbelleğini kullanıldıkça ayırdığından kısa sohbetlerde aynı kart daha çok isteği taşır. Kendi yükünüzü hesaplamak için hesaplayıcıda örneğin Mistral Small 3.2, FP8, 8K × 16 ayarından başlayın.
Qwen3.8 ve Qwen3.6 için bellek
Hesaplayıcıdaki Qwen satırları Qwen3 kuşağıdır; Qwen3 14B FP8'i RTX 5090 için kuruyoruz. Daha büyük kartlarda kurduğumuz yeni modeller Qwen3.8-27B (Ağustos 2026) ve Qwen3.6-35B-A3B'dir (Nisan 2026); ikisi de Apache-2.0 lisanslıdır ve Qwen'in resmi FP8 sürümleriyle gelir. Qwen3.8-27B-FP8 deposundaki ağırlık dosyaları 30,9 GB'tır. Model kartına göre 64 katmanın yalnızca 16'sı klasik dikkat katmanıdır, kalan 48'i Gated DeltaNet doğrusal dikkat katmanıdır; KV önbelleği yalnızca bu 16 katmanda bağlamla birlikte büyür. Bu nedenle eşzamanlı istek arttıkça bellek ihtiyacı, tablodaki Qwen3 32B'ye göre çok daha yavaş artar.
Pratikte Qwen3.8-27B FP8, RTX 5090'ın kullanılabilir 29,4 GB'ına sığmaz. L40S'te ağırlıklardan sonra KV önbelleği için yaklaşık 13 GB kalır; uzun bağlam ve yoğun eşzamanlılık için RTX PRO 6000 daha rahattır. Toplam 35 milyar parametreli Qwen3.6-35B-A3B'de FP8 ağırlıklar daha büyük olduğundan bu model için RTX PRO 6000 ya da H100 öneriyoruz. İki model de varsayılan olarak düşünme (thinking) modunda yanıt verir; kısa yanıt isteyen işlerde model kartı düşünmeyi istek başına kapatmayı (enable_thinking: false) anlatır.
gpt-oss-120b sistem gereksinimleri: kaç GB VRAM gerekir?
gpt-oss-120b, toplam 117 milyar parametreli, token başına 5,1 milyarı etkin olan bir MoE modelidir; OpenAI ağırlıkları MXFP4 biçiminde ve Apache-2.0 lisansıyla yayımladı. Resmi model kartı, modelin tek bir 80 GB GPU'ya (örnek olarak NVIDIA H100) sığdığını yazar ve bu doğrudur: Hugging Face'teki ağırlık dosyaları yaklaşık 65 GB'tır.
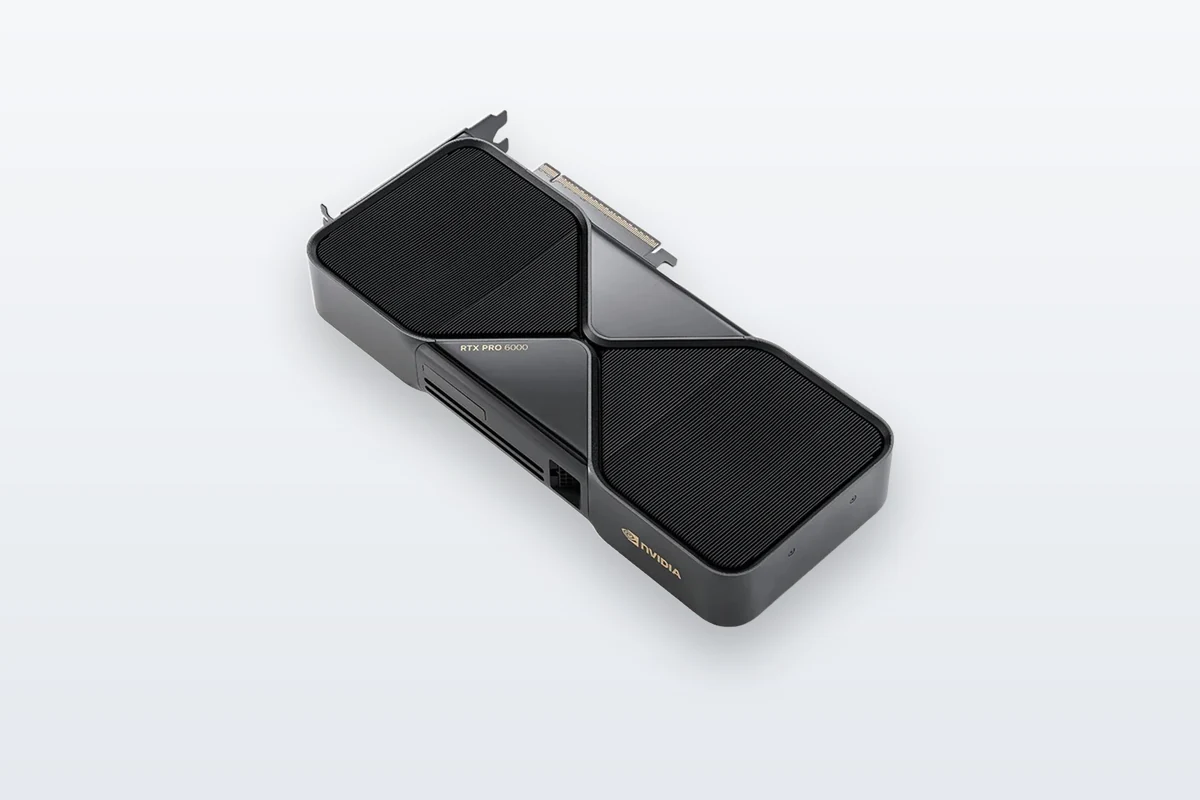
Sığmak ile rahat çalışmak ise farklıdır. Hesabımızda 8K bağlamlı tek istek 70,3 GB, 32K × 4 ya da 8K × 16 yük 72,4 GB ister. H100'ün kullanılabilir belleği bu hesapta 73,6 GB olduğundan geriye yalnızca 1 GB kadar pay kalır. vLLM'in gpt-oss tarifi de tek H100'de varsayılan ayarlarla bellek yetersizliği (CUDA out of memory) hatası alınabileceğini yazar ve --gpu-memory-utilization 0.95 --max-num-batched-tokens 1024 önerir; ikinci ayar bir adımda işlenen token sayısını düşürür. Bu yüzden gpt-oss-120b'yi 96 GB ve üzeri kartlarda sunuyoruz:
- RTX PRO 6000 (96 GB): 88,3 GB kullanılabilir bellekte 72,4 GB'lık yükten sonra yaklaşık 16 GB pay kalır; bu pay daha uzun bağlama ya da daha çok eşzamanlı isteğe gider. vLLM tarifi Blackwell kartlarda FP8 KV önbelleği (
kv-cache-dtype: fp8) kullanır. Aylık fiyatı $1.600, yıllık planda aylık $1.280 (GPU başına, KDV hariç).
- H200 (141 GB): 129,7 GB kullanılabilir bellekte yaklaşık 57 GB pay kalır; uzun belgelerle çalışan uygulamalar ve yoğun eşzamanlılık için uygundur.
- 2 × H100: Tarifteki
--tensor-parallel-size 2 ile model iki karta bölünür; tarif bu durumda bellek kullanım oranını 0,95'in altında tutmayı önerir. İki kartın farkları için RTX PRO 6000 ve H100 karşılaştırmamıza bakın.
Donanım desteğiyle ilgili bir not: vLLM tarifi H100, H200 ve B200'ü destekli donanım olarak sayar; Ampere, Ada ve RTX 5090 için çalışmanın sürdüğünü belirtir. Bu listede olmayan kartlarda (ör. L40S, RTX 5090, RTX PRO 6000 ve RTX PRO 4000) gpt-oss'u kurarken modeli kartınızda başlatıp API'nin yanıt verdiğini teslimden önce kontrol ederiz. gpt-oss yalnızca OpenAI'ın harmony yanıt biçimiyle doğru çalışır, vLLM bu biçimi kendisi uygular; akıl yürütme düzeyi düşük, orta ve yüksek olarak ayarlanabilir. Kendi bağlam ve istek sayınızı hesaplayıcıda gpt-oss-120b için deneyebilirsiniz.
API nasıl kullanılır?
Teslimde bir HTTPS adresi ve LiteLLM ana anahtarı (master key) alırsınız. Ana anahtarı uygulamalara koymayın; her uygulama için ayrı bir anahtar üretin (aşağıda). İsteklerdeki model adı, LiteLLM'de tanımlı takma addır; örneğin gpt-oss-120b ya da qwen3.8-27b.
curl ile ilk istek
curl https://llm.sirketiniz.com.tr/v1/chat/completions \
  -H "Authorization: Bearer sk-uygulama-anahtariniz" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-oss-120b",
    "messages": [
      {"role": "user", "content": "e-Fatura ile e-Arşiv fatura arasındaki farkı iki cümlede açıkla."}
    ]
  }'
Python ve OpenAI SDK ile akışlı yanıt
from openai import OpenAI

client = OpenAI(
    base_url="https://llm.sirketiniz.com.tr/v1",
    api_key="sk-uygulama-anahtariniz",
)

stream = client.chat.completions.create(
    model="gpt-oss-120b",
    messages=[{"role": "user", "content": "Bu iade talebini kategoriye ayır: ..."}],
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
Kodunuz adresi ve anahtarı ortam değişkenlerinden okuyorsa OPENAI_BASE_URL ile OPENAI_API_KEY değerlerini değiştirip model adını güncellemeniz çoğu zaman yeterlidir.
Araç çağırma ve yapılandırılmış çıktı
vLLM'de araç çağırma (function calling), sunucu tarafında --enable-auto-tool-choice ve modele uygun --tool-call-parser ile açılır. Kurulumda bunu modele göre ayarlıyoruz: gpt-oss için openai, Mistral Small 3.2 için mistral, Qwen modelleri için model kartının önerdiği ayrıştırıcı. gpt-oss'ta yalnızca tool_choice="auto" desteklenir; Mistral ve Qwen'de required ya da belirli bir fonksiyon da seçilebilir.
Yapılandırılmış çıktı vLLM'de varsayılan olarak açıktır. Standart response_format alanına {"type": "json_schema", "json_schema": {...}} biçiminde bir şema verdiğinizde yanıt bu şemaya uyacak şekilde üretilir; fatura, adres ya da talep kaydından alan çıkaran işlerde ayrıştırma hatalarını azaltır.
LiteLLM ile API anahtarları, sınırlar ve kullanım kayıtları
LiteLLM'de her uygulama, ekip ya da müşteri projesi için ayrı bir sanal anahtar üretirsiniz. Anahtar hangi modelleri çağırabileceğini, dakikadaki istek ve token sınırını, aynı anda kaç açık isteği olabileceğini ve ne zaman sona ereceğini taşır. LiteLLM belgesindeki /key/generate uç noktasıyla:
curl https://llm.sirketiniz.com.tr/key/generate \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "key_alias": "destek-botu",
    "models": ["gpt-oss-120b"],
    "rpm_limit": 60,
    "tpm_limit": 200000,
    "max_parallel_requests": 8,
    "duration": "90d"
  }'
Bu anahtarla destek botu yalnızca gpt-oss-120b'yi çağırır, sınırları aşan istekler reddedilir; böylece bir uygulamadaki döngü hatası diğerlerinin kapasitesini tüketmez. Anahtarları LiteLLM'in yönetim arayüzünden (/ui) de üretip iptal edebilirsiniz.
LiteLLM her anahtarın, kullanıcının ve ekibin kullanımını PostgreSQL'de tutar; hangi uygulamanın ne kadar token harcadığını arayüzden ya da API'den görürsünüz. Kendi sunucunuzdaki modeller için token ücreti yoktur.
LiteLLM'deki model_name, uygulamaların gördüğü takma addır. sirket-llm adını bugün gpt-oss-120b'ye, yarın Qwen3.8-27B'ye yönlendirebilirsiniz; uygulama kodu değişmez. Türkçe kalitesi modele ve göreve göre değiştiği için bu yöntemle kendi müşteri e-postalarınız, sözleşme özetleriniz ya da destek kayıtlarınız üzerinde modelleri karşılaştırıp karar verin. Şirket belgeleri üzerinde soru-cevap (RAG) kuracaksanız kurumsal yapay zeka sayfamıza bakın.
Birden fazla GPU: tensor paralellik ne zaman gerekir?
Model tek karta sığıyorsa ikinci GPU'yu ikinci bir vLLM kopyası için kullanın; LiteLLM aynı model adının arkasındaki iki kopya arasında yükü dağıtır. Kartlar arası iletişim olmadığından NVLink gerekmez.
Model tek karta sığmıyorsa vLLM'in --tensor-parallel-size seçeneği her katmanı kartlara böler; her adımda kartlar arası iletişim gerektiği için NVLink'li kartlarda verimlidir, NVLink'siz kartlarda vLLM belgeleri pipeline paralelliği (--pipeline-parallel-size) önerir. Tek siparişte en fazla 8 GPU kiralanabilir. Ayrıntılar için multi-GPU ve NVLink rehberimize bakın.
Ne kurulmuyor ve neden?
Root erişiminiz olduğu için aşağıdakileri kendi lisans koşullarına uyarak siz kurabilirsiniz; biz varsayılan kuruluma koymuyoruz.
- LiteLLM Enterprise özellikleri: LiteLLM'in
enterprise/ dizinindeki kod ve lisans anahtarıyla açılan özellikler ayrı, ücretli bir lisansa bağlıdır. LiteLLM belgesine göre 5 kullanıcıyı aşan SSO, denetim kayıtları (audit logs), JWT ile kimlik doğrulama, IP izin listeleri ve anahtar rotasyonu bu kapsamdadır. Paket MIT lisanslı açık kaynak çekirdekle gelir; sanal anahtarlar, bütçe ve hız sınırları, kullanım takibi ve yönetim arayüzü bu çekirdeğin parçasıdır.
- n8n: Sustainable Use License, kendi iç iş amaçlarınız için kullanıma izin verir ama n8n'i hizmet olarak kurup sunmamıza izin vermez. n8n'i kendiniz kurup OpenAI kimlik bilgisinde taban adres olarak LiteLLM adresinizi ve bir sanal anahtar girerek bu API'ye bağlayabilirsiniz.