Sesi yapay zeka ile yazıya çevirmek için ne gerekir?
Sesi yapay zeka ile yazıya çevirmek (ses deşifre, speech to text) için kayıt bir otomatik konuşma tanıma (ASR) modeline verilir; model konuşmayı zaman damgalı metne dönüştürür. Türkçe için yaygın kullanılan açık model OpenAI'nin Whisper large-v3'üdür. Bu modeli, İstanbul Bağcılar'daki kendi tesisimizde size ayrılmış aylık bir GPU sunucuda çalıştırırsınız; kayıtlarınız Türkiye'de kalır.
Whisper large-v3 1.550 milyon parametreli ve MIT lisanslıdır. Model küçük olduğu için bellek nadiren sorun olur: faster-whisper'ın ölçümünde aynı boyuttaki large-v2, int8'de 2,9 GB, fp16 ve 8'li batch ile 6,1 GB kullanıyor. GPU seçimini asıl ses hacmi, konuşmacı ayrımı ve dökümleri LLM ile özetleyip özetlemeyeceğiniz belirler. Fiyatlar GPU başına, aylık, ABD doları cinsinden ve KDV hariçtir; tüm modeller için GPU sunucu fiyatları sayfasına bakın.
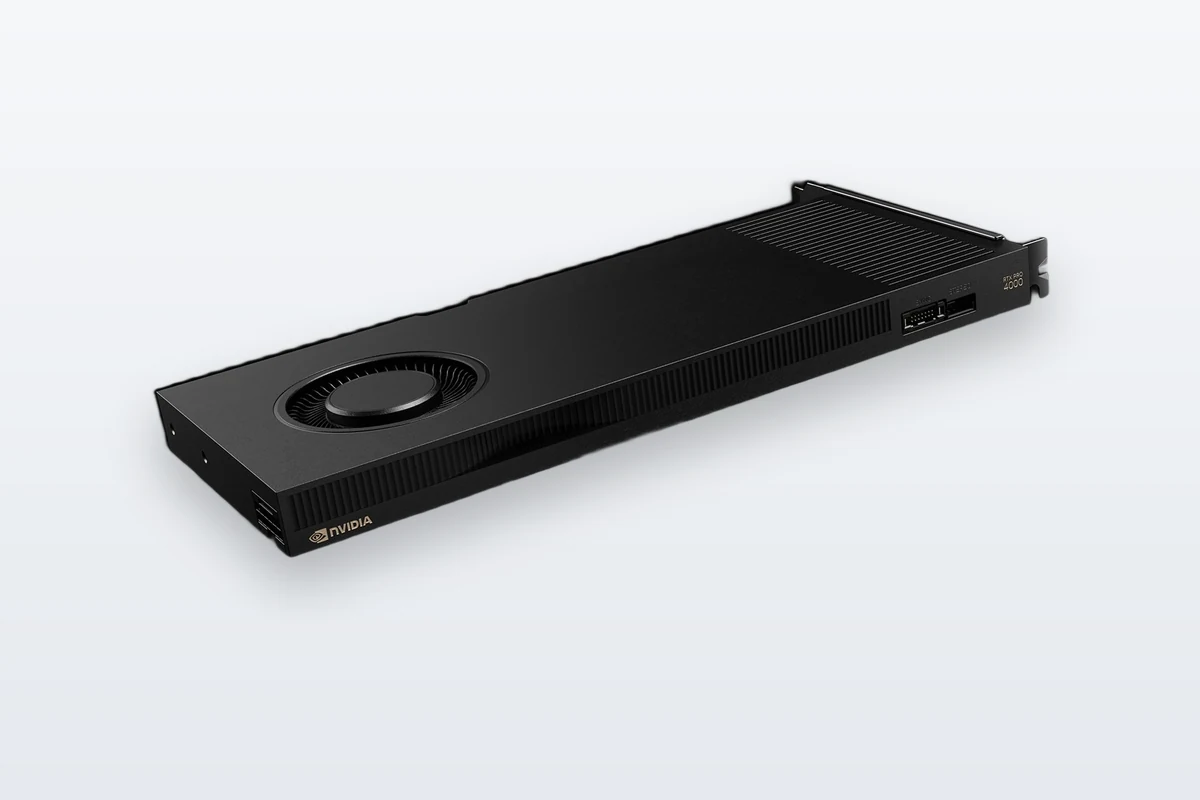
- Toplu döküm ve konuşmacı ayrımı: RTX PRO 4000, 24 GB ECC'li bellek, aylık $450.
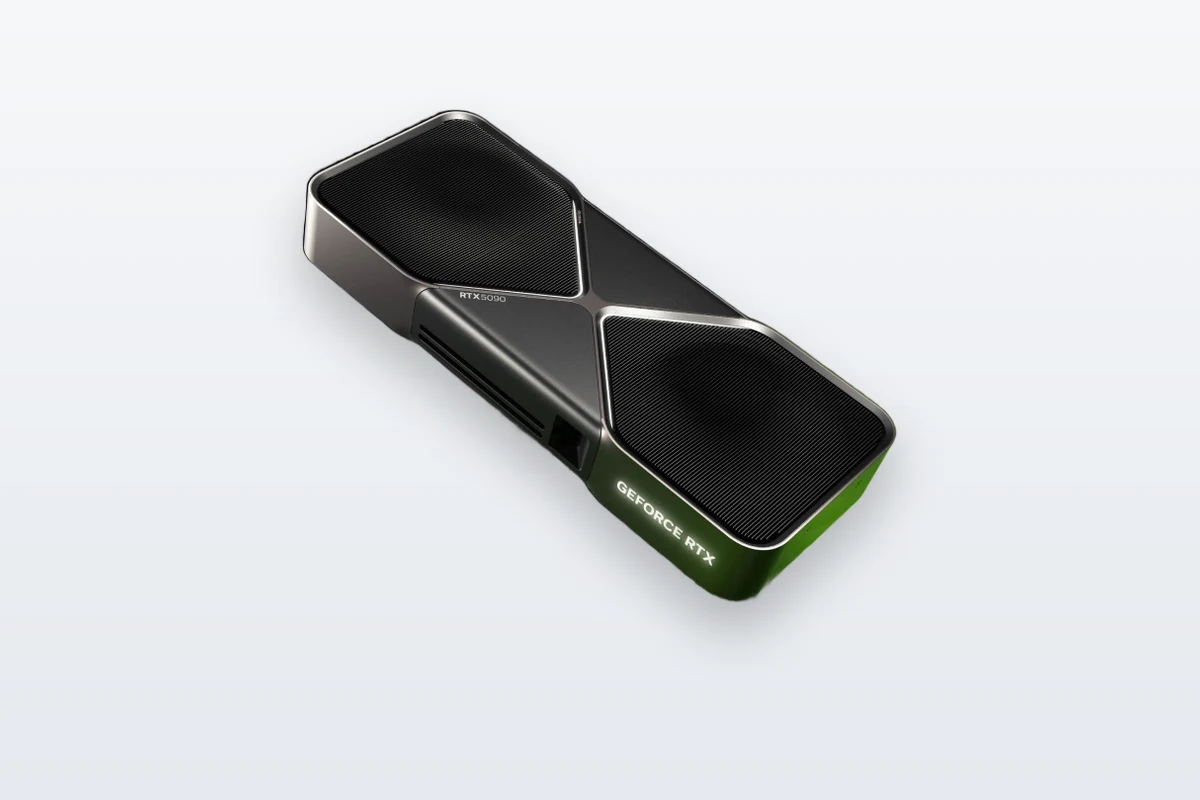
- Yüksek hacimli döküm: RTX 5090, 32 GB ve 1.792 GB/s bant genişliği, aylık $600.
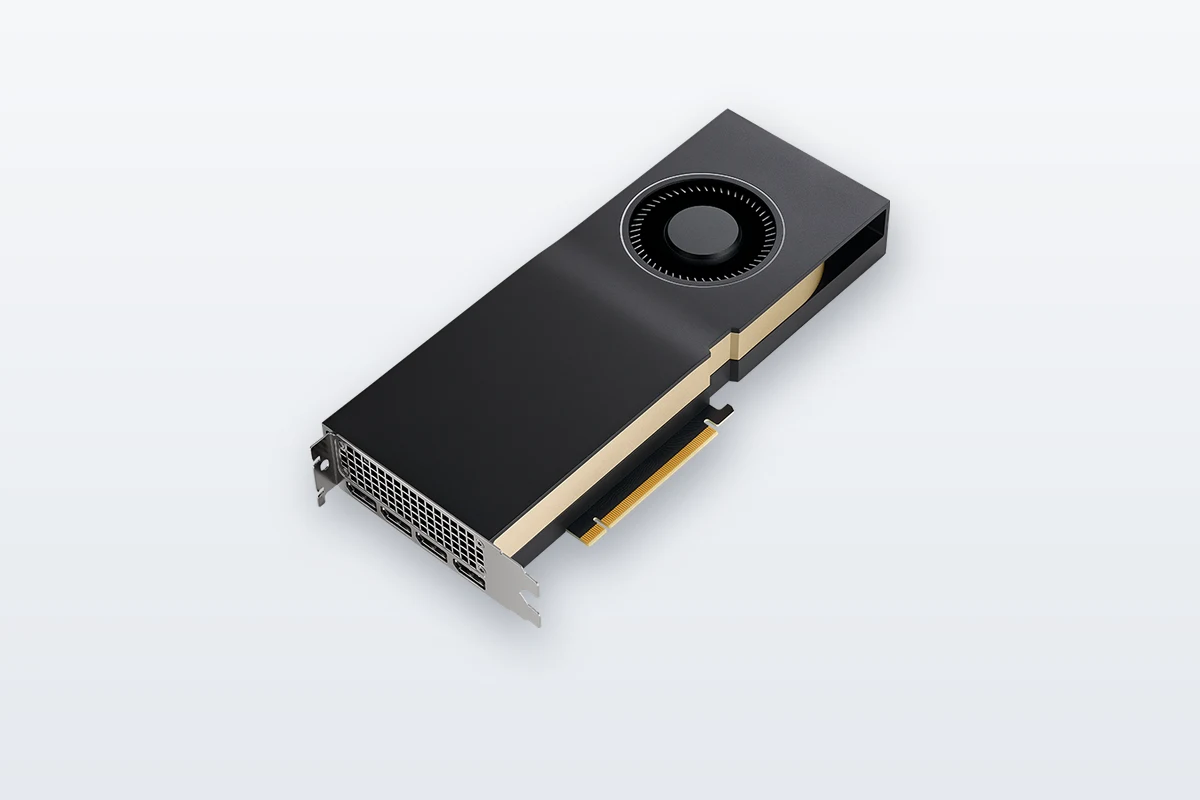
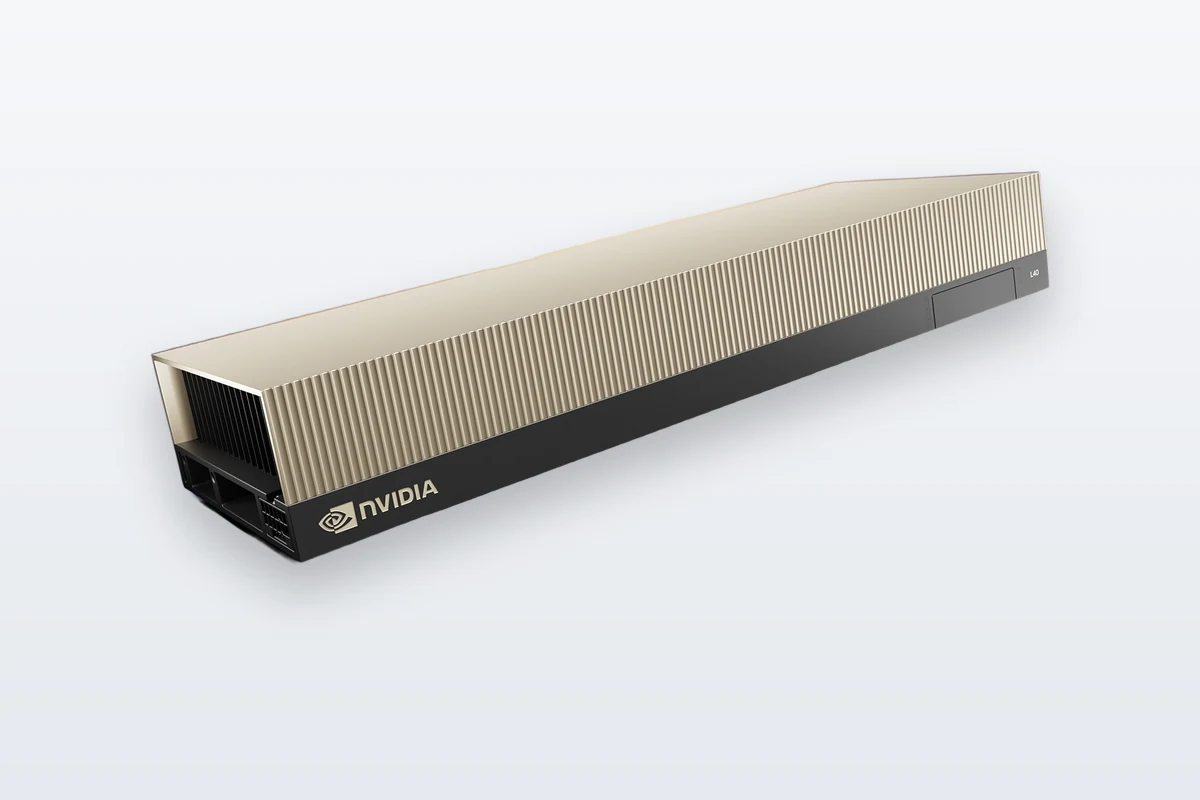
- Döküm ve LLM ile özet aynı kartta: L40S, 48 GB ECC'li bellek, aylık $900.
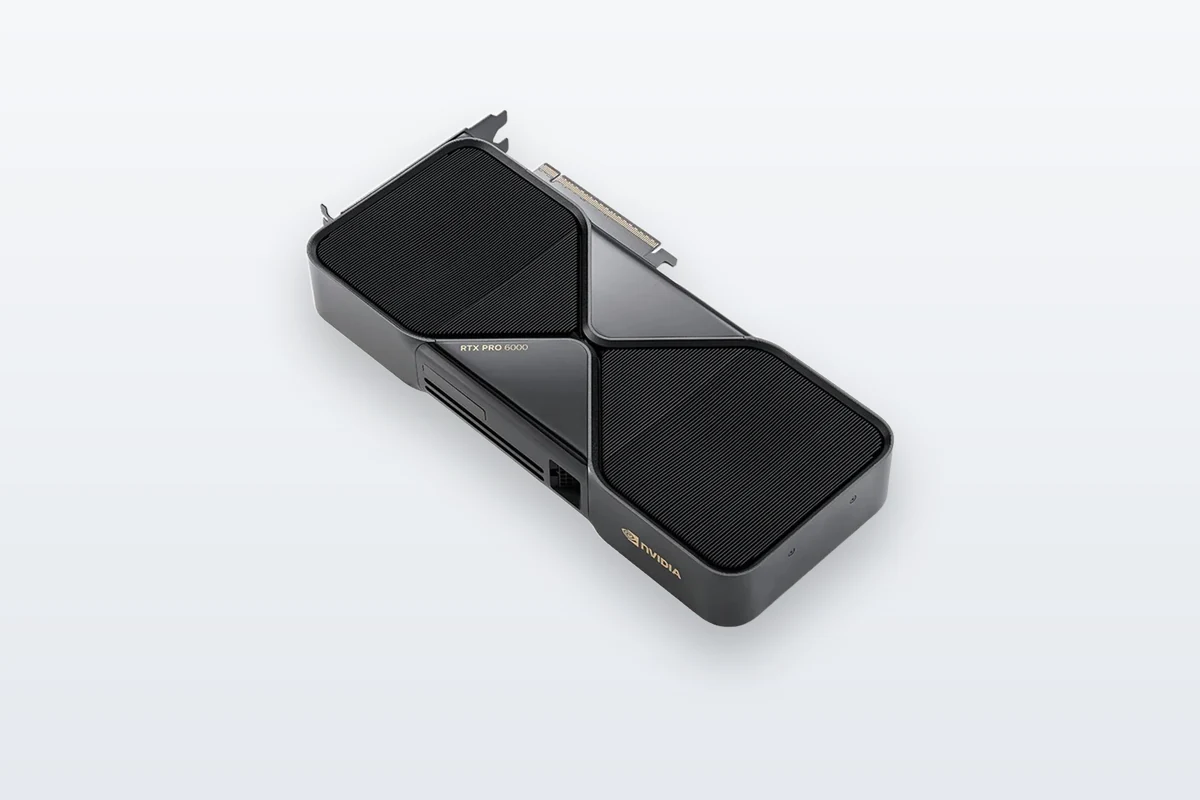
- Döküm, 32B LLM ve seslendirme tek kartta: RTX PRO 6000, 96 GB; küçük servisler MIG ile 24 GB'lık bölümlere ayrılabilir, aylık $1.600.
Whisper için kaç GB VRAM ve hangi GPU gerekir?
Whisper large-v3, uygulamaya göre yaklaşık 3–10 GB GPU belleğiyle çalışır: openai/whisper README'si large modeller için ~10 GB, turbo için ~6 GB veriyor; faster-whisper'ın large-v2 ölçümünde int8 2,9 GB, fp16 4,5 GB, fp16 ve 8'li batch 6,1 GB kullanılıyor. Yalnızca yazıya çevirecekseniz küçük bir kart yeter; dökümleri aynı sunucuda bir LLM ile özetleyip sınıflandıracaksanız belleği LLM belirler.
Dökümü özetleyecek LLM'i vLLM ile OpenAI uyumlu bir API olarak sunabilirsiniz. Apache 2.0 lisanslı Qwen3 14B FP8'de 17,9 GB, Qwen3 32B ise 37,6 GB ister (8.192 token bağlam, tek istek); eşzamanlı istek sayısı arttıkça KV önbelleği büyür. İlki RTX 5090'a ya da L40S'e, ikincisi L40S'e sığar; ikincisinin yanında Whisper ve seslendirme de çalışacaksa RTX PRO 6000 gerekir (L40S mi RTX PRO 6000 mi?). Ayrıntılar LLM inference sayfamızda, kendi senaryonuzun hesabı VRAM hesaplayıcıda.
Whisper Türkçede ne kadar doğru, large-v3 mü turbo mu?
Whisper large-v3 Türkçe için güçlü bir başlangıçtır; ancak telefon kayıtlarında hata oranı yayımlanan kıyaslamalardakinden yüksek çıkar. Doğruluk öncelikliyse large-v3'ü, hız öncelikliyse large-v3-turbo'yu seçin.
- Whisper makalesine göre ilk modellerin eğitim verisinde 4.333 saat Türkçe konuşma vardı; large-v2'nin Türkçe kelime hata oranı (WER) FLEURS'ta %8,4, Common Voice 9'da %14,5'tir.
- large-v3, 1 milyon saat zayıf etiketli ve 4 milyon saat sözde etiketli sesle eğitildi; model kartına göre large-v2'ye kıyasla hataları %10–20 azaltıyor.
- large-v3-turbo, kod çözücü katmanlarını 32'den 4'e indirir: 809 milyon parametre ve küçük bir kalite kaybı. openai/whisper README'si, İngilizce sesle A100'de yaklaşık 8 kat hız ölçüyor. Çeviri için eğitilmemiştir.
- FLEURS ve Common Voice, okunan cümlelerden oluşan kayıtlardır. Dar bantlı telefon sesi, kendiliğinden ve üst üste konuşma ile gürültü hata oranını genellikle artırır; Whisper sesi 16 kHz'e çevirip 30 saniyelik pencerelerle işler. Karar vermeden önce kendi örnek kayıtlarınızda WER ölçün; sonuç yetersizse Whisper'a kendi etiketli kayıtlarınızla ince ayar yapabilirsiniz (yapay zeka model eğitimi).
Türkçe destekleyen açık modeller (Ekim 2026):
Qwen'in teknik raporunda, Türkçenin de aralarında olduğu sekiz dilin eklendiği FLEURS kümesinde (Fleurs†) Qwen3-ASR-1.7B'nin ortalama WER'i 6,62, Whisper large-v3'ünki 6,85'tir; on dil daha eklenen kümede ise Whisper önde kalır (8,16'ya karşı 12,60). NVIDIA'nın Canary-1B-v2'si (25 Avrupa dili) ve Mistral'in Voxtral modelleri (13 dil) Türkçe desteklemiyor.
Hangi yazılımla çalışır: faster-whisper, WhisperX, pyannote?
Toplu döküm için faster-whisper, kelime düzeyinde zaman damgası ve konuşmacı ayrımı (diarization) gerekiyorsa WhisperX kullanın.
faster-whisper (MIT; son sürüm Ekim 2025'teki 1.2.1, geliştirme sürüyor) Whisper'ı CTranslate2 ile çalıştırır. README'deki ölçüm, 13 dakikalık bir kayıtta large-v2 ile 8 GB'lık RTX 3070 Ti üzerinde yapıldı:
README'ye göre güncel CTranslate2 sürümleri yalnızca CUDA 12 ve cuDNN 9 ile çalışır. PyTorch 2.14'ün varsayılan CUDA 13 paketleriyle aynı ortama koymak yerine faster-whisper'ı ayrı bir konteynerde, örneğin CUDA 12 ve cuDNN 9 içeren bir nvidia/cuda imajında çalıştırın; ayrıntılar Docker rehberimizde.
WhisperX (BSD-2-Clause; Mayıs 2026'daki 3.8.6) faster-whisper'a kelime düzeyinde zaman hizalama ve pyannote ile konuşmacı ayrımı ekler; Türkçe hizalamada varsayılan olarak mpoyraz/wav2vec2-xls-r-300m-cv7-turkish modeli kullanılır. Çıktıyı SRT ve VTT altyazı dosyası olarak da yazar. README'si large-v2 ile 70 kat gerçek zaman hızı bildiriyor ve üst üste konuşmada zayıf kaldığını belirtiyor. PyTorch'u 2.8 sürümüne sabitlediği için ayrı bir sanal ortama kurun:
pip install whisperx
whisperx gorusme.wav --model large-v3 --language tr --diarize \
  --hf_token "$HF_TOKEN" --output_format srt
pyannote community-1 (CC-BY-4.0), WhisperX'in varsayılan konuşmacı ayrımı modelidir; Hugging Face'te iletişim bilgilerinizi paylaşıp koşulları kabul etmeniz ve erişim anahtarı (token) kullanmanız gerekir. pyannote-audio README'sindeki ölçümde (NVIDIA H100, Eylül 2025) bir saatlik ses yaklaşık 31 saniyede işleniyor. Daha isabetli precision-2 ücretli bir üründür; API anahtarıyla kullanıldığında pyannoteAI'nin sunucularında çalışır ve kayıtlarınız Türkiye dışına çıkar, kendi sunucunuzda çalışan bir sürümü de vardır. Santraliniz müşteriyi ve temsilciyi ayrı kanallara kaydediyorsa kanalları ayrı ayrı yazıya çevirip konuşmacı ayrımını atlayabilirsiniz.
Bir GPU ayda kaç saatlik sesi yazıya çevirir?
Kesin değer kayıtlarınıza ve kartınıza bağlıdır; gereken hızı aylık hacminizden hesaplayın, kartın hızını kendi kayıtlarınızla ölçün.
Gereken hız (kaç kat gerçek zaman) = aylık ses saati ÷ ayda işlemeye ayrılan saat. 7/24 çalışmada bu süre 730, günde 8 saatte yaklaşık 240 saattir:
Karşılaştırma noktası: faster-whisper README'sindeki ölçümde 13 dakikalık kayıt 17 saniyede, yani yaklaşık 46 kat gerçek zaman hızında işlendi. Bu oranla 7/24 çalışan tek bir kart ayda kabaca 33.000 saat ses çevirir; ancak konuşmacı ayrımı, hizalama ve dosya dönüştürme süreye eklenir ve sizin kartınızda oran farklı olur. RTX PRO 4000'in bant genişliği 672 GB/s'dir; yüksek hacimde RTX 5090'ın 1.792 GB/s'si fark yaratabilir. Ölçmek için temsili bir saatlik örneği işleyin: işlem süresi ÷ ses süresi, gerçek zaman katsayısını (RTF) verir. Ses saati başına maliyeti de buradan bulursunuz: aylık sunucu fiyatını ayda işlediğiniz ses saatine bölün; hacim arttıkça bu maliyet düşer.
Bellek nadiren sınırdır: faster-whisper (batch 8, fp16) yaklaşık 6,1 GB ister. L40S'te yanına Qwen3 14B FP8 (8.192 token bağlam ve tek istekte 17,9 GB) eklediğinizde toplam yaklaşık 24 GB eder; kartın kullanılabilir yaklaşık 44 GB'ından kalan kısım eşzamanlı isteklerin KV önbelleğine kalır.
Toplu işleme mi, gerçek zamanlı akış mı?
Kayıtları sonradan işliyorsanız toplu işleme daha ucuzdur ve genellikle daha isabetlidir; canlı altyazı ya da canlı çağrı asistanı için akış (streaming) kurgusu gerekir.
- Toplu: Gün içinde biriken kayıtlar bir kuyrukta işlenir; batch büyüdükçe GPU verimi artar.
- Akış: Whisper 30 saniyelik pencerelerle çalışır, doğal bir akış modeli değildir. whisper_streaming uzun konuşmada 3,3 saniyelik gecikme bildirmişti; 2025'te yerini MIT lisanslı SimulStreaming'e bıraktı (README'sine göre yaklaşık 5 kat hızlı). Qwen3-ASR vLLM ile akış destekler, ancak akış modunda batch ve zaman damgası yoktur. Mistral'in açık ağırlıklı Voxtral Realtime modeli ise Türkçe desteklemiyor.
- Kapasite: Bir kartın kaç canlı akış taşıyacağı modele, gecikme hedefine ve eşzamanlı konuşma sayısına bağlıdır; gerçekçi bir yük testiyle ölçün.
Videoya altyazı gömüp yeniden kodlayacaksanız NVENC'li kartlar ve FFmpeg için video işleme sayfamıza bakın.
Toplantı notu ve çağrı merkezi analizi için yapay zeka nasıl çalışır?
Toplantı notu çıkaran ya da çağrı kayıtlarını analiz eden bir sistem iki modelden oluşur: Whisper kaydı konuşmacı etiketli metne çevirir, bir LLM de bu metinden özet ve aksiyon maddelerini çıkarır. İkisi aynı GPU'da çalışabilir.
- Toplantı: Dökümden özet, alınan kararlar ve sorumlusuyla aksiyon maddeleri çıkarılır.
- Çağrı merkezi: Konu, müşteri talebi ve kalite kontrol maddeleri çıkarılır; temsilci kalitesi aynı ölçütlerle izlenebilir.
- Yapılandırılmış çıktı: vLLM, çıktıyı bir JSON şemasına uydurabilir; sonuç doğrudan CRM'e ya da veritabanına yazılabilir.
- Uzun kayıtlar: Qwen3 14B'nin bağlamı yerel olarak 32.768, YaRN ile 131.072 tokendir. Daha uzun dökümleri bölümlere ayırın; önce bölüm özetlerini, sonra genel özeti çıkarın.
- İnsan denetimi: Temsilci puanlaması gibi kişiyi etkileyen kararlarda otomatik analizi tek başına kullanmayın; ayrıntılar aşağıdaki KVKK bölümünde.
Aynı LLM'i şirket belgeleriyle çalışan bir asistanda da kullanacaksanız kurumsal yapay zeka sayfamıza bakın.
Metinden sese (TTS) ve ses klonlama için GPU
Türkçe metni sese çeviren açık modeller küçüktür; asıl seçim ölçütü lisanstır. Ekim 2026 itibarıyla Türkçe konuşan ve ticari kullanıma açık iki model öne çıkar: VoxCPM2 (Apache 2.0) ve Chatterbox Multilingual (MIT). XTTS-v2 ve F5-TTS de Türkçe konuşabilir, ancak ağırlıkları ticari kullanıma kapalıdır.
- F5-TTS: Temel ağırlıklar, eğitim verisi Emilia nedeniyle CC BY-NC lisanslıdır. Common Voice 17 ile eğitilen marduk-ra/F5-TTS-Turkish de CC BY-NC 4.0'dır; multilingual-tts/F5-TTS-OpenBible-Turkish kartında CC BY-SA 4.0 yazsa da aynı temel modelden türetilmiştir, ticari kullanmadan önce hukuki görüş alın.
- Piper: Küçük cihazlarda yerel çalışmak için tasarlanmış hafif bir sistemdir ve ses klonlama sunmaz; diğer iki Türkçe ses (fahrettin, fettah) katkıcıların isteğiyle kaldırıldı.
- Kokoro: Kokoro-82M (Apache 2.0) popülerdir, ancak ses listesinde Türkçe yoktur.
- Trendyol-TTS: Haziran 2026'da yayımlanan, VoxCPM2'nin Türkçeye uyarlanmış bir araştırma modelidir; model kartı, temel modelin ve eğitim verisinin koşullarını ayrıca kontrol etmenizi istiyor.
Bellek değerleri uygulamaya göre değişir: NVIDIA'nın değeri kendi eklentisi içindir, PyTorch paketiyle daha fazla bellek kullanılabilir. Kendi kurulumunuzda nvidia-smi ile ölçün. Lisanslar da değişebilir; kullanmadan önce güncel metni okuyun.
Seslendirme modeli küçük olduğu için kartı, yanında neyin çalışacağı belirler. Aşağıdaki hesapta kart belleğinin %92'si kullanılabilir sayıldı; Whisper için faster-whisper'ın fp16 ve 8'li batch ölçümü (6,1 GB) alındı:
- 16 GB, RTX 5060 Ti: Whisper ile Chatterbox birlikte yaklaşık 9,6 GB eder ve kullanılabilir ~14,7 GB'a rahat sığar. Whisper ile VoxCPM2 toplam ~14,1 GB eder; sığar ama pay az kalır. 16 GB'ta ECC'li kartımız yok; ECC'li bellek 24 GB'lık RTX A5000 ve RTX PRO 4000'de var. Aylık $200.
- 24 GB, RTX 3090, RTX A5000 ya da RTX PRO 4000: Whisper, VoxCPM2 ve Chatterbox aynı kartta yaklaşık 17,6 GB eder ve rahat sığar. Soruyu dinleyip sesli yanıt veren bir asistanda Whisper, Chatterbox ve Qwen3 8B FP8 (8.192 token bağlam, tek istek: 10,8 GB) toplam ~20,4 GB eder ve kullanılabilir ~22 GB'a sığar; eşzamanlı istekler için pay azdır. ECC'li bellek RTX A5000 ve RTX PRO 4000'de vardır, RTX 3090'da yoktur. Aylık sırasıyla $300, $300 ve $450.
Ara sıra birkaç saatlik seslendirme yapıyorsanız saatlik bulut GPU pazarları daha ucuz olabilir. Her gün ses üreten bir çağrı merkezi, e-öğrenme ya da sesli asistan işinde aylık sunucu sabit fiyat, size ayrılmış kart, Türk lirası fatura ve Türkiye'de kalan veri sağlar; aylık %99,5 erişilebilirlik hedefi hizmet kredisiyle desteklenir (SLA ve destek).
Ses klonlama ve izin: Ses klonlamada modele hedef sesin kısa ve temiz bir kaydı referans olarak verilir; model yeni metni bu sesle okur. XTTS-v2'nin model kartı 6 saniyelik bir klibi yeterli sayıyor; VoxCPM2'de referans kaydın metniyle birlikte verildiği ayrı bir klonlama modu da vardır. Kimliği belirlenebilir bir kişinin sesi kişisel veridir (KVKK m.3). Bir sesi klonlamadan önce o kişinin açık ve belgelenmiş iznini alın, sesi hangi amaçla kullanacağınızı söyleyin; ünlülerin, müşterilerin ya da çalışanların sesini izinsiz taklit etmeyin. Chatterbox her çıktıya duyulmayan bir Perth filigranı ekler; diğer modellerde dinleyiciye sesin yapay olduğunu belirtin. Bu bilgi geneldir, hukuki tavsiye değildir.
Ses kayıtları KVKK açısından neden hassastır?
Kimliği belirli ya da belirlenebilir bir kişiye ait ses kaydı kişisel veridir (KVKK m.3); kaydı alırken aydınlatma yapmanız gerekir (m.10).
- Aydınlatma: Aydınlatma Tebliği'ne göre aydınlatma sözlü, yazılı, ses kaydı ya da çağrı merkezi aracılığıyla yapılabilir; yapıldığını ispat yükü veri sorumlusundadır. İşleme açık rızaya dayanıyorsa aydınlatma ile açık rıza alma ayrı ayrı yerine getirilir.
- Özel nitelikli veri: Sağlık ile ceza mahkumiyeti ve güvenlik tedbirlerine ilişkin veriler m.6'da özel nitelikli sayılır; hastane, sigorta ve hukuk kayıtlarının dökümleri bu kapsama girebilir. Ses izinden kimlik doğrulama gibi kullanımlar da Kurum'un biyometrik veri rehberindeki tanıma girebilir.
- Otomatik analiz: m.11'e göre kişi, yalnızca otomatik sistemlerle yapılan analizin aleyhine bir sonuç doğurmasına itiraz edebilir; temsilci puanlaması gibi kararlarda insan denetimini koruyun.
- Yurt dışı: Kayıtları yurt dışındaki bir konuşma tanıma API'sine göndermek yurt dışına aktarımdır; kurallar KVKK rehberimizde.
Sunucularımız İstanbul Bağcılar'daki kendi tesisimizdedir; kayıtlar ve dökümler Türkiye'de kalır, GPU başka müşterilerle paylaşılmaz. Uyum değerlendirmesi kendi veri işleme süreçlerinize bağlıdır. Bu bölüm genel bilgidir, hukuki tavsiye değildir.
Aylık ve yerel sunucu ne zaman mantıklı?
Her gün kayıt üreten bir çağrı merkezi ya da düzenli döküm ve altyazı işi için aylık, size ayrılmış bir sunucu mantıklıdır.
- Mantıklı: Dakika başına ücretlendiren speech to text API'lerinde maliyet hacimle büyür, aylık sunucuda sabit kalır. Kayıtlar Türkiye'de kalır; fiyat ABD doları cinsindendir, fatura düzenlendiği günkü TCMB satış kuruyla Türk lirası olarak kesilir. Yıllık kiralamada aylık fiyata %20 indirim uygulanır.
- Mantıklı değil: Ayda birkaç saatlik kayıt. RTX PRO 4000'in aylık fiyatının saatlik karşılığı $0,62; bu hacimde bir API ya da saatlik bulut GPU daha ucuzdur. Bazı ticari konuşma tanıma API'leri gürültülü telefon sesinde ya da sektör terimlerinde açık modellerden daha iyi sonuç verebilir; karar vermeden önce aynı örnek kayıtlarla karşılaştırın.
Günlük kayıt hacmini, kayıt biçimini (mono ya da stereo, 8 ya da 16 kHz) ve LLM ihtiyacınızı sipariş formunun mesaj alanına yazın.
Özet
- Ekim 2026 itibarıyla Türkçe döküm için referans açık model Whisper large-v3'tür; large-v2'nin Türkçe WER'i FLEURS'ta %8,4'tür ve telefon kayıtlarında daha yüksek çıkar.
- faster-whisper large sınıfı modeli fp16'da yaklaşık 4,5 GB, int8'de 2,9 GB ile çalıştırır; CPU'da da çalışır ama yüksek hacimde GPU gerekir. WhisperX zaman hizalama ve konuşmacı ayrımı ekler, PyTorch 2.8'e sabitlidir.
- Toplantı notu ve çağrı analizi için Whisper dökümü aynı karttaki bir LLM'e verilir; Whisper ve Qwen3 14B FP8 birlikte bir L40S'e sığar.
- Gereken hız, aylık ses saatinin işlemeye ayrılan saate bölümüdür; kartın hızını bir saatlik temsili örnekle ölçün.
- Ticari Türkçe seslendirme için VoxCPM2 (Apache 2.0) ve Chatterbox Multilingual (MIT) uygundur; XTTS-v2, F5-TTS'in temel ağırlıkları, Piper'ın Türkçe sesi ve MMS-TTS ticari kullanıma kapalıdır. Whisper ve Chatterbox birlikte 16 GB'lık tek bir karta sığar; bir sesi klonlamadan önce o kişinin iznini alın.
- Ses kayıtları kişisel veridir; aydınlatma yükümlülüğünü ve yurt dışına aktarım kurallarını baştan planlayın.
Kaynaklar