RTX 3090 nedir, kiralık RTX 3090 sunucu ne işe yarar?
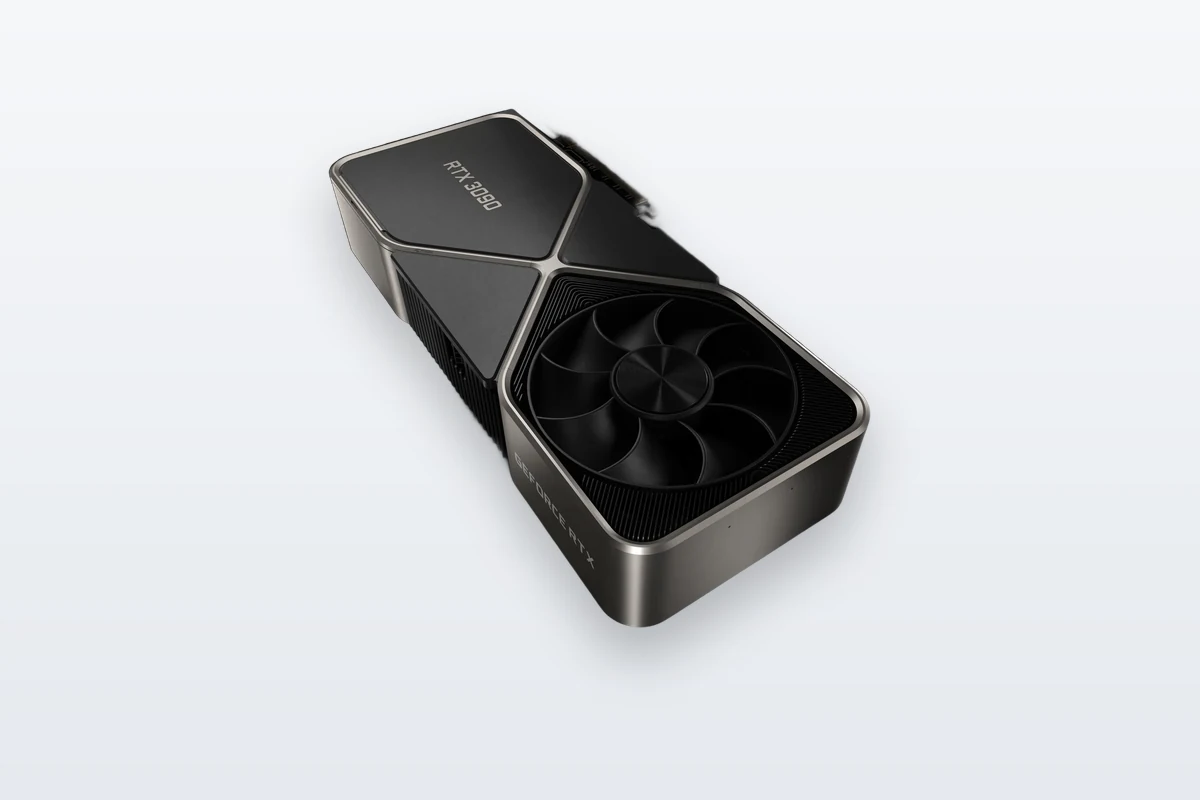
Kısa cevap: NVIDIA GeForce RTX 3090, 24 GB GDDR6X bellek (VRAM) ve 936 GB/s bant genişliği sunan Ampere mimarili bir ekran kartıdır. 24 GB'a sığan dil modelleri, SDXL ve FLUX ile görsel üretimi, Türkçe seslendirme (TTS) ve Whisper için kiralanır. İstanbul Bağcılar'daki kendi tesisimizde paylaşımsız sunucuda aylık $300 (GPU başına, KDV hariç).
- En uygun işler: BF16'da 8B, 8-bit'te 14B ve 4-bit'te 24B'ye kadar modellerle inference, QLoRA ve 8B LoRA ince ayarı, SDXL ve FLUX, TTS ve Whisper servisleri.
- Bellek (VRAM): 24 GB GDDR6X, 384 bit veri yolu; ECC yok.
- Ne zaman başka kart? ECC, FP8/FP4 ve düşük güç tüketimi için RTX PRO 4000; 32 GB ve yaklaşık iki kat bant genişliği için RTX 5090.
RTX 3090 hangi işler için kiralanır?
- LLM inference: VRAM hesaplayıcımıza göre (8.192 token bağlam, tek istek) Llama 3.1 8B BF16'da 18,9 GB, Qwen3 14B 8-bit'te 17,9 GB, gpt-oss-20b 13,5 GB, Mistral Small 3.2 24B 4-bit'te 16,5 GB ve Qwen3 30B-A3B 4-bit'te 19,8 GB ister; hepsi tek karta sığar. Kartın belleğinin yaklaşık %92'si iş yüküne ayrılabildiği için kullanılabilir alan yaklaşık 22,1 GB'tır. Qwen3 32B 4-bit'te 22,5 GB ile bu sınırı az farkla aşar; 4.096 token bağlamda 21,4 GB'a iner.
- Görsel üretimi: SDXL 8–12 GB ile rahat çalışır. 12 milyar parametreli FLUX.1 [dev] BF16'da yalnızca ağırlıklar için yaklaşık 24 GB tuttuğundan bu kartta FP8 (12–16 GB) ya da GGUF 4-bit (yaklaşık 8 GB) dosyalarla kullanılır. Ayrıntılar Stable Diffusion ve FLUX rehberimizde ve görsel üretimi sayfamızda.
- İnce ayar: 2.048 token, batch 1 ve gradient checkpointing ile Llama 3.1 8B'nin BF16 LoRA'sı 19,9 GB, Qwen3 14B QLoRA 13,3 GB, Mistral Small 3.2 24B QLoRA 18,3 GB ile tek karta sığar. GeForce kartlarda FP32 biriktirmeli tensör işlemleri yarı hızda çalışır: RTX 3090'da BF16 için 71 TFLOPS (seyrekliksiz). Uzun eğitimlerde bu fark hissedilir; maliyet hesabı fine-tuning rehberimizde.
- Çoklu GPU: Tek siparişte 8 karta kadar kiralayabilirsiniz. RTX 3090, iki kartı bağlayan NVLink köprüsünü destekler; NVIDIA'nın GA102 belgesi bu çipin NVLink arayüzü için iki kart arasında toplam 112,5 GB/s verir. Inference için köprü şart değildir, vLLM'in tensör paralelliği PCIe üzerinden de çalışır. Ayrıntılar NVLink rehberimizde.
TTS ve Whisper için RTX 3090 yeterli mi?
Evet, bellek açısından fazlasıyla. Türkçe ses işleri için yaygın açık modellerin ihtiyaçları (Ekim 2026):
XTTS-v2 Türkçe konuşsa da lisansı ticari kullanıma izin vermez; Piper'ın tek Türkçe sesi için de aynı sınır geçerlidir. 24 GB'ın asıl getirisi, bu modellerin bir LLM ile aynı kartta çalışabilmesidir: Whisper large-v3-turbo (~6 GB), Chatterbox Multilingual (~3,5 GB) ve 4-bit Qwen3 8B (7,1 GB) toplamda yaklaşık 16,6 GB eder. Konuşmayı yazıya çeviren, yanıtı üreten ve seslendiren bir sesli asistan böylece tek kartta çalışır. Ayrıntılar ses tanıma sayfamızda.
RTX 3090 kaç GB, teknik özellikleri ve sürümleri neler?
RTX 3090'da 24 GB GDDR6X bellek vardır; 384 bit veri yolu ve 19,5 Gbps veri hızıyla bant genişliği 936 GB/s'dir. GA102 çipinde 10.496 CUDA çekirdeği, 328 üçüncü nesil tensör çekirdeği ve 82 RT çekirdeği bulunur; FP32 işlem gücü 35,6 TFLOPS'tur. Kart 350 W çeker ve PCIe 4.0 ile bağlanır. NVIDIA kartı 1 Eylül 2020'de duyurdu, 24 Eylül 2020'de 1.499 dolarlık önerilen fiyatla satışa çıktı; bugün artık üretilmiyor.
- Tensör performansı: NVIDIA'nın GA102 belgesine göre FP16 (FP16 biriktirme) 142 TFLOPS, seyreklikle 284 TFLOPS; BF16 ve FP32 biriktirmeli FP16 71 TFLOPS, seyreklikle 142 TFLOPS; INT8 284 TOPS.
- FP8 yok: Ampere'de FP8 tensör çekirdeği yoktur; bu destek Ada (RTX 4090, L40S) ve Blackwell (RTX 5060 Ti, RTX 5090, RTX PRO 4000, RTX PRO 5000) kartlarla gelir. vLLM, FP8 model dosyalarını Ampere'de yalnızca ağırlıkları 8-bit tutan W8A16 kipinde Marlin çekirdekleriyle çalıştırır: bellek ve bant genişliği kazancı olur, FP8 hesaplama hızlanması olmaz.
- ECC ve MIG yok: NVIDIA'nın özelliklerinde ECC bellek yer almaz; kart MIG ile bölünemez.
- NVLink: Köprü yalnızca iki kartı bağlar; üç ve dört kartlı bağlantı desteklenmez.
- Sürümler: NVIDIA'nın Founders Edition modeli üç yuvalı ve 313 mm uzunluğundadır; üretici modellerinde boyut, soğutma ve saat hızı değişir. RTX 3090 Ti ise ayrı bir karttır: 10.752 CUDA çekirdeği ve 450 W güç tüketimi. Bu sayfadaki değerler RTX 3090'a aittir.
RTX 3090 LLM'de saniyede kaç token üretir?
Tek bir istekte kart, ürettiği her token için model ağırlıklarının tamamını bellekten okur. Bu yüzden token üretim hızının teorik üst sınırı yaklaşık olarak bant genişliğinin ağırlık boyutuna bölümüdür. 936 GB/s ile bu sınırlar şöyledir (ağırlık boyutları VRAM hesaplayıcımızdan):
Bunlar ölçüm değil, hesaplanmış üst sınırlardır. Bağımsız bir ölçüm: XiongjieDai'nin GitHub'da yayımladığı, Mayıs 2024'te llama.cpp ile alınan testlerde (1.024 token üretimi) sonuçlar şöyle:
F16'da ölçülen hız, teorik sınırın yaklaşık %80'idir. Qwen3 30B-A3B gibi MoE modellerde, adındaki A3B'nin gösterdiği gibi her token için yalnızca yaklaşık 3 milyar parametre etkin olduğundan hız aynı boyuttaki yoğun modellerden belirgin şekilde yüksektir. Çok kullanıcılı servislerde vLLM gibi motorlar istekleri gruplayarak toplam verimi artırır; ayrıntılar inference optimizasyonu rehberimizde.
RTX 3090 mı, RTX 5090 mı, RTX PRO 4000 mi?
- RTX A5000: Aynı 24 GB ve aynı Ampere kuşağı, ancak ECC'li GDDR6 bellekli profesyonel bir kart; 230 W çeker ve çift yuvalıdır. Bant genişliği 768 GB/s olduğundan tek istekte token üretiminde RTX 3090 teorik olarak yaklaşık 1,2 kat öndedir; FP32 işlem gücü de RTX 3090'da daha yüksektir (35,6 TFLOPS'a karşı 27,8 TFLOPS). İkisinde de FP8 donanım desteği yoktur ve iki kart NVLink köprüsüyle bağlanabilir. Fiyatı RTX 3090 ile aynıdır: ECC'li bellek, daha düşük güç tüketimi ve profesyonel sürücü isteniyorsa A5000; aylık $300.
- RTX PRO 4000 Blackwell: Aynı 24 GB, ancak ECC'li GDDR7; FP8 ve FP4 destekli beşinci nesil tensör çekirdekleri, 145 W'lık tek yuvalı tasarım. Bant genişliği 672 GB/s olduğundan tek istekte token üretiminde RTX 3090 teorik olarak yaklaşık 1,4 kat öndedir. ECC, FP8/FP4 hesaplama ve düşük güç gerekiyorsa PRO 4000; aylık $450.
- RTX 5090: 32 GB GDDR7 ve 1.792 GB/s, yani yaklaşık 1,9 kat bant genişliği; FP8 ve FP4 destekler, 575 W çeker. Qwen3 32B'yi 4-bit'te 8.192 token bağlamla ya da Mistral Small 3.2 24B'yi 8-bit'te (27,5 GB) tek kartta çalıştırmak için; aylık $600.
- RTX PRO 5000: 48 GB ECC'li GDDR7 ve 1.344 GB/s, yani yaklaşık 1,4 kat bant genişliği; FP8 ve FP4 destekler, 300 W çeker ve MIG ile iki adet 24 GB'lık bölüme ayrılabilir. Qwen3 32B'yi FP8'de 8.192 token bağlamla (37,6 GB) çalıştırmak ya da Qwen3 14B'ye BF16 LoRA ince ayarı (34,6 GB) yapmak gibi 32 GB'ı aşan işler için; aylık $800.
- RTX 4090: 24 GB GDDR6X, 1.008 GB/s, FP8 destekli Ada kartı, 450 W. Bant genişliği RTX 3090'ınkinden yalnızca yaklaşık %8 yüksektir; yukarıdaki llama.cpp ölçümünde fark %14–17'dir. RTX 4090 kiralamıyoruz; bu sınıfta daha fazla bellek ve hız için RTX 5090'a, L40S ile farkı için RTX 4090 ile L40S karşılaştırmamıza bakın.
- RTX 5060 Ti: 16 GB'lık giriş kartımız; Whisper, TTS ve 4-bit 14B modeller yetiyorsa yeterlidir. Bant genişliği 448 GB/s'dir; Blackwell neslindendir ve FP4 destekler.
RTX 3090 kiralama fiyatı ne kadar, global bulutlarda ne kadar?
Bizde RTX 3090'ın aylık fiyatı GPU başına $300; yıllık kiralamada %20 indirimle aylık $240. Fiyatlar ABD doları cinsindendir ve KDV hariçtir; fatura, düzenlendiği günkü TCMB döviz satış kuruyla Türk lirası olarak kesilir. Kiralama en az 1 aydır, saat bazında kullanım sunmuyoruz; aylık fiyatın saatlik karşılığı (730 saat) yaklaşık $0,41.
Global GPU bulutlarında RTX 3090'ın saatlik fiyatları (getdeploying.com, 24 Ekim 2026):
Saatlik pazar yerleri, özellikle ayda birkaç saatlik ya da birkaç günlük kullanımda bizden daha ucuz olabilir; RTX 3090'ı ara sıra denemek için bunlar mantıklıdır. Fiyat ve stok anlık değişir; güncel durumu sağlayıcının sayfasından kontrol edin. Aylık paylaşımsız kiralamada ise fiyat ay boyunca sabittir, kart yalnızca size ayrılır, fatura Türk lirası kesilir, verileriniz Türkiye'de kalır ve SLA geçerlidir. Farkları bulut GPU ile fiziksel sunucu ve Colab ile GPU kiralama karşılaştırmalarımızda anlattık.
RTX 3090 satın alma fiyatı (Türkiye, Ekim 2026)
RTX 3090 artık üretilmediği için Türkiye'de stokta yeni kart bulmak zordur. 25 Ekim 2026'da derlediğimiz fiyatlar:
- Yeni: Vatan Bilgisayar'da MSI RTX 3090 Gaming X Trio sayfası 105.929 TL fiyatla "Tükendi" görünüyor (arama dizini kaydı; fiyatın tarihi belirsiz).
- İkinci el, Türkiye: Bulabildiğimiz tek ilan letgo'da 48.900 TL (4 Ağustos 2026, garantisiz).
- İkinci el, ABD: gpudojo'nun eBay verisine göre 24 Ekim 2026'da 104 ilanda medyan $1.790, en düşük $1.399. İkinci el fiyatlar 2026 boyunca yükseldi.
Kart tek başına çalışmaz: sunucu, kart başına 350 W'lık güç, soğutma, bağlantı ve bakım da size kalır. Hesabı GPU kiralama mı, satın alma mı rehberimizde örnekle anlattık.
Teslim, kurulum ve konum
- Paylaşımsız sunucu: Kiraladığınız kart başka müşterilerle paylaşılmaz; VPS ya da VDS değildir (farkı). Tek siparişte en fazla 8 GPU kiralayabilirsiniz.
- Siparişe göre kurulum: RTX 3090 sunucuları siparişe göre hazırlanır. Tek GPU'lu sunucuda 6 çekirdek CPU, 36 GB RAM, 1 TB SSD, size özel IP adresi vardır; GPU sayısı arttıkça işlemci çekirdeği ve RAM aynı oranda artar. Varsa NVLink köprüsü talebinizi sipariş formunun mesaj alanına yazın.
- Teslim: Teslim tarihini ödemeden sonra yazılı olarak bildiririz. Tarih 10 iş gününden fazla gecikirse siparişi iptal edip ödemenizin tamamını geri alabilirsiniz.
- Konum ve destek: Sunucular İstanbul Bağcılar'daki kendi tesisimizde çalışır, verileriniz Türkiye'de kalır (KVKK rehberimiz). Teslimden sonra aylık %99,5 erişilebilirlik hedefi, hizmet kredisi ve kritik arızalarda 7/24 telefon desteği geçerlidir (SLA ve destek).
Özet
- RTX 3090; 24 GB GDDR6X bellek, 936 GB/s bant genişliği ve 350 W güç tüketimine sahip Ampere mimarili bir karttır. ECC, MIG ve FP8 tensör çekirdeği yoktur.
- BF16'da 8B, 8-bit'te 14B, 4-bit'te Mistral Small 3.2 24B ve Qwen3 30B-A3B tek karta sığar; Qwen3 32B 4-bit 8.192 token bağlamda sınırı az farkla aşar.
- Tek istekte teorik hız sınırı Llama 3.1 8B için 4-bit'te saniyede yaklaşık 208, BF16'da yaklaşık 58 tokendir; Mayıs 2024 tarihli llama.cpp ölçümü Q4_K_M'de saniyede 111,7 token.
- Whisper, Chatterbox Multilingual ve küçük bir LLM aynı kartta çalışabilir.
- ECC, FP8/FP4 ve düşük güç için RTX PRO 4000; 32 GB ve daha yüksek hız için RTX 5090 daha uygundur.
- Bizde aylık $300; global bulutlarda saatlik medyan 24 Ekim 2026 itibarıyla $0,30.
Kaynaklar
24 GB belleğiyle RTX 3090 bu paketleri çalıştırır; sunucuyu yazılımlar kurulu teslim ederiz, kurulum ücretsizdir.