Ollama sunucu nedir, şirket içi ChatGPT için ne işe yarar?
Ollama + Open WebUI paketi, açık kaynak dil modellerini çalışanlarınızın tarayıcıdan ChatGPT'ye benzer bir arayüzle kullanmasını sağlayan hazır bir kurulumdur ve size ayrılmış bir GPU sunucusunda, İstanbul'daki tesisimizde kurulu olarak teslim edilir. Ollama modeli GPU'da çalıştırır; Open WebUI şifreli giriş, sohbet geçmişi, kullanıcı yönetimi ve şirket belgeleriyle soru-cevap (RAG) sunar. Sunucular İstanbul Bağcılar'daki kendi tesisimizde çalışır, verileriniz Türkiye'de kalır. Varsayılan model gpt-oss-20b'dir; 96 GB ve üzeri belleği olan kartlarda gpt-oss-120b de yüklü gelir.
Kendi ChatGPT'nizi kurmak için Docker, sertifika ve model indirmeyle uğraşmazsınız. Sunucu paylaşımsızdır, VPS değildir: GPU belleğinin tamamı sizin modellerinize ayrılır.
Pakette neler kurulu, hangi parça ne yapar?
Dört parça aynı sunucuda birlikte çalışır:
- Ollama modelleri indirir, GPU belleğine yükler ve yanıtı üretir. 11434 numaralı API portu internete açık değildir, yalnızca sunucunun kendi içinden erişilir.
- Open WebUI kullanıcıların gördüğü arayüzdür: sohbet, model seçimi, kullanıcı ve grup yetkileri, belge yükleme, bilgi koleksiyonları ve OpenAI uyumlu bir API. LDAP/Active Directory ve OAuth ile tek oturum açmayı da destekler. Lisansı BSD-3 tabanlıdır ama bir marka koşulu taşır: 30 günlük herhangi bir dönemde 50'den fazla son kullanıcısı olan kurulumlarda "Open WebUI" markasını kaldırmak ya da değiştirmek yazılı izin veya kurumsal lisans gerektirir (lisans açıklaması). Kurulumu markaya dokunmadan teslim ediyoruz; koşul ancak arayüze kendi logonuzu koymak isterseniz gündeme gelir.
- Caddy HTTPS ters vekilidir (reverse proxy). Sertifikayı alır ve yeniler, dışarıdan gelen trafiği yalnızca Open WebUI'a iletir; yani internetten görünen tek kapı şifreli giriş ekranıdır.
- bge-m3, BAAI'nin çok dilli gömme (embedding) modelidir. Belgelerinizi ve sorularınızı 1.024 boyutlu vektörlere çevirir, 100'den fazla dili ve 8.192 tokenlık girdiyi destekler; yoğun, seyrek ve çok vektörlü aramayı tek modelde yapar. Open WebUI'ın varsayılan gömme modeli olan İngilizce ağırlıklı all-MiniLM-L6-v2 yerine bunu ayarlı teslim ediyoruz.
İlk girişten sonra ne yapılır, yeni model nasıl eklenir?
Teslimde gönderdiğimiz yönetici hesabıyla HTTPS adresine girersiniz. Open WebUI, ilk hesap oluşturulduktan sonra kendiliğinden kaydı kapatır. Çalışanları yönetici panelindeki kullanıcılar bölümünden tek tek ekleyebilir ya da kaydı yeniden açıp yeni hesapları "beklemede" (pending) rolüyle onayınıza bırakabilirsiniz. Departmanlar için grup açın ve hangi modeli, hangi belge koleksiyonunu kimin göreceğini gruba göre belirleyin.
Yeni bir model eklemenin iki yolu var:
- Arayüzden: Yönetici ayarlarındaki Ollama bağlantısının Yönet (Manage) penceresine model adını yazın, örneğin
gemma4:26b. Hugging Face'teki GGUF dosyaları hf.co/{kullanici}/{depo}:{kuantizasyon} biçimiyle çekilir.
- SSH ile: Compose dizininde (servis adları README'de yazar):
docker compose exec ollama ollama pull qwen3:14b
docker compose exec ollama ollama ps
ollama ps çıktısındaki "Processor" sütunu 100% GPU göstermiyorsa modelin bir kısmı sistem belleğine taşmıştır ve yanıtlar belirgin biçimde yavaşlar. Bu durumda daha küçük bir model ya da daha kısa bir bağlam seçin.
Çalışma Alanı > Modeller (Workspace > Models) bölümünde bir temel modelin üzerine sistem istemi, bağlı bilgi koleksiyonu ve erişim grubu tanımlayarak "İK asistanı" ya da "teklif yazım asistanı" gibi özel asistanlar oluşturabilirsiniz. Kullanıcılar bunları model listesinde ayrı bir model olarak görür.
RAG nedir, şirket belgeleriyle nasıl sohbet edilir?
RAG (retrieval-augmented generation), soruyu modele göndermeden önce belgelerinizden ilgili parçaları bulup soruya ekleyen yöntemdir. Model yeniden eğitilmez; yalnızca o soruda bu parçalara bakarak yanıt verir, bu yüzden belge güncellendiğinde yeniden yüklemek yeter. Open WebUI'da akış şöyledir:
- Çalışma Alanı > Bilgi (Workspace > Knowledge) altında bir koleksiyon açın ve PDF, Word ya da metin dosyalarını yükleyin. Dosyalar parçalara bölünür ve bge-m3 ile vektöre çevrilir.
- Sohbette
# yazıp bir belgeyi ya da koleksiyonu seçin. İsterseniz koleksiyonu özel bir asistana bağlayın; o asistan her soruda koleksiyona bakar.
- Yanıtta kullanılan belge parçaları kaynak olarak gösterilir.
İki ayara dikkat edin. Gömme modelini sonradan değiştirirseniz bilgi koleksiyonlarını yeniden dizinlemeniz, sohbete tek seferlik yüklenen dosyaları da yeniden yüklemeniz gerekir. İsteğe bağlı hibrit arama, anlamsal aramaya BM25 anahtar kelime aramasını ekler ve sonuçları bir yeniden sıralayıcıyla (reranker) düzenler; ürün kodu ya da madde numarası gibi birebir eşleşme gereken sorularda işe yarar.
RAG istemi uzatır: soruya eklenen her parça bağlamdan yer kaplar. Ollama, bağlam uzunluğu belirtilmezse varsayılanı kartın belleğine göre seçer: 24 GiB'ın altında 4K, 24–48 GiB arasında 32K, 48 GiB ve üzerinde 256K token (Ollama belgeleri). Belgelerle çalışacaksanız OLLAMA_CONTEXT_LENGTH değerini açıkça ayarlayın ve aşağıdaki tabloda 32K sütununa bakın. Ayrı vektör veritabanı ve belge düzeyinde yetki gibi daha geniş bir mimari için kurumsal yapay zeka sayfamıza bakın.
Ollama API'ye nasıl bağlanılır?
Ollama'nın 11434 portu dışarıya açık değildir, çünkü kimlik doğrulaması olmayan bir model API'si internete açılmamalıdır. Programdan erişmenin iki yolu var.
Open WebUI API'si (HTTPS ve API anahtarı). Yönetici, kimlik doğrulama ayarlarında API anahtarlarını açar; kullanıcı Ayarlar > Hesap bölümünde sk- ile başlayan bir anahtar üretir. Anahtar, onu üreten kullanıcının yetkileriyle çalışır. Uç nokta OpenAI uyumludur (/api/chat/completions, model listesi için /api/models), bu yüzden OpenAI SDK'sı doğrudan kullanılabilir:
from openai import OpenAI

client = OpenAI(
    base_url="https://ai.sirketiniz.com.tr/api",  # teslimdeki HTTPS adresiniz
    api_key="sk-...",                            # Ayarlar > Hesap
)
yanit = client.chat.completions.create(
    model="gpt-oss:20b",
    messages=[{"role": "user", "content": "Bu sözleşme maddesini üç cümlede özetle: ..."}],
)
print(yanit.choices[0].message.content)
Bir bilgi koleksiyonunu API'den sorgulamak için isteğe "files": [{"type": "collection", "id": "<koleksiyon-id>"}] alanını eklersiniz; OpenAI SDK'sında bunu extra_body ile gönderin (API belgeleri).
SSH tüneli. Geliştirme makineniz ya da kendi betikleriniz için Ollama'ya şifreli bir tünelden bağlanabilirsiniz:
ssh -N -L 11434:localhost:11434 root@sunucu-adresiniz
Tünel açıkken OpenAI uyumlu adres http://localhost:11434/v1 olur. Ollama'nın bu uç noktası istemcide bir api_key değeri ister ama yerel kurulumda bu değeri yok sayar; erişimi tünelin kendisi korur.
Ollama, birkaç kişinin sohbet ettiği ve modellerin sık değiştiği kullanım için kolaydır. Uygulamanızın onlarca eşzamanlı isteği tek bir modele gönderdiği bir API ürünü kuruyorsanız sürekli toplu işleme (continuous batching) yapan vLLM paketimiz daha uygun olur.
Ollama kaç GB VRAM ister, hangi model hangi GPU'ya sığar?
Gereken bellek üç şeye bağlıdır: modelin boyutu ve kuantizasyonu, bağlam uzunluğu ve aynı anda işlenen istek sayısı. Ollama kütüphanesindeki varsayılan etiketler çoğunlukla 4-bit'tir (örneğin qwen3:14b indirmesi 9,3 GB); gpt-oss ise doğrudan MXFP4 biçiminde yayımlanır. Aşağıdaki değerler VRAM hesaplayıcımızdan alındı, KV önbelleğini ve çalışma payını içerir; kartın belleğinin %92'si kullanılabilir sayılır.
8K sütunu 16-bit, 32K sütunu 8-bit KV önbelleğiyle hesaplandı; Ollama'da 8-bit KV önbelleği OLLAMA_KV_CACHE_TYPE=q8_0 ayarıdır (varsayılan f16). Hesaplayıcıda açın: gpt-oss-20b, 8K, tek istek, gpt-oss-20b, 32K, 4 istek, Qwen3 30B-A3B, 32K, 4 istek.
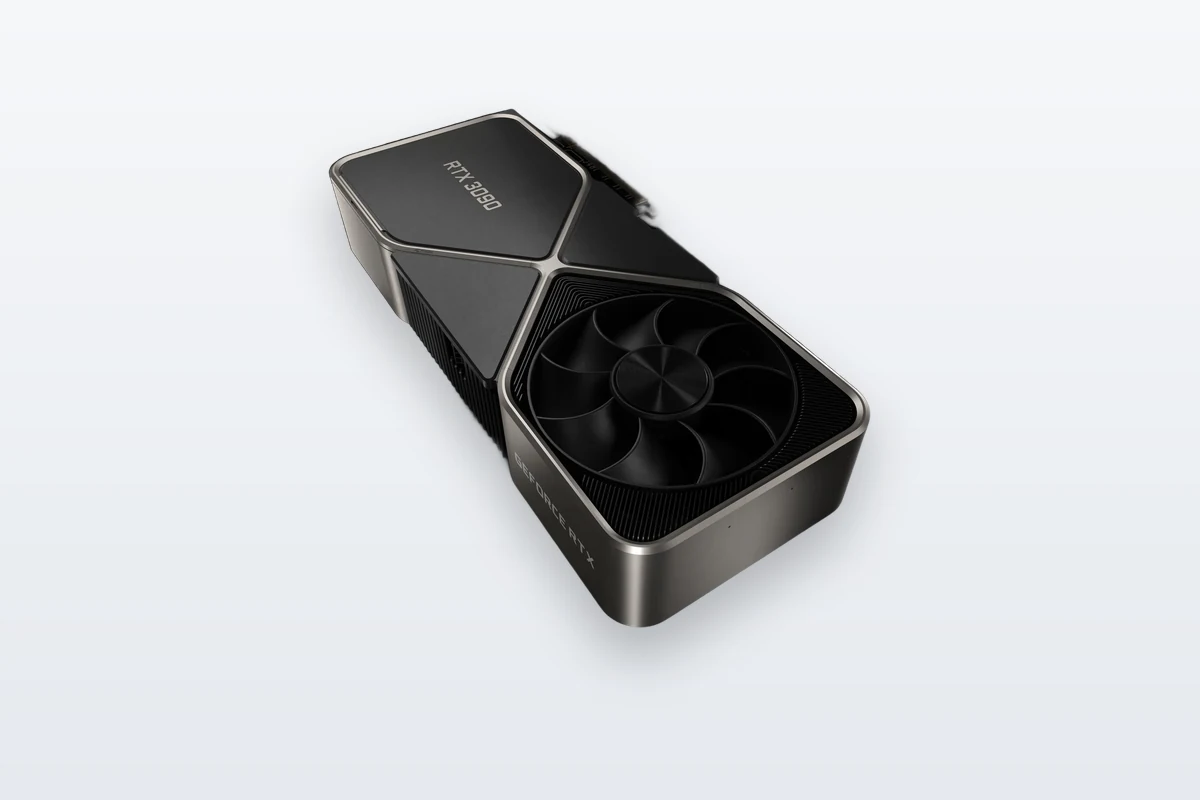
16 GB'lık kartta gpt-oss-20b, 8K bağlamda tek başına kullanılabilir 14,7 GB'ın 13,5 GB'ını doldurur; bge-m3'e ve uzun RAG istemlerine pek yer kalmaz. Tek kullanıcı için RTX 5060 Ti (aylık $200) yeterlidir; belgelerle çalışan bir ekip için 24 GB'lık RTX 3090 (aylık $300) ya da ECC'li RTX PRO 4000 daha rahat bir başlangıçtır. gpt-oss-120b için RTX PRO 6000 aylık $1.600. Fiyatlar GPU başına, aylık ve KDV hariçtir.
Kaç kişi aynı anda kullanabilir?
Belirleyici olan kayıtlı kullanıcı sayısı değil, aynı anda yanıt bekleyen istek sayısıdır. Ollama varsayılan olarak her model için tek isteği işler (OLLAMA_NUM_PARALLEL=1), diğerleri sıraya girer (Ollama SSS). Paralel istek sayısını artırdığınızda bağlam belleği de aynı oranda büyür; 4 paralel istek, 4 ayrı bağlam için yer ister. Kaba bir tahmin için en yoğun saatteki soru sayısını ortalama yanıt süresiyle (saniye) çarpıp 3.600'e bölün: saatte 240 soru ve ortalama 30 saniyelik yanıtlar, aynı anda ortalama 2 istek demektir. Ani yığılmalar için bu değerin üzerine pay bırakın.
Ollama aynı anda birden çok modeli bellekte tutabilir (varsayılan üst sınır GPU başına 3 model), ama hepsi aynı GPU belleğini paylaşır. Boşta kalan model varsayılan olarak 5 dakika sonra bellekten çıkar (OLLAMA_KEEP_ALIVE). Kullanıcılar sık model değiştiriyorsa kartı, açık tutmak istediğiniz modellerin toplamına göre seçin; yoksa modeller yeniden yüklenir ve ilk yanıt gecikir.
Hangi modeli seçmeli?
gpt-oss-20b ve gpt-oss-120b kaç GB?
OpenAI'ın Apache 2.0 lisanslı açık ağırlıklı modelleridir. gpt-oss-20b toplam 21B, token başına 3,6B aktif parametreli bir MoE modelidir; model kartı 16 GB bellekte çalışabildiğini belirtir, Ollama indirmesi 14 GB'tır. gpt-oss-120b toplam 117B, aktif 5,1B parametrelidir ve Ollama indirmesi 65 GB'tır. Model kartı tek bir 80 GB GPU'ya sığdığını söyler, ama KV önbelleğiyle 8K bağlamda 70,3 GB tutar; H100'ün kullanılabilir 73,6 GB'ında çok az pay kalacağı için gpt-oss-120b'yi 96 GB ve üzeri kartlarda kuruyoruz. Akıl yürütme düzeyi (low, medium, high) sistem isteminde ayarlanır, örneğin Reasoning: high; yüksek düzey daha geç yanıt demektir. Model kartı desteklenen dilleri listelemez, Türkçe kaliteyi kendi sorularınızla deneyin.
DeepSeek R1 kaç GB, sistem gereksinimleri neler?
"DeepSeek R1" adı iki farklı şeyi anlatır. Asıl model toplam 671B, aktif 37B parametreli bir MoE modelidir; 4-bit'te bile 8K bağlamda yaklaşık 398 GB ister (hesaplayıcıda açın) ve Ollama'daki deepseek-r1:671b indirmesi 404 GB'tır. Bu, en büyük kartımız H200'ün kullanılabilir 129,7 GB'ının üç katından fazladır; tek kartlı bir sunucuda çalışmaz. Çok GPU'lu bir kurulum bu paketin kapsamı dışındadır, ayrıntısı inference hizmetimizde. Tek kartta çalışanlar, R1'in çıktılarıyla eğitilmiş küçük "distill" modelleridir (Ollama kütüphanesi):
deepseek-r1:8b: DeepSeek-R1-0528-Qwen3-8B, 5,2 GB indirmedeepseek-r1:14b: DeepSeek-R1-Distill-Qwen-14B, 9,0 GBdeepseek-r1:32b: DeepSeek-R1-Distill-Qwen-32B, 20 GB
Bu üçü MIT lisanslıdır. Distill'ler yanıttan önce uzun bir düşünme metni üretir; bu metin bağlamda yer kaplar ve yanıt süresini uzatır, o yüzden 8K yerine 16–32K bağlam planlayın.
Qwen3 ve Qwen3.x
Alibaba'nın Qwen ailesi Apache 2.0 lisanslıdır ve tek kartta geniş bir seçenek sunar: Qwen3'ün 8B, 14B ve 32B yoğun modelleri ile toplam 30,5B, aktif 3,3B parametreli 30B-A3B MoE modeli. Model kartı 100'den fazla dil ve lehçeyi desteklediğini belirtir. Düşünme modu varsayılan olarak açıktır; isteme /no_think eklemek o turda kapatır. 30B-A3B'de token başına yalnızca 3,3B parametre çalıştığı için yoğun 32B modele göre genellikle daha hızlı yanıt üretir, ama modelin tamamı belleğe sığmalıdır (8K'da 19,8 GB). Daha yeni Qwen3.6-27B ve Qwen3.8-27B de Apache 2.0'dır; Qwen3.8-27B görsel girdi alır, 262.144 tokenlık yerel bağlam sunar ve Ollama indirmesi 18 GB'tır. Hesaplayıcıda satırı olmadığından 24 GB kartta kısa bağlamla başlayın, uzun belgeler için 32–48 GB seçin.
Gemma 4 nedir?
Gemma 4, Google DeepMind'ın Nisan 2026'da yayımladığı açık model ailesidir. Önceki Gemma sürümleri Google'ın kendi kullanım koşullarıyla dağıtılırken Gemma 4 Apache 2.0 ile yayımlandı. Beş boyutu var: E2B, E4B, 12B, 26B A4B (MoE) ve 31B. Küçük modeller 128K, 12B ve üstü 256K bağlam destekler; hepsi metin ve görsel girdi alır, model kartı ön eğitimde 140'tan fazla dil kullanıldığını belirtir. Ollama indirmesi 26B için 16–19 GB, 31B için 19–20 GB'tır. 24 GB'lık kart kısa bağlam için alt sınırdır; RAG ve birden çok kullanıcı için 32 GB ya da 48 GB seçin.
Mistral Small 3.2
24B parametreli, Apache 2.0 lisanslı bir modeldir; görsel girdi ve araç çağırma (function calling) destekler. Model kartı 3.2'yi talimat takibini iyileştiren ve sonu gelmeyen tekrarlı çıktıları azaltan küçük bir güncelleme olarak tanımlar; önceki 3.1 sürümünün kartı Türkçeyi desteklenen diller arasında sayar. Ollama'da 15 GB indirme ve 128K bağlamla gelir. 8K bağlamda 16,5 GB istediği için 16 GB kartlara sığmaz.
Türkçe LLM modelleri: Kumru ve Trendyol-LLM
- Kumru-2B: VNGRS'in Türkçe için sıfırdan eğittiği modelin açık, 2B parametreli talimat sürümüdür. 500 GB'lık temizlenmiş derlemde 300 milyar tokenla ön eğitim almış, 1 milyon örnekle ince ayarlanmıştır; lisansı Apache 2.0'dır. Yerel bağlamı 8.192 token olduğundan uzun belgelerle RAG'de sınırlıdır; kısa özet ve sınıflandırma gibi işlerde büyük bir modelin yanında ikinci model olarak çalışabilir. "Kumru yapay zeka" denince akla gelen 7B sürüm için model kartı yalnızca bir demoya bağlantı verir; bu sürümün ağırlıkları kartta yayımlanmamıştır.
- Trendyol-LLM-8B-T1: Qwen3-8B tabanlı, Türkçe e-ticaret verisiyle eğitilmiş, Türkçe ve İngilizce bir sohbet modelidir; özetleme, sınıflandırma ve ürün özelliği çıkarma gibi işleri hedefler. 32K'ya kadar yerel bağlam sunar ve tabanı gibi Apache 2.0 lisanslıdır. Ollama için GGUF sürümleri topluluk dönüşümleridir ve
hf.co/... biçimiyle çekilir.
Türkçe kalite için kesin bir sıralama veremiyoruz. Bağımsız bir ölçüt olarak Cetvel'e bakılabilir: EACL 2026'da yayımlanan bu Türkçe değerlendirme setinde Türkçeye göre ince ayarlanmış modeller, çoğu görevde Llama 3 ve Mistral gibi genel amaçlı çok dilli modellerin önüne geçemedi (makale). Çalışma, yayımlandığı tarihteki modellerle sınırlıdır. Pratik yol şudur: kendi belgelerinizden 30–50 soru hazırlayın, Open WebUI'da aynı sohbette iki üç modeli birlikte seçip yanıtları yan yana karşılaştırın.
Ne kurulmuyor ve neden?
Root erişiminiz olduğu için aşağıdakileri kendi lisans koşullarınıza uyarak kurabilirsiniz; biz pakete eklemiyoruz:
- n8n: Sustainable Use License ile dağıtılır. Yazılım yalnızca kendi iç iş amaçlarınız ya da ticari olmayan kullanım için kullanılabilir ve başkalarına ancak ücretsiz, ticari olmayan amaçla sağlanabilir (lisans metni); bu yüzden ücretli bir hizmetin parçası olarak kurmuyoruz. Şirketinizin iç otomasyonları için kendiniz kurabilirsiniz: n8n'in Ollama Chat Model düğümünü sunucu içinden Ollama'ya bağlayın ya da OpenAI uyumlu bağlantıya Open WebUI API anahtarını girin.
- Flowise: Apache 2.0 lisanslıdır ama proje kapatıldı. Geliştirme Temmuz 2026'da donduruldu, GitHub deposu Ağustos 2026'da salt okunur arşive alındı ve çekirdek ekibin desteği 31 Ağustos 2026'da sona erdi (duyuru). Güvenlik güncellemesi almayan bir aracı şirket verisine bağlamıyoruz.
- Llama tabanlı modeller (örneğin Llama 3.3 70B tabanlı
deepseek-r1:70b): Meta'nın Llama lisansı MIT ya da Apache 2.0 gibi serbest değildir, ek koşullar taşır; varsayılan olarak yüklemiyoruz.
- Ollama bulut modelleri (
:cloud etiketliler): Sizin GPU'nuzda değil Ollama'nın bulutunda çalışır, istem ve yanıtlar sunucudan çıkar. Teslim edilen kurulumda oturum açılmış bir Ollama hesabı ve tanımlı bir bulut modeli yoktur. Verinin yurt dışına aktarımıyla ilgili çerçeve için KVKK rehberimize bakın; kendi veri işleme faaliyetinizi hukuk ekibinizle değerlendirin.