Kurumsal yapay zeka nedir?
Kurumsal yapay zeka, şirketin kendi belgeleri ve iş süreçleriyle çalışan, erişimini şirketin yönettiği yapay zeka uygulamalarıdır; en yaygın örneği iç belgelerden kaynak göstererek yanıt veren şirket içi asistandır. Bu asistanı açık bir dil modeli ve RAG ile size ayrılmış, aylık kiralık bir GPU sunucusunda çalıştırdığınızda belgeler ve istemler yurt dışındaki bir API'ye gitmez; veriler İstanbul Bağcılar'daki tesisimizde, Türkiye'de kalır.
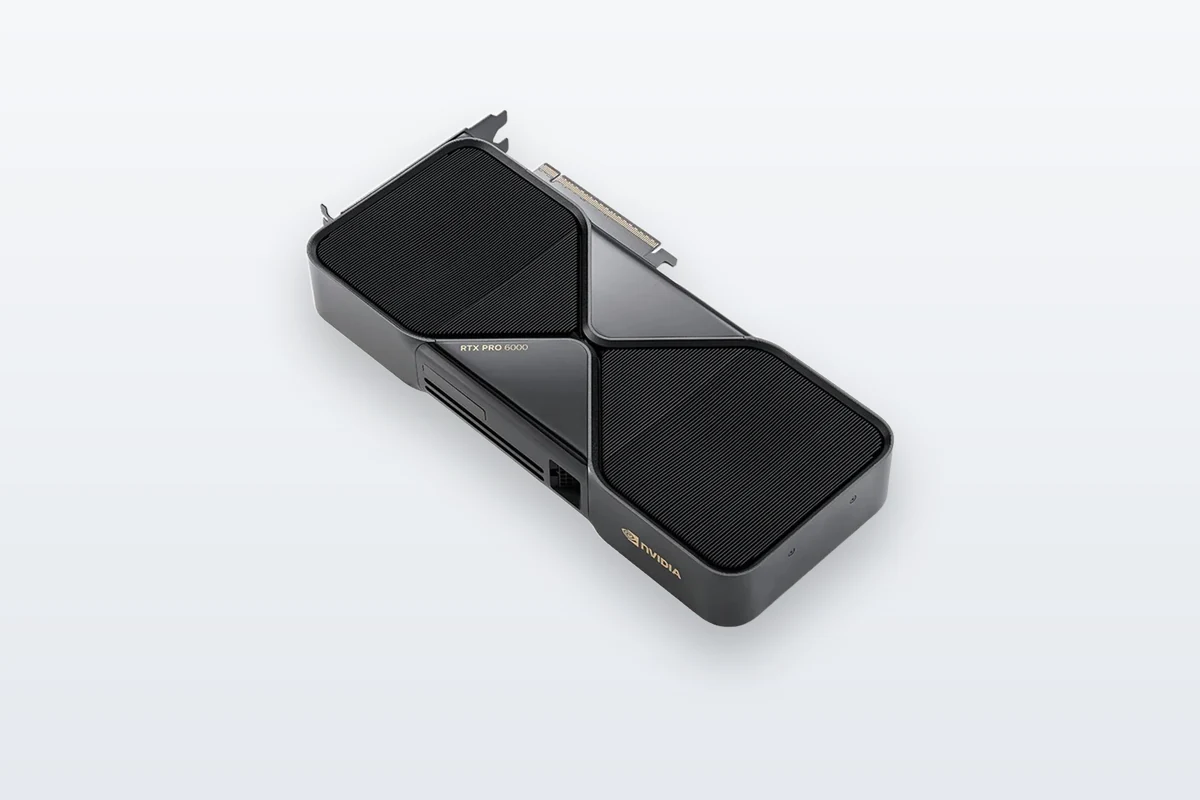
Böyle bir asistan beş parçadan oluşur: açık ağırlıklı bir dil modeli (LLM), onu API olarak sunan bir servis motoru, belgelerinizi aranabilir kılan bir gömme (embedding) modeli, bir vektör veritabanı ve çalışanların kullandığı sohbet arayüzü. Sunucuyu kayıtlı kullanıcı sayısı değil, aynı anda yanıt bekleyen istek sayısı belirler: 8.192 token bağlam ve FP8 KV önbelleğiyle Qwen3 32B, 32 eşzamanlı istekte 69,8 GB ister ve tek bir RTX PRO 6000'e sığar.
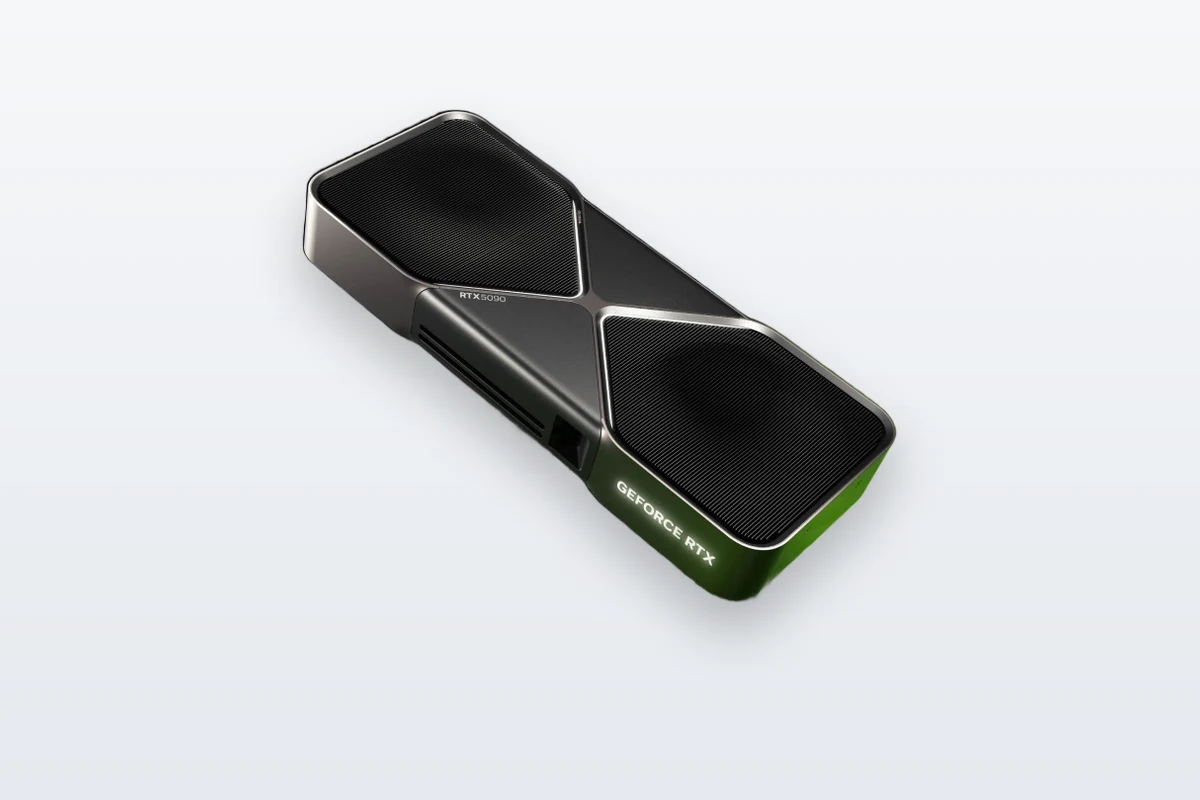
- Pilot ya da tek departman (16 eşzamanlı isteğe kadar): Qwen3 14B FP8 27,3 GB ister; RTX 5090 aylık $600, ECC'li bellekle L40S aylık $900.
- Şirket geneli asistan (32 eşzamanlı istek, 24–32B model ya da gpt-oss-120b): RTX PRO 6000, aylık $1.600.
- 70B sınıfı model: Llama 3.3 70B FP8, 16–32 istekte 96,6–118,1 GB ister; H200 aylık $3.000.
- Fiyatlar GPU başına, aylık, ABD doları cinsinden ve KDV hariçtir; yıllık kiralamada %20 indirim uygulanır.
Şirkete özel yapay zeka asistanı hangi parçalardan oluşur?
Beş katmanın hepsinde ticari kullanıma açık, açık kaynak seçenekler bulunur; ama birkaçının lisans koşulunu okuyun.
Seçerken dikkat edilecekler:
- Gömme modelinin girdi sınırı: BGE-M3 100'den fazla dili ve 8.192 tokenlık girdiyi destekler, 1.024 boyutlu vektör üretir; yoğun, seyrek ve çok vektörlü aramayı aynı modelde sunar. multilingual-e5-large-instruct 512 tokenın ötesini keser; parçaları buna göre kısa tutun. Qwen3-Embedding'in 0,6B, 4B ve 8B sürümleri 32K token kabul eder.
- Vektör boyutu: pgvector'da HNSW indeksi
vector tipinde en fazla 2.000, halfvec tipinde 4.000 boyutu destekler. Qwen3-Embedding-8B'nin 4.096 boyutlu çıktısını indekslemek için boyutu, modelin desteklediği MRL yöntemiyle küçültün. Qdrant, yoğun ve seyrek vektörlerle hibrit aramayı ve alan (payload) filtrelemeyi destekler.
- Arayüz: Open WebUI, vLLM gibi OpenAI uyumlu API'lere bağlanır; yerleşik RAG, hibrit arama ve yeniden sıralama (reranking), LDAP/Active Directory, OAuth ile tek oturum açma (SSO) ve SCIM 2.0 sunar. Lisansı BSD-3 tabanlıdır ama marka koşulu taşır: 30 günlük herhangi bir dönemde 50'den fazla son kullanıcısı olan kurulumlarda "Open WebUI" markasını kaldırmak ya da değiştirmek için yazılı izin ya da kurumsal lisans gerekir. MIT lisanslı LibreChat da OpenAI uyumlu API'lere bağlanır; LDAP ve OAuth2 ile girişi ve ayrı bir RAG API bileşenini destekler.
RAG nedir, ince ayardan farkı ne?
RAG (retrieval-augmented generation, geri getirmeyle zenginleştirilmiş üretim), her soruda ilgili belge parçalarını bulup modele bağlam olarak verir ve modelin ağırlıklarını değiştirmez; ince ayar (fine-tuning) ise modeli kendi verinizle yeniden eğitip davranışını kalıcı olarak değiştirir.
RAG üç adımda çalışır:
- Belgeler parçalara bölünür, gömme modeliyle vektöre çevrilir ve veritabanına yazılır.
- Soru da vektöre çevrilir; en yakın parçalar bulunur, istenirse yeniden sıralanır.
- Parçalar soruyla birlikte LLM'e verilir; model, kaynaklarını gösteren bir yanıt üretir.
RAG ile başlayın; ince ayarı, RAG'in çözemediği üslup ve görev uyarlamaları için kullanın (LLM ince ayarı hizmetimiz). RAG istemleri uzatır: beş adet 500 tokenlık parça her soruya 2.500 token ekler. Aşağıdaki boyutlandırma 8.192 token bağlam varsayar; daha uzun istemler için hesaplayıcıda bağlamı artırın.
RAG için GPU gerekir mi?
Belgeleri dizinleyen ve arayan kısım için çoğu zaman gerekmez; birden çok çalışanın aynı anda soru sorduğu bir asistanda yanıtı üreten dil modeli için gerekir. Open WebUI'ın standart Docker imajı gömme modelini CPU'da çalıştırır; :cuda imajı yerel gömme modelini ve Whisper'ı GPU'da hızlandırır.
GPU'nuz varsa küçük bir gömme modeli dil modeliyle aynı kartta çalışabilir; belleği nasıl paylaştıracağınız aşağıdaki boyutlandırma bölümünde.
Hangi açık model Türkçede iyi sonuç verir?
Tek bir doğru cevap yok: çok dilli genel modeller Türkçede genellikle Türkçeye özel modellerden daha iyi sonuç veriyor, ama kendi belgelerinizle test etmeden karar vermeyin.
- Bağımsız değerlendirme: Türkçe için hazırlanan 23 görevlik Cetvel değerlendirme seti (EACL 2026), 70B'ye kadar 33 açık modeli karşılaştırdı. Türkçeye özel talimat ince ayarlı modeller, Llama 3 ve Mistral gibi çok dilli ya da genel amaçlı modellerin genellikle gerisinde kaldı. Değerlendirilen modeller bugünkü sürümlerden eskidir.
- Qwen: Qwen3, listesinde Türkçenin açıkça yer aldığı 119 dil ve lehçeyi destekler; Qwen3.5'in model kartı 201 dil ve lehçe belirtir. Qwen3.6-27B Nisan 2026'da, Qwen3.8-27B Ağustos 2026'da Apache 2.0 lisansıyla yayımlandı; ikisi de 262.144 tokenlık yerel bağlam sunar.
- Mistral Small 3.2 (24B): Apache 2.0. Model kartı 3.2'yi 3.1'in küçük bir güncellemesi olarak tanımlar; 3.1'in kartı Türkçeyi desteklenen diller arasında sayar.
- Gemma 4 31B ve gpt-oss: İkisi de Apache 2.0. Gemma 4'ün model kartı 140'tan fazla dil belirtir; gpt-oss'un kartı dil listesi vermez.
- Llama 3.3 70B: Resmi olarak desteklenen sekiz dil arasında Türkçe yoktur. Lisansı, modeli içeren bir ürün ya da hizmeti dağıtır veya kullanıma sunarsanız "Built with Llama" ibaresini göstermenizi ister; model yayımlandığında 700 milyondan fazla aylık aktif kullanıcısı olan şirketler Meta'dan ayrıca lisans almalıdır.
- Türkçeye özel modeller: VNGRS'in Türkçe için sıfırdan eğittiği Kumru'nun 2B sürümü Apache 2.0 lisansıyla açıktır; bağlamı 8.192 tokendır. 7,4B sürüm için model kartı yalnızca bir demoya bağlantı veriyor. Trendyol-LLM-Asure-12B ise Gemma 3 12B tabanlıdır, Türkçe ve İngilizce e-ticaret görevlerine odaklanır ve Gemma lisansıyla dağıtılır.
Kendi belgelerinizden 50–100 soru ve beklenen yanıt hazırlayıp iki üç modeli aynı RAG düzeniyle karşılaştırın. Qwen3.6-27B için hesaplayıcıdaki Qwen3 32B satırını kaba bir üst sınır olarak kullanabilirsiniz: ağırlıklar daha küçüktür, hibrit dikkat mimarisi sayesinde KV önbelleği de daha az yer tutar.
Kaç kullanıcıya hangi GPU yeter?
Kayıtlı kullanıcı sayısına değil, en yoğun saatte aynı anda yanıt üretilen istek sayısına göre seçin.
Eşzamanlı istek sayısını kabaca şöyle tahmin edebilirsiniz: en yoğun saatteki soru sayısı × ortalama yanıt süresi (saniye) ÷ 3.600. Örneğin en yoğun saatte 900 soru alan ve yanıtları ortalama 20 saniye süren bir asistan için bu 900 × 20 ÷ 3.600 = 5 eşzamanlı istek eder. Bulduğunuz değerin üzerine pay bırakın.
Değerler VRAM hesaplayıcımızla hesaplandı; hesaplayıcı kartın belleğinin %92'sini kullanılabilir sayar, vLLM de varsayılan olarak bu oranı ayırır. Gömme modeli LLM'e göre küçüktür (Qwen3-Embedding'in en küçüğü 0,6B parametre) ve aynı kartta çalıştırılabilir: iki vLLM sürecinin --gpu-memory-utilization değerlerini paylaştırın ya da RTX PRO 6000'i MIG ile 2 × 48 GB'a bölün (bu durumda dil modeline 48 GB kalır). Motor ayarları ve kapasite ölçümü LLM inference hizmet sayfamızda. Llama 3.3 70B FP8 16 eşzamanlı istekte 96,6 GB ister; bu yükte tek bir H100'e sığmaz (iki kartın farkı için H100 mü, H200 mü? karşılaştırmamıza bakın).
Şirkete özel yapay zeka asistanı nasıl kurulur?
Yazılımı kendi ekibiniz ya da yazılım firmanız kurar; biz size ayrılmış GPU sunucusunu sağlarız. Kurulum kabaca beş adımdır:
- Kapsam: Hangi belgelerin kullanılacağını, kimin neyi görebileceğini ve en yoğun saatteki eşzamanlı istek sayısını yazın.
- Model ve GPU: Yukarıdaki tablodan başlayın.
- API: vLLM, modeli varsayılan olarak 8000 numaralı portta OpenAI uyumlu bir API olarak sunar; konteyner kullanacaksanız önce NVIDIA Container Toolkit kurulumunu tamamlayın.
- Arayüz ve gömme modeli: Open WebUI'ın varsayılan gömme modeli İngilizce için eğitilmiş all-MiniLM-L6-v2'dir. Türkçe belgeler için BGE-M3 gibi çok dilli bir modeli belgeleri yüklemeden önce seçin; sonradan değiştirirseniz belgeleri yeniden dizinlemeniz gerekir.
- Erişim ve ölçüm: API portunu internete açmayın, arayüzü VPN ya da kimlik doğrulamalı bir ters vekil (reverse proxy) arkasına alın ve yanıtları kendi belgelerinizden hazırladığınız 50–100 soruluk test setiyle ölçün.
Kurumsal yapay zeka çözümleri: hazır plan mı, kendi sunucunuz mu?
Kurumsal yapay zeka çözümleri üç gruba ayrılır: hazır kurumsal asistan planları (ör. ChatGPT Enterprise, Microsoft Copilot), bir yazılım firmasının kurduğu anahtar teslim projeler ve size ayrılmış bir GPU sunucusunda açık modelle çalışan asistanlar; biz üçüncü yol için sunucuyu aylık kiralıyoruz. Yaygın kullanım alanları belgeler üzerinde soru-cevap, destek taleplerini özetleme, kod asistanı, toplantı kayıtlarını yazıya çevirme ve belgelerden veri çıkarmadır; sektöre özel örnekler finans ve bankacılıkta yapay zeka sayfamızda.
En güçlü kapalı modeller zor işlerde genellikle daha iyi sonuç verir; kendi sunucunuz ise veri kontrolü, sabit maliyet ve verinin Türkiye'de kalmasını sağlar.
İki yol birlikte de kullanılabilir: kişisel veri ve ticari sır içermeyen işlerde kurumsal bir API'ye izin verip müşteri dosyalarını, insan kaynakları verilerini ve iç yazışmaları kendi sunucunuzdaki asistana yönlendirebilirsiniz. Çok GPU'lu ya da MIG'li bir yapılandırma gerekiyorsa bunu sipariş formundaki mesaj alanına yazın.
KVKK açısından kısa not
Kişisel veri içeren istemleri ya da belgeleri yurt dışındaki bir yapay zeka servisine göndermek KVKK'ya göre yurt dışına aktarımdır ve 7499 sayılı Kanun'la değişen, 1 Haziran 2024'ten beri uygulanan 9. maddeye tabidir; Kurum'un aktarım rehberi arızi aktarımı "süreklilik arz etmeyen" haller olarak tanımladığı için her gün kullanılan bir asistan bu istisnaya girmez. Kurum'un 24 Kasım 2025 tarihli üretken yapay zeka rehberi aynı kuralı hatırlatır; 5 Mart 2026'da duyurduğu iş yerleri dokümanı da çalışanların bu araçları çoğu zaman tanımlı bir kurumsal politika olmadan kullandığına dikkat çeker. Veriyi Türkiye'de işlediğinizde yurt dışına aktarım gündeme gelmez, ama aydınlatma, hukuki sebep, veri güvenliği ve veri işleme sözleşmesi gibi yükümlülükler sürer; ayrıntılar KVKK ve yapay zeka rehberimizde, sağlayıcıya sorulacak sorular kurumsal GPU kiralama güvenlik rehberimizde.
Bu bölüm genel bilgi amaçlıdır, hukuki tavsiye değildir. Uyum değerlendirmesi kendi veri işleme süreçlerinize bağlıdır; projenize özel değerlendirme için bir KVKK uzmanına danışın.
Şirket içi yapay zeka sunucusu ne zaman mantıklı?
Kişisel ya da gizli veriyle her gün çalışan bir asistan için mantıklıdır; az kullanıcılı ve hassas veri içermeyen işler için çoğu zaman değildir.
- Mantıklı olduğu durumlar: Müşteri ve iç verinizi yurt dışına göndermek istemiyor ya da gönderemiyorsanız, asistan her gün düzenli kullanılıyorsa ve bütçeyi kullanıcı sayısından bağımsız, aylık sabit tutmak istiyorsanız. Fiyatlar ABD doları cinsindendir; fatura, fatura tarihindeki TCMB döviz satış kuruyla Türk lirası olarak kesilir.
- Mantıklı olmadığı durumlar: Birkaç kişilik bir ekip hassas veri içermeyen işler için asistan arıyorsa kurumsal bir API planı daha hızlı ve muhtemelen daha ucuz bir çözümdür. En güçlü kapalı modellere ihtiyacınız varsa ya da yazılımı kurup güncelleyecek bir ekibiniz yoksa da API daha uygundur; yönetilen hizmet sunmuyoruz.
- Satın alma: Donanımı satın almak, tam kullanımda uzun vadede daha ucuz olabilir; hesabını kiralama mı, satın alma mı yazımızda bulabilirsiniz.
Özet
- Şirkete özel asistan açık model, servis motoru, gömme modeli, vektör veritabanı ve arayüzden oluşur; hepsi kendi sunucunuzda çalışınca veriler Türkiye'de kalır.
- RAG ile başlayın; Türkçe başarımı modele göre değiştiği için modeli kendi belgelerinizden hazırladığınız bir test setiyle seçin.
- RAG'in arama tarafı (gömme modeli, vektör veritabanı, arayüz) CPU'da çalışabilir; çok kullanıcılı bir asistanda yanıtı üreten dil modeli için GPU gerekir.
- Boyutu eşzamanlı istek belirler: 32 istekte Qwen3 32B FP8 tek RTX PRO 6000'e (69,8 GB), Llama 3.3 70B FP8 tek H200'e (118,1 GB) sığar.
- Yurt dışındaki bir API'ye kişisel veri göndermek KVKK m.9 kapsamında aktarımdır; Türkiye'de işlemek bu soruyu kaldırır, diğer yükümlülükleri kaldırmaz.
Kaynaklar