
RTX 5090 vs H100
RTX 5090 mı, H100 mü? LLM İçin 32 GB ile 80 GB Arasındaki Fark
Modeliniz 32 GB'a sığıyorsa RTX 5090 inference, görüntü üretimi ve video işlerini çok daha düşük maliyetle yapar. 32 GB'ı aşan modeller, çok kullanıcılı servisler, tam ince ayar ve NVLink'li çok GPU'lu eğitim için 80 GB HBM bellekli, MIG destekli H100 doğru seçimdir.
Teknik özellikler
| Özellik | NVIDIA GeForce RTX 5090 | NVIDIA H100 |
|---|---|---|
| Mimari | Blackwell (2025) | Hopper (2022) |
| GPU belleği | 32 GB GDDR7 | 80 GB HBM2e / HBM3 2,5 kat |
| Bellek bant genişliği | 1.792 GB/s | 2.000–3.350 GB/s en az 1,1 kat |
| FP32 performansı | 104,8 TFLOPS en az 1,6 kat | 51–67 TFLOPS |
| Tensör performansı | 3.352 TOPS FP4 (seyreklikli) | 1.513–1.979 TFLOPS FP8 · 756–989 TFLOPS BF16 (seyrekliksiz) |
| En yüksek güç | 575 W | 300–700 W |
| GPU'lar arası bağlantı | Yok (yalnızca PCIe) | NVLink, sürüme göre 600–900 GB/s |
| PCIe | PCIe 5.0 x16 | PCIe 5.0 x16 |
| MIG (bölümleme) | Yok | 7 bölüme kadar |
| ECC bellek | Yalnızca yonga içi (GDDR7) | Var |
| Form faktörü | PCIe, GeForce kartı | SXM5 veya PCIe |
| Aylık kiralama | $600 / ay GPU başına, KDV hariç · saatlik karşılığı $0,82 | $2.500 / ay GPU başına, KDV hariç · saatlik karşılığı $3,42 |
Teknik değerler üreticilerin yayımladığı verilerdir. Tensör değerlerinde hassasiyet (FP4, FP8, BF16) ve seyreklik farklı olduğunda sayılar doğrudan karşılaştırılamaz. Aralık olarak verilen değerler kartın sürümüne göre değişir; fark rozetleri en elverişsiz durumu esas alır.
Kısa cevap
Modeliniz 32 GB'a sığıyorsa RTX 5090 yeterlidir: FP8'de 24B'ye, 4-bit'te 32B'ye kadar modellerle inference, görüntü üretimi ve video kodlama işlerini çok daha düşük aylık maliyetle yapar. 32 GB'ı aşan modeller, çok kullanıcılı uzun bağlamlı servisler, tam ince ayar ve NVLink gerektiren çok GPU'lu eğitim için 80 GB HBM bellekli, MIG destekli H100 doğru seçimdir.
Bizde RTX 5090 aylık $600, H100 aylık $2.500 (GPU başına, KDV hariç). İki kart aynı sınıftan değildir: RTX 5090 Blackwell mimarili bir GeForce kartı, H100 ise Hopper mimarili bir veri merkezi GPU'sudur. Bu yüzden asıl soru "hangisi daha hızlı" değil, "işim 32 GB'a sığıyor mu ve H100'ün veri merkezi özelliklerine ihtiyacım var mı" sorusudur.
RTX 5090 ile H100 arasındaki fark nedir?
Üstteki tabloda FP32 satırında RTX 5090 önde görünür. Bu, render ve klasik CUDA işlerinde kullanılan tensör dışı hesaptır; yapay zeka iş yükleri ise tensör çekirdeklerinde çalışır. İki kartın tensör değerleri farklı hassasiyet ve seyreklikle yayımlandığı için aşağıda aynı hassasiyetteki değerleri seyrekliksiz olarak yan yana koyduk:
| Özellik | RTX 5090 | H100 (sürüme göre) | Önde olan |
|---|---|---|---|
| Bellek | 32 GB GDDR7 | 80 GB HBM | H100, 2,5 kat |
| Bellek bant genişliği | 1.792 GB/s | 2.000–3.350 GB/s | H100, 1,1–1,9 kat |
| BF16 tensör (FP32 biriktirmeli) | 209,5 TFLOPS | 756–989 TFLOPS | H100, 3,6–4,7 kat |
| FP8 tensör | 419–838 TFLOPS | 1.513–1.979 TFLOPS | H100, 1,8–4,7 kat |
| FP4 tensör | 1.676 TFLOPS | Desteklemez | RTX 5090 |
| FP32 (tensör dışı) | 104,8 TFLOPS | 51–67 TFLOPS | RTX 5090, 1,6–2,1 kat |
| FP64 (tensör dışı) | Yaklaşık 1,6 TFLOPS | 26–34 TFLOPS | H100 |
| GPU'lar arası bağlantı | Yalnızca PCIe 5.0 | NVLink, 600–900 GB/s | H100 |
| Video kodlama (NVENC) | 3 motor | Yok | RTX 5090 |
| ECC ve bellek hata yönetimi | Yalnızca GDDR7 yongasının içinde, her zaman açık ECC (tek bit düzeltme) | HBM'de ECC, hata kaydı ve bozuk satırların yeniden eşlenmesi | H100 |
| MIG (bölümleme) | Yok | 7 bölüme kadar | H100 |
RTX 5090'ın FP8 değeri biriktirme hassasiyetine göre değişir: FP32 biriktirmede 419, FP16 biriktirmede 838 TFLOPS. RTX 5090'da FP64 hızı FP32'nin 1/64'ü kadardır. H100'ün tensör değerleri, NVIDIA'nın seyreklikli olarak yayımladığı değerlerin yarısıdır.
32 GB ne zaman yeter? Hangi model hangi karta sığar?
Değerler VRAM hesaplayıcımızla hesaplandı: 8.192 token bağlam, tek eşzamanlı istek ve BF16 KV önbelleği. Kartın belleğinin yaklaşık %92'si iş yüküne ayrılabilir; bu RTX 5090'da yaklaşık 29,4 GB, H100'de yaklaşık 73,6 GB eder. Birden fazla kart gerektiğinde hesaplayıcı sayıyı 2, 4 ya da 8'e yuvarlar; tensör paralellikte model kartlara genellikle bu sayılarda bölünür.
| Model | Hassasiyet | Gereken bellek | RTX 5090 | H100 |
|---|---|---|---|---|
| Llama 3.1 8B | BF16 | 18,9 GB | 1 kart | 1 kart |
| Qwen3 14B | FP8 | 17,9 GB | 1 kart | 1 kart |
| Qwen3 14B | BF16 | 33,4 GB | 2 kart | 1 kart |
| gpt-oss-20b (MoE) | 4-bit (MXFP4) | 13,5 GB | 1 kart | 1 kart |
| Mistral Small 3.2 24B | FP8 | 27,5 GB | 1 kart, pay az | 1 kart |
| Qwen3 30B-A3B (MoE) | FP8 | 33,8 GB | 2 kart | 1 kart |
| Qwen3 32B | 4-bit | 22,5 GB | 1 kart | 1 kart |
| Qwen3 32B | FP8 | 37,6 GB | 2 kart | 1 kart |
| Qwen3 32B | BF16 | 72 GB | 4 kart | 1 kart, sınırda |
| Llama 3.3 70B | 4-bit | 45,4 GB | 2 kart | 1 kart |
| Llama 3.3 70B | FP8 | 77,8 GB | 4 kart | 2 kart |
| gpt-oss-120b (MoE) | 4-bit (MXFP4) | 70,3 GB | 4 kart | 1 kart |
| Qwen3 235B-A22B (MoE) | 4-bit | 141,4 GB | 8 kart | 2 kart |
Tablodan çıkan kural: Tek RTX 5090'a FP8'de yaklaşık 24B'ye, 4-bit'te yaklaşık 32B'ye kadar modeller sığar. Tek H100'e ise BF16'da 32B, 4-bit'te 70B sınıfı modeller ve gpt-oss-120b sığar; OpenAI da model kartında gpt-oss-120b'nin H100 gibi tek bir 80 GB GPU'ya sığdığını belirtir.
Bu değerler tek istek içindir. KV önbelleği eşzamanlı istek sayısı ve bağlam uzunluğuyla doğru orantılı büyür. 32 GB'lık kartta ağırlıklardan sonra kalan pay küçük olduğu için çok kullanıcılı ya da uzun bağlamlı bir serviste bellek H100'e göre çok daha erken biter. Kendi senaryonuzu hesaplayıcıda deneyin; hesaplayıcı her kart için gereken GPU sayısını ve aylık toplamı da gösterir.
LLM için RTX 5090 mı, H100 mü?
Model iki karta da sığıyorsa fark işin türüne göre değişir:
- Tek kullanıcı, düşük trafik: Token üretimi (decode) bellek bant genişliğiyle sınırlıdır, çünkü her yeni token için ağırlıklar bellekten yeniden okunur. Tek istekte teorik üst sınır yaklaşık "bant genişliği ÷ ağırlık boyutu"dur. Örneğin Qwen3 32B'nin 4-bit ağırlıkları hesaplayıcımıza göre 18,5 GB'tır; bu sınır RTX 5090'da saniyede yaklaşık 97 token, H100'de sürüme göre 108–181 token olur. Bunlar ölçüm değil üst sınırdır; iki kart arasındaki oran bant genişliği oranıyla aynıdır. H100'ün alt sürümlerinde fark küçüktür.
- Çok kullanıcılı servis: Eşzamanlı istekler birlikte işlendiğinde (batching) aynı ağırlık okumasıyla daha çok token üretilir. Bu durumda tensör gücü ve KV önbelleği için kalan bellek belirleyici olur. İki konuda da H100 belirgin şekilde öndedir: BF16'da 3,6–4,7 kat tensör gücü ve 2,5 kat bellek. Yoğun trafikli bir API için H100 (bellek gerekiyorsa H200) daha doğru seçimdir.
- FP4: RTX 5090'ın beşinci nesil tensör çekirdekleri FP4 ve FP6'yı donanımda destekler. NVIDIA'ya göre FP4, FP16'nın yarısından az bellek ister. RTX 5090'ın FP4 tensör gücü (1.676 TFLOPS) kağıt üzerinde H100'ün FP8 gücüyle (1.513–1.979 TFLOPS) aynı sınıftadır. H100'ün özelliklerinde FP4 yer almaz; 4-bit ağırlıklı modeller (AWQ, GPTQ, gpt-oss'un MXFP4 biçimi) H100'de de çalışır, ama 4-bit hesabı hızlandıran donanımdan yararlanamaz.
- İnce ayar ve eğitim: Hesaplayıcıya göre (2.048 token, batch 1, gradient checkpointing açık) Llama 3.1 8B LoRA 19,9 GB ve Qwen3 32B QLoRA 25,1 GB ile tek RTX 5090'a sığar. Qwen3 32B LoRA (72,2 GB) ve Llama 3.3 70B QLoRA (50,5 GB) tek bir H100 ister. Tam ince ayar çok daha fazla bellek ister: Llama 3.1 8B için 131,6 GB, yani 2 H100 ya da 8 RTX 5090. Eğitimde BF16 ve FP8 tensör gücü ile kartlar arası bağlantı belirleyici olduğu için burada H100 belirgin şekilde öndedir. Ayrıntılar LLM eğitimi için GPU seçimi rehberimizde.
Birden fazla RTX 5090, bir H100'ün yerini tutar mı?
Bellek açısından kısmen: dört RTX 5090 toplam 128 GB eder ve Llama 3.3 70B'yi FP8'de çalıştırabilir. Ama RTX 5090'da NVLink yoktur; kartlar PCIe 5.0 üzerinden haberleşir. NVIDIA, H100'ün PCIe 5.0 bağlantısını 128 GB/s, NVLink bağlantısını sürüme göre 600–900 GB/s olarak verir; NVLink 4,7–7 kat daha geniş bir yoldur. vLLM belgeleri de NVLink'i olmayan GPU'larda daha yüksek verim ve daha az iletişim yükü için tensör paralellik yerine pipeline paralellik kullanılmasını önerir.
- Birbirinden bağımsız işler (her kartta ayrı bir model, ayrı deneyler) için birden fazla RTX 5090 iyi bir seçenektir.
- Tek bir büyük modeli kartlara bölmek gerekiyorsa daha az sayıda büyük kart daha basittir: Llama 3.3 70B FP8, 4 RTX 5090 yerine 2 H100 ya da tek bir H200 ile çalışır.
- Çok GPU'lu eğitim (FSDP, tensör paralellik) GPU'lar arası iletişime dayanır; bu işler için NVLink destekleyen H100 uygundur.
Tek siparişte en fazla 8 GPU kiralayabilirsiniz. H100 NVLink'i destekler, ancak belirli bir NVLink topolojisini garanti etmiyoruz; çok GPU ihtiyacınızı sipariş formuna yazın. NVLink'in hangi işlerde fark yarattığını NVLink rehberimizde anlattık.
ECC, MIG, video ve güç: sunucu tarafında ne değişir?
- ECC bellek: RTX 5090'ın ürün sayfasında ECC yer almaz (üstteki teknik tabloda bu yüzden "Yok" yazar), ama NVIDIA'nın RTX Blackwell teknik incelemesine göre GDDR7 bellekte ECC bellek yongasına yerleşiktir, her zaman açıktır ve tek bitlik hataları düzeltir; NVIDIA yazılımında açma/kapama ayarı yoktur. H100'de ise NVIDIA'nın bellek hata yönetimi belgesine göre düzeltilemeyen bir bellek hatası çoğu durumda yalnızca o hatayla karşılaşan uygulamayı etkiler, bozulan bellek satırları yedek satırlarla değiştirilir (row remapping), hatalar sistem kayıtlarına (XID) düşer ve nvidia-smi ile izlenebilir. Günlerce süren eğitimlerde ve 7/24 servislerde bellek sağlığını izlemek ve hatadan sonra çalışmaya devam etmek önemliyse bu fark H100'ü öne çıkarır.
- MIG: H100 en fazla 7 yalıtılmış bölüme ayrılabilir; küçük servisleri ya da ekip içi ortamları aynı kartta ayrı ayrı çalıştırabilirsiniz. NVIDIA'nın MIG destekleyen GPU listesinde GeForce kartlar yer almaz.
- Video: RTX 5090'da 3 NVENC ve 2 NVDEC motoru vardır ve AV1 kodlar; GeForce kartlarda NVIDIA eşzamanlı kodlama oturumunu 12 ile sınırlar. H100'de donanım video kodlayıcısı yoktur, yalnızca video çözme için 7 NVDEC motoru vardır. Transcoding ve canlı yayın işleri için ikisi arasında doğru seçim RTX 5090'dır; ayrıntılar video işleme sayfamızda.
- Render: RTX 5090'da dördüncü nesil RT çekirdekleri vardır; H100'ün özelliklerinde RT çekirdeği yer almaz. 3D render işleri için RTX 5090 uygundur.
- Güç: RTX 5090 575 W'a kadar güç çeker. H100'ün güç sınırı sürüme göre değişir ve SXM sürümünde 700 W'a kadar çıkar.
Hangi iş için hangisi?
| İş | Önerimiz | Neden |
|---|---|---|
| 8B–24B modellerle FP8 inference | RTX 5090 | Tek karta sığar; 1.792 GB/s bant genişliği |
| 32B modeller 4-bit, gpt-oss-20b | RTX 5090 | 22,5 GB ve 13,5 GB ile tek karta sığar |
| Görüntü üretimi (SDXL, FLUX.1 [dev]) | RTX 5090 | FP4 desteği; NVIDIA'ya göre FLUX.1 [dev] FP4'te 10 GB'ın altına iner |
| Video kodlama, transcoding | RTX 5090 | H100'de NVENC yok |
| LoRA (8B), QLoRA (32B'ye kadar) | RTX 5090 | 19,9 GB ve 25,1 GB ile tek karta sığar |
| 32B BF16, 70B 4-bit, gpt-oss-120b | H100 | Tek H100'e sığar; RTX 5090'da 2–4 kart gerekir |
| Llama 3.3 70B FP8 | 2 H100 ya da 1 H200 | 77,8 GB bellek ister |
| Çok kullanıcılı, uzun bağlamlı LLM servisi | H100 ya da H200 | KV önbelleği için bellek ve tensör gücü |
| Tam ince ayar, çok GPU'lu eğitim | H100 | BF16/FP8 tensör gücü ve NVLink desteği |
| Bellek hatalarının izlenmesi gereken uzun işler, MIG ile bölme | H100 | ECC hata kaydı, bozuk satırların yeniden eşlenmesi ve 7 bölüme kadar MIG |
| FP64 bilimsel hesaplama | H100 | RTX 5090'da FP64, FP32'nin 1/64'ü |
H200 mü, RTX 5090 mı?
H200, H100 ile aynı Hopper hesap birimlerini kullanır; farkı 141 GB HBM3e bellek ve 4,8 TB/s bant genişliğidir. Bu, RTX 5090'ın 4,4 katı bellek ve 2,7 katı bant genişliği demektir. Llama 3.3 70B FP8 (77,8 GB) tek bir H200'e sığarken RTX 5090'da 4 kart gerekir. Modeliniz 32 GB'a sığıyor ve trafiğiniz düşükse H200'ün ek belleği çoğunlukla boşta kalır; H200 bant genişliği sayesinde token hızında önde olsa da bütçe öncelikliyse RTX 5090 yeterlidir. 70B ve üzeri modeller, uzun bağlam ve yoğun trafik için H200 doğru seçimdir. Bizde H200 aylık $3.000; H100 ile farkı için H100 ve H200 karşılaştırmamıza bakın.
A100 mü, RTX 5090 mı?
A100'ü kiralamıyoruz, ama sık sorulduğu için kısaca: A100 80 GB, RTX 5090'ın 2,5 katı belleğe (80 GB HBM2e) ve benzer bant genişliğine (sürüme göre 1.935–2.039 GB/s) sahiptir; NVLink (600 GB/s) ve 7 bölüme kadar MIG sunar. Buna karşılık Ampere mimarisinde FP8 ve FP4 tensör desteği yoktur; RTX 5090 ikisini de destekler. Seyrekliksiz BF16 tensör gücü A100'de 312, RTX 5090'da 209,5 TFLOPS'tur. Kısacası 32 GB'a sığan işlerde RTX 5090, 80 GB gereken işlerde H100 daha güncel seçimdir. Ayrıntılar H100 ve A100 karşılaştırmamızda.
Kiralama koşulları ve fiyat
- Kiralama aylıktır ve en az 1 aydır; saat başına ücretlendirme yoktur. Aylık fiyatın saatlik karşılığı (aylık fiyat ÷ 730) RTX 5090 için yaklaşık $0,82, H100 için yaklaşık $3,42.
- Fiyatlar GPU başına, ABD doları cinsinden ve KDV hariçtir. Fatura, düzenlendiği günkü TCMB döviz satış kuruyla Türk lirası olarak kesilir. Yıllık kiralamada %20 indirim uygulanır.
- GPU'lar ve sunucu kaynakları yalnızca size ayrılır; paylaşımlı bir VPS ya da hosting değildir. Tek siparişte en fazla 8 GPU kiralayabilirsiniz.
- Sunucular İstanbul Bağcılar'daki kendi tesisimizde çalışır; verileriniz Türkiye'de kalır.
RTX 5090'ı daha üst bir Blackwell kartıyla karşılaştırmak isterseniz RTX 5090 ve RTX PRO 6000 karşılaştırmamıza, H100'ün 96 GB'lık alternatifi için RTX PRO 6000 ve H100 karşılaştırmamıza bakın.
Özet
- RTX 5090 ve H100 farklı sınıfların kartlarıdır: 32 GB GDDR7 bellekli bir Blackwell GeForce kartına karşı 80 GB HBM bellekli bir Hopper veri merkezi GPU'su.
- Tek RTX 5090'a FP8'de yaklaşık 24B'ye, 4-bit'te 32B'ye kadar modeller sığar; tek H100'e BF16'da 32B, 4-bit'te 70B sınıfı modeller ve gpt-oss-120b sığar.
- H100'ün bant genişliği sürüme göre 1,1–1,9 kat, BF16 tensör gücü 3,6–4,7 kat yüksektir; NVLink, MIG ve sunucu sınıfı bellek hata yönetimi de H100'dedir.
- RTX 5090; FP4 tensör desteği, donanım video kodlayıcısı, RT çekirdekleri ve çok daha düşük aylık fiyatıyla 32 GB'a sığan işlerde öndedir.
- 70B FP8 ve üzeri için H200 (141 GB) daha uygundur. A100'ün yerine işin belleğine göre RTX 5090 ya da H100'e bakın.
Kaynaklar
- NVIDIA GeForce RTX 5090
- NVIDIA RTX Blackwell GPU Architecture (teknik inceleme, PDF)
- NVIDIA H100
- Lenovo Press: ThinkSystem NVIDIA H100 PCIe ve H100 NVL
- NVIDIA H200
- NVIDIA A100
- NVIDIA: Video Encode and Decode GPU Support Matrix
- NVIDIA MIG User Guide: desteklenen GPU'lar
- NVIDIA GPU Memory Error Management: hata sınırlama, row remapping ve XID kayıtları
- NVIDIA Transformer Engine: veri tipi ve donanım destek tablosu
- NVIDIA Blog: GeForce RTX 50 serisinde FP4 ve FLUX.1 [dev] bellek ihtiyacı
- NVIDIA Technical Blog: Mastering LLM Techniques: Inference Optimization
- vLLM: Parallelism and Scaling
- OpenAI gpt-oss-120b model kartı (Hugging Face)
- NVIDIA: CUDA Toolkit 12.8 ve Blackwell desteği
- NVIDIA: CUDA GPU'ları ve hesaplama yetenekleri
Sık sorulan sorular
RTX 5090 ile 70B bir model çalıştırılabilir mi?
4-bit ve üzeri hassasiyette tek karta sığmaz. VRAM hesaplayıcımıza göre Llama 3.3 70B, 8.192 token bağlamla 4-bit'te 45,4 GB, FP8'de 77,8 GB ister; bu da 2 ya da 4 RTX 5090 demektir. Aynı modelin 4-bit sürümü tek bir H100'e, FP8 sürümü tek bir H200'e sığar.
FP4 nedir, H100'de kullanılabilir mi?
FP4, 4 bitlik kayan noktalı sayı biçimidir; NVIDIA'ya göre FP16'nın yarısından az bellek ister. RTX 5090'ın beşinci nesil tensör çekirdekleri FP4'ü donanımda hesaplar, H100'ün özelliklerinde ise FP4 yer almaz. 4-bit ağırlıklı modeller H100'de de çalışır, ancak 4-bit hesabı hızlandıran donanım desteğinden yararlanamaz.
H100 video kodlama için kullanılabilir mi?
Donanım kodlayıcısı olmadığı için uygun değildir: NVIDIA'nın destek tablosunda H100'ün NVENC sayısı sıfırdır. Video çözme için 7 NVDEC motoru vardır. Kodlama gerekiyorsa 3 NVENC motorlu RTX 5090 uygundur; GeForce kartlarda eşzamanlı kodlama oturumu sayısı 12 ile sınırlıdır.
RTX 5090'dan H100'e geçerken kodumu değiştirmem gerekir mi?
Genellikle hayır; ikisi de CUDA ile çalışır. RTX 5090 Blackwell mimarisinde (hesaplama yeteneği 12.0) olduğu için CUDA 12.8 ve sonrası gerekir; NVIDIA, CUDA 12.8'i Blackwell'i destekleyen ilk sürüm olarak duyurdu. FP4 gibi Blackwell'e özgü özellikler kullanıyorsanız H100'de FP8 ya da BF16'ya dönmeniz gerekir.
RTX 5090'ın belleğinde ECC var mı?
RTX 5090'ın ürün sayfasında ECC yer almaz, ama bellek yongasının içinde yerleşik bir ECC vardır. NVIDIA'nın RTX Blackwell teknik incelemesine göre bu ECC GDDR7 yongasına yerleşiktir, her zaman açıktır ve tek bitlik hataları düzeltir; NVIDIA yazılımında açma/kapama ayarı yoktur. H100'de ise düzeltilemeyen bir bellek hatası çoğu durumda yalnızca o uygulamayı etkiler, bozulan bellek satırları yedek satırlarla değiştirilir ve hatalar sistem kayıtlarında izlenebilir. Günlerce süren eğitimlerde ve 7/24 servislerde bu izleme ve kurtarma özellikleri H100'ü öne çıkarır.
RTX 5090 ve H100 saat başına ücretlendirilir mi?
Hayır. Kiralama aylıktır ve en az 1 aydır. Aylık fiyatın saatlik karşılığı RTX 5090 için yaklaşık $0,82, H100 için yaklaşık $3,42. Yıllık kiralamada %20 indirim uygulanır.
Kiralamak için
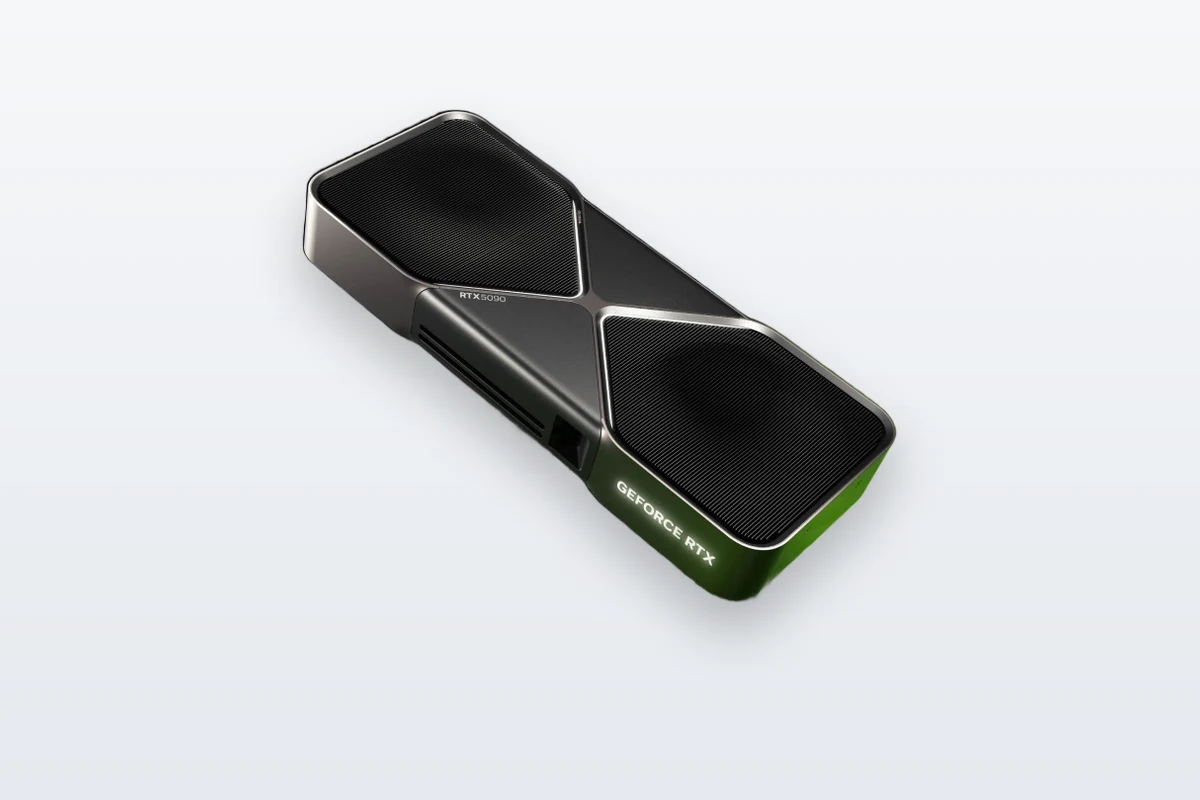
RTX 5090
Blackwell
32 GB
Paylaşımsız · VPS değil
32 GB GDDR7 ve 1,8 TB/s bant genişliği: 32 GB'a sığan LLM'ler, FLUX ve render için hızlı Blackwell kartı.
$600 / ay
GPU başına, KDV hariç · saatlik karşılığı $0,82
Yıllık toplam $5.760
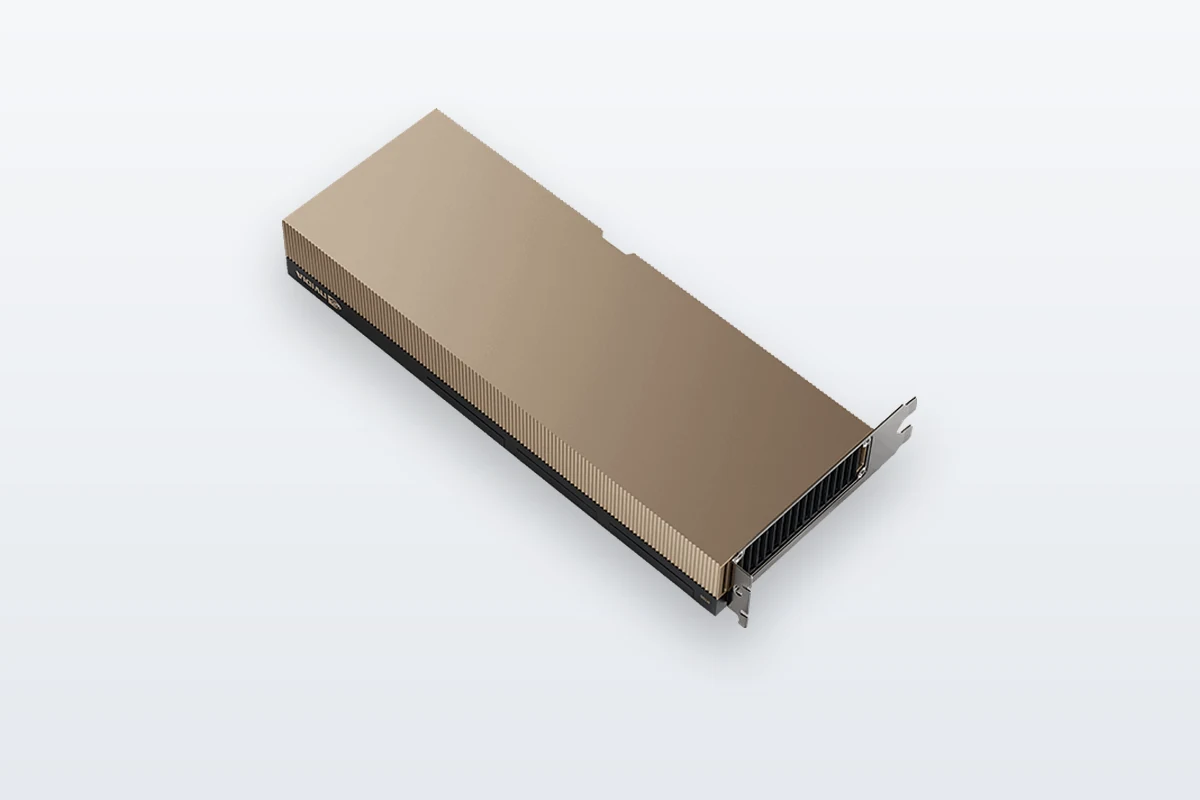
H100
Hopper
80 GB
Paylaşımsız · VPS değil
80 GB HBM bellek ve FP8 destekli Transformer Engine ile büyük model eğitimi ve yoğun LLM inference için.
$2.500 / ay
GPU başına, KDV hariç · saatlik karşılığı $3,42
Global bulut medyanından %10 düşük (getdeploying.com, 23 Ekim 2026)
Yıllık toplam $24.000